
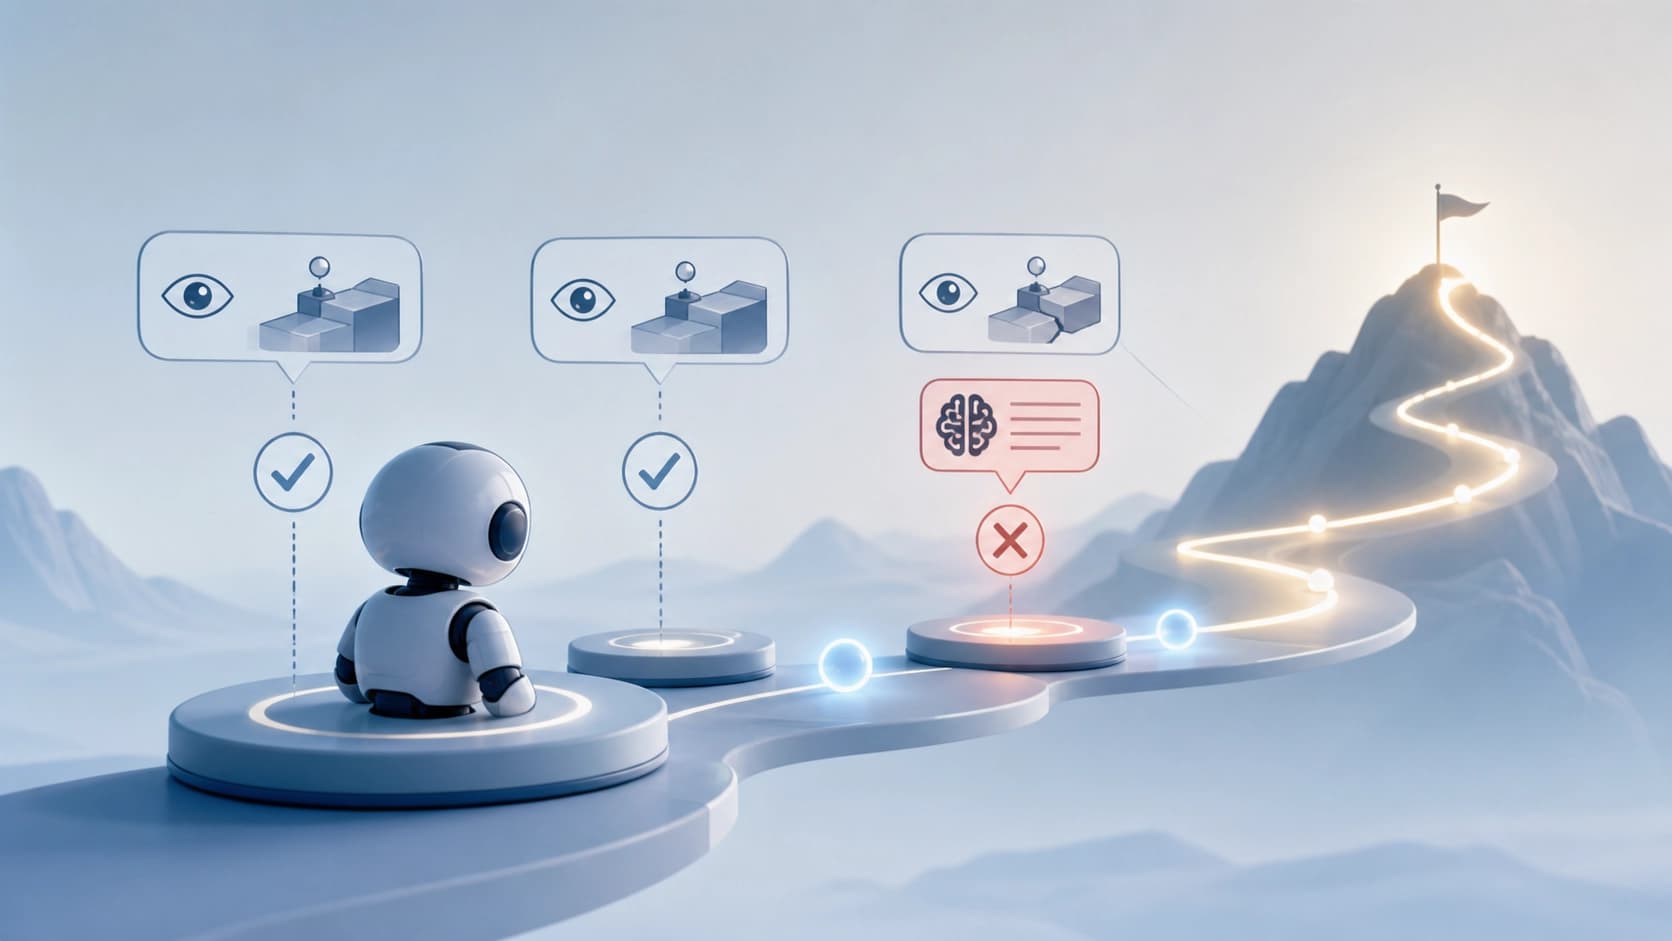
Problema: una sola recompensa para toda la trayectoria
Los agentes multi-paso basados en LLM aprenden por ensayo y error: ejecutan una cadena de acciones, reciben una evaluación final y ajustan su comportamiento a partir de ella. El problema es que esa evaluación suele llegar para toda la trayectoria en conjunto. El agente se entera de que la tarea se resolvió o fracasó, pero no de en qué paso exactamente empezó a ir mal.
A partir de ahí empieza una aritmética que se lleva mal con el sentido común. La misma ventaja se reparte por todos los pasos seguidos — tanto por la elección acertada de una herramienta como por un error tipográfico casual en la consulta o por el rutinario «confirmar acción». Al final, el modelo premia a la vez los fallos casuales y los pasos de trabajo normales, si el desenlace resultó exitoso. El crédito por el éxito les toca a todos por igual, y la culpa por el fracaso, también.
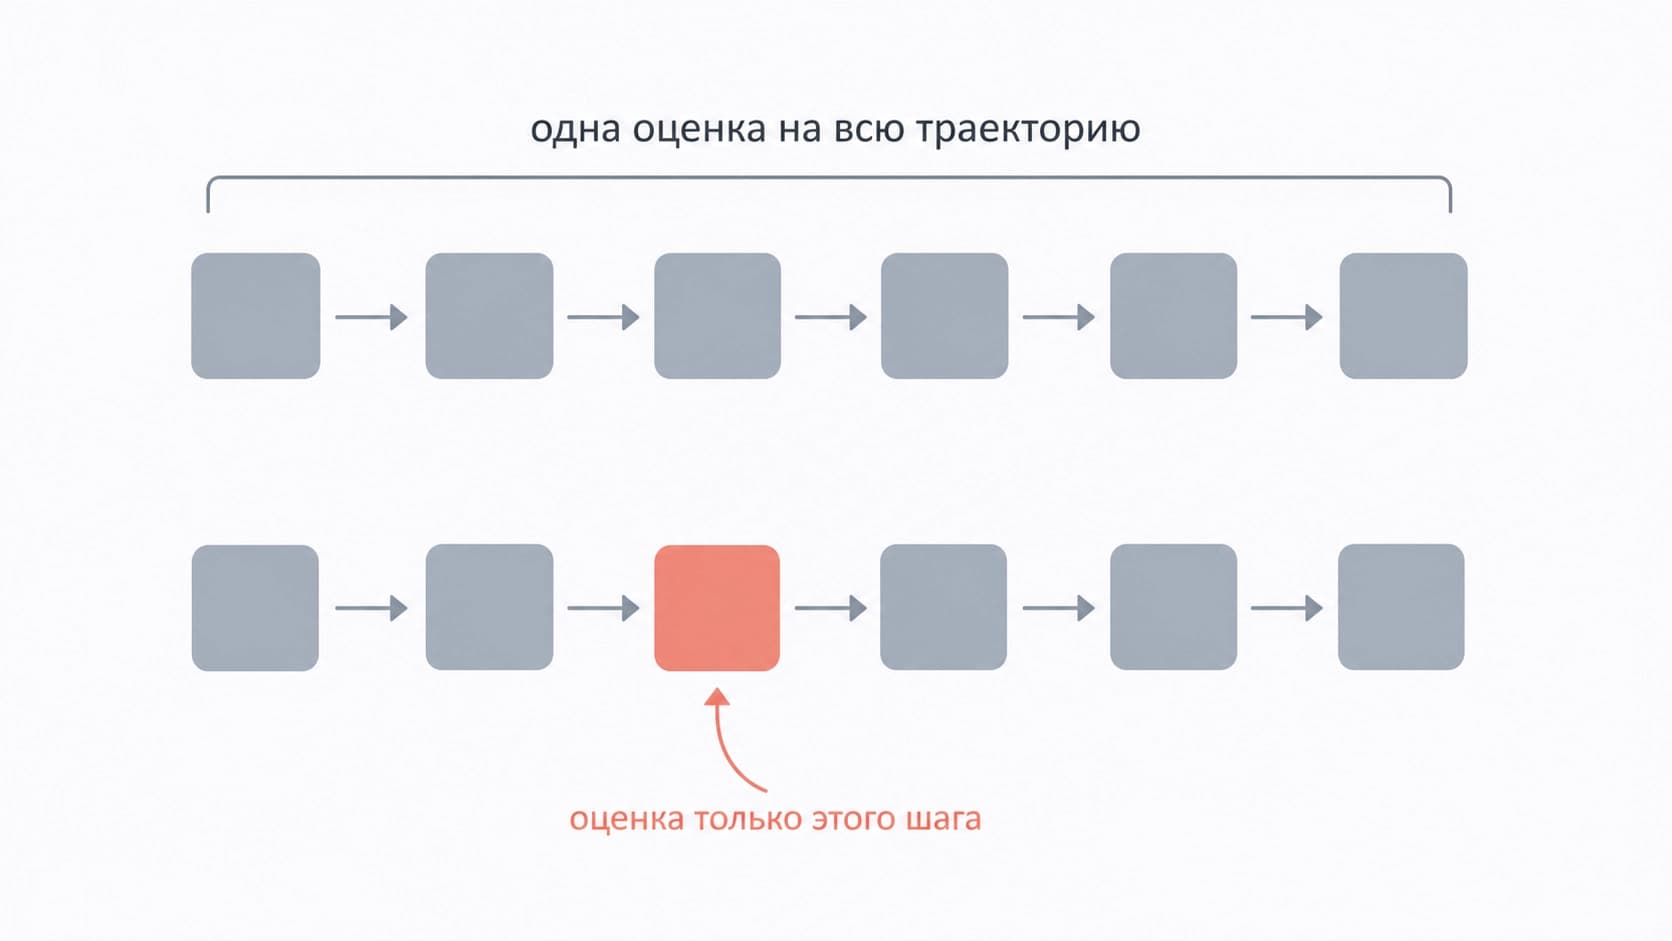
El remedio clásico es la autodestilación con información privilegiada. El maestro sabe más que el alumno: tiene acceso al entorno, a las señales intermedias, a la respuesta correcta. Puede dar indicaciones en cada paso, no solo al final. Suena bien, pero este enfoque tiene un descuido oculto: la misma indicación se emite para todos los pasos sin distinción.
Asimetría de los pasos: la rutina y los errores necesitan cosas distintas
La idea clave del trabajo AHEAD es que los pasos de una trayectoria no son equivalentes, y la supervisión para ellos también debe ser distinta.
- Pasos rutinarios — abrir una página, confirmar una transición, invocar la herramienta adecuada — casi no necesitan indicaciones. El modelo se apaña solo. La guía de más aquí solo añade ruido al entrenamiento y consume presupuesto.
- Pasos críticos con error — donde el agente se desvió y perdió la oportunidad de tener éxito — requieren no solo constatar «aquí está mal», sino una dirección concreta: qué debería haber hecho en su lugar.
- La retroalimentación del entorno ancla bien lo que ocurre: dice qué pasó realmente. Pero no sabe explicar cómo debería haberse actuado. La señal «la puerta no se abrió» no indica dónde estaba la llave.
Resulta que las dos fuentes de supervisión se complementan, pero no se sustituyen. El feedback del entorno da una señal densa y honesta en cada paso; las indicaciones correctivas generadas por el modelo dan lo que en el feedback del entorno no existe por principio: la intención y la alternativa. Mezclarlas a ciegas por toda la trayectoria significa perder las fortalezas de ambas.
Cómo está construido AHEAD
Los autores — Xiaolong Jin, Dingmin Wang, Vijay Lingam y Varun Kumar — proponen un framework que reconoce el tipo de paso y elige para él la fuente de supervisión correspondiente. El trabajo se publicó en arXiv a finales de agosto de 2026, en la categoría cs.AI; tiene 22 páginas, 15 figuras y 7 tablas, así que material para el detalle no falta.
Un maestro que ve el entorno
El modelo maestro recibe la retroalimentación del entorno en todos los pasos — es una señal anclada y densa, igual de disponible tanto en los tramos exitosos como en los fallidos. Un maestro así no fantasea: se apoya en lo que realmente ocurrió en el entorno.
Indicaciones correctivas — de forma puntual
Por encima de esto, el maestro recibe indicaciones generadas por el LLM, pero no en todos los pasos, sino precisamente en los erróneos. La lógica es simple: donde el agente se equivocó, el dato del entorno por sí solo no basta, hace falta una explicación de hacia dónde convenía moverse. Donde todo va sobre ruedas, no se añade guía adicional en absoluto.
Esto es justamente la «indicación puntual» del título: no repartida por toda la trayectoria, sino enfocada en los puntos problemáticos. Un emparejamiento consciente del tipo de paso entre las fuentes de supervisión, en lugar de una señal única para toda la cadena de acciones.
Cambios mínimos sobre GRPO
Merece mención aparte la modestia ingenieril del método. GRPO — un algoritmo popular de aprendizaje por refuerzo — no se reescribe desde cero: los cambios se introducen de forma puntual, sobre el esquema estándar. Para los profesionales esto es importante, porque no exige rearmar todo el pipeline de entrenamiento del agente.
Qué mostraron los experimentos
La evaluación se hizo en tres tipos de tareas: ALFWorld — escenarios multi-paso en un entorno de texto, WebShop — interacción con una tienda en línea, y preguntas y respuestas de búsqueda. Se probaron tres escalas de modelos, así que las conclusiones no están atadas a un solo tamaño.
Resultados en comparación con el GRPO habitual:
- +13,3 puntos de éxito en ALFWorld con un modelo de 7B;
- +11,0 puntos en WebShop con la misma escala.
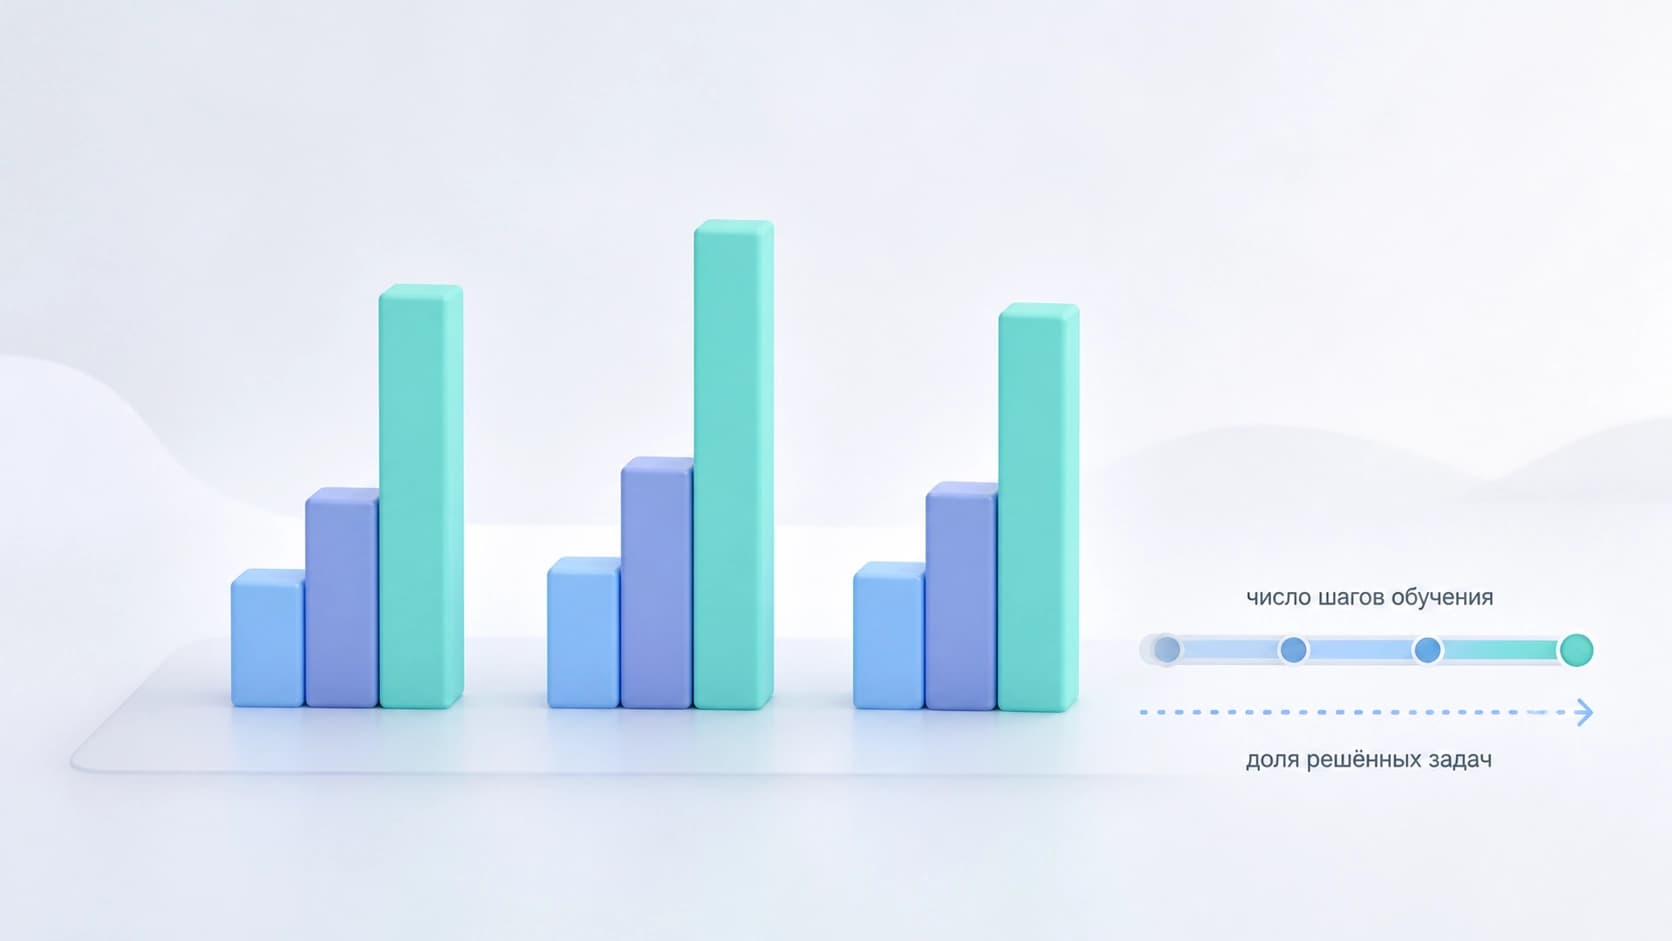
Además de las cifras absolutas, hay dos efectos no menos interesantes. Primero, el nivel de éxito dado se alcanza con menos pasos de entrenamiento — es decir, el método no solo es mejor en el límite, sino que llega antes a un estado operativo. Segundo, el agente resuelve las tareas con presupuestos de interacción más ajustados que los enfoques basados solo en la recompensa final y que los métodos previos de autodestilación.
El segundo punto, en mi opinión, está subestimado. El ahorro de pasos de interacción no es solo una métrica de belleza. En escenarios reales, cada llamada a una herramienta cuesta dinero, tiempo y riesgo. Un agente que llega a la meta en cinco acciones en lugar de diez es más útil no un 13 por ciento, sino varias veces — sobre todo donde el coste del error es alto.
Por qué funciona y qué queda fuera de plano
La explicación del método es casi pedagógica. Un buen maestro no comenta cada movimiento del alumno — calla mientras este hace cosas razonables e interviene justo donde el alumno se desvió del camino. Si se comenta todo sin parar, el alumno deja de pensar por sí mismo y empieza a esperar indicaciones. Si no se comenta nada, repetirá los mismos errores una y otra vez.
AHEAD formaliza esta intuición en términos de aprendizaje por refuerzo: distinto tipo de paso — distinta fuente de señal. Feedback denso y anclado — como fondo; dirección correctiva — como acento. Ninguna magia, solo el rechazo de la idea de que todos los pasos son iguales.
Qué queda como preguntas. La generación de indicaciones correctivas requiere en sí misma un modelo, y por tanto añade coste computacional y depende de su calidad — si el maestro explica mal, el alumno recibirá una dirección segura pero incorrecta. También queda abierto hasta qué punto el método se traslada a tareas donde el coste de un paso intermedio no es tan obvio como en ALFWorld o WebShop, y donde la «erroneidad» de un paso no siempre puede determinarse de inmediato, sino solo por sus consecuencias diferidas.
Aun así, la dirección parece sana. La línea principal de desarrollo de los métodos agénticos de los últimos años no es agrandar el modelo, sino administrar con más inteligencia la señal de entrenamiento. AHEAD es exactamente de esa línea: intervención puntual en lugar de control total.


