
Por qué la votación por confianza funcionaba en primer lugar
La idea, familiar para cualquiera que haya construido pipelines en torno a grandes modelos de lenguaje, es simple: ejecutar la misma tarea varias veces en paralelo y luego elegir la respuesta por mayoría. Pero no por una mayoría "plana", sino ponderada: cada ejecución recibe un peso según las señales internas del modelo, casi siempre según las log-probabilidades de los tokens. La variante en la que el modelo estaba más seguro suena más fuerte que las demás.
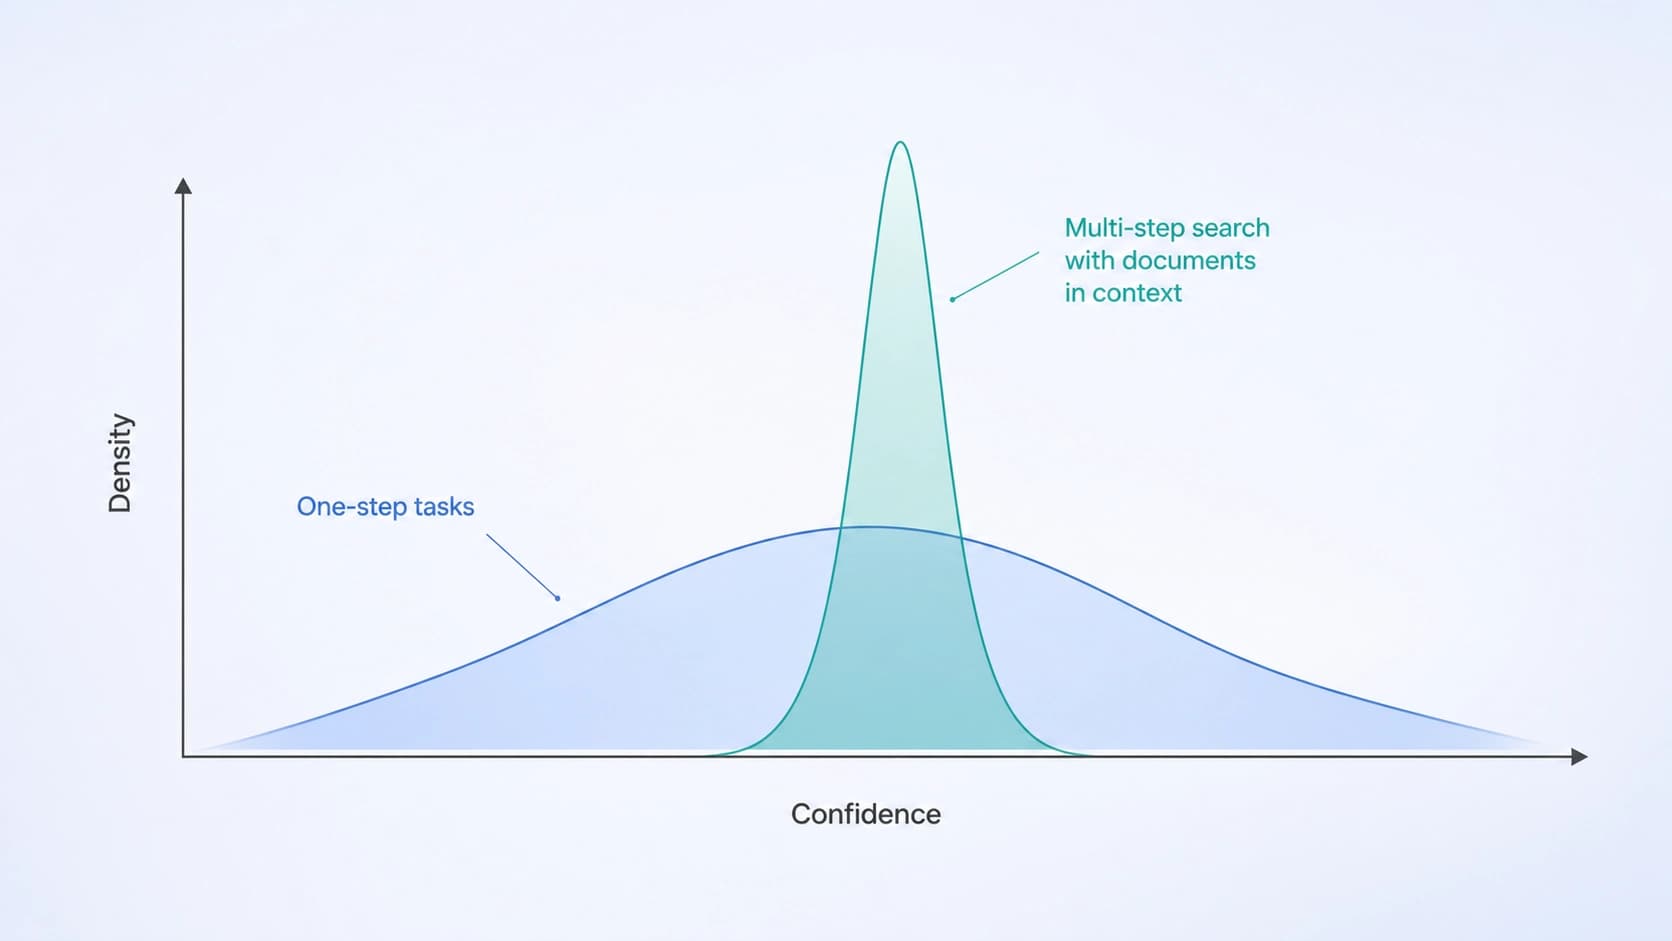
Para razonamientos de un solo paso, este esquema funciona bastante bien: si el modelo se equivoca, suele dudar, y la respuesta correcta viene acompañada de alta confianza. La brecha en las log-probabilidades se convierte en algo así como un detector de errores incorporado, que no requiere llamadas adicionales, ni anotaciones, ni un modelo juez aparte.
Se rompe justo donde empezó: en la búsqueda de múltiples pasos
El problema es que los agentes modernos funcionan de otra manera. No se limitan a razonar en una sola pasada: formulan consultas, obtienen documentos externos, los incorporan al contexto, refinan la consulta y así varias veces, hasta reunir suficiente material para la respuesta final. Cada paso añade fragmentos de texto ajeno a la ventana del modelo.
Los autores del trabajo «Beyond Confidence: Test-Time Scaling for Multi-Turn Search Agents via Retrieval Grounding» (arXiv:2608.24024, aceptado en Findings de la conferencia EMNLP 2026) — Hyunho Kook, Junhyuk So, Tianyu Fu, Haizhong Zheng y Beidi Chen — comprobaron qué ocurre con la votación por confianza en este escenario. El resultado es desagradable: la técnica, depurada en tareas de un solo paso, se traslada mal a los agentes de búsqueda.
Mecanismo de fallo: copy inflation
Los investigadores llamaron a la causa copy inflation — "inflación por copia". Cuando los documentos recuperados entran en el contexto, los tokens que el modelo traslada de esos documentos a su respuesta reciben log-probabilidades sistemáticamente infladas. Copiar es una operación fácil: continuar un texto que está justo delante de los ojos es estadísticamente más sencillo que generar algo propio. El modelo está "seguro" de ese token no porque sea correcto, sino porque está literalmente copiado.
Después, el efecto se acumula. Como todas las ejecuciones se apoyan de una u otra forma en los documentos encontrados, todas reciben su ración de probabilidades infladas. Las estimaciones de confianza dentro de una misma pregunta se igualan, se comprimen en un rango estrecho, y la votación ponderada pierde lo principal por lo que existía: la capacidad de distinguir una ejecución fuerte de una débil. Los pesos se vuelven casi idénticos y la agregación degenera en una mayoría simple, solo que con una carga computacional extra.
Qué proponen: Retrieval-Grounded Voting
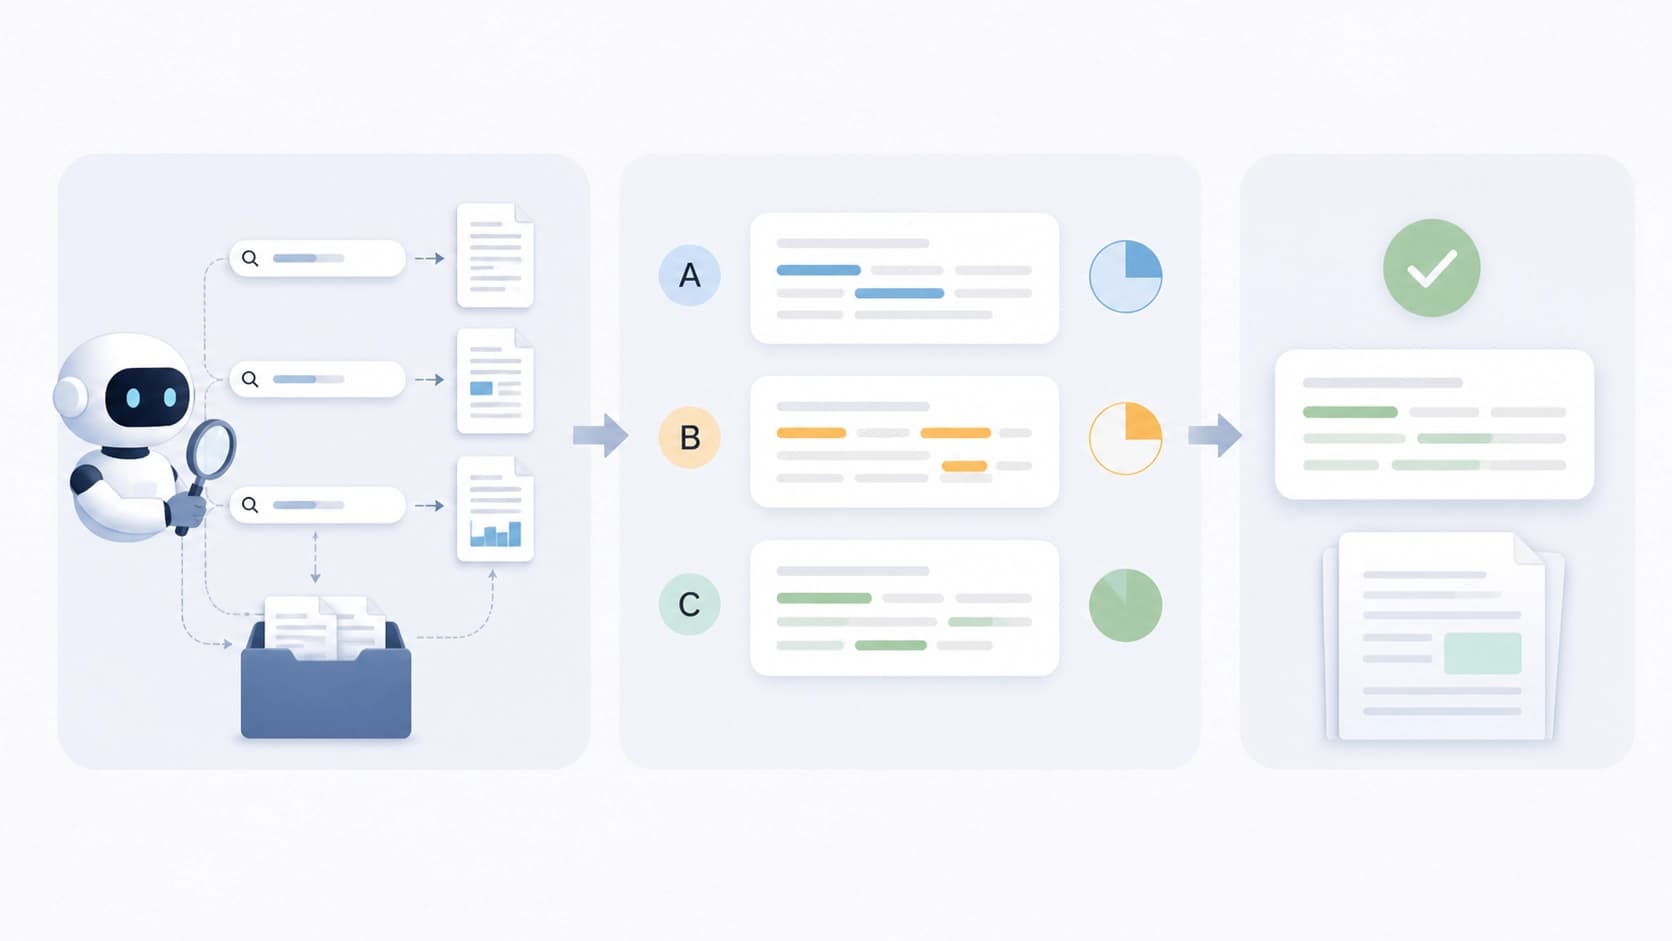
Como reemplazo, los autores proponen el método Retrieval-Grounded Voting (RGV). También evalúa cada ejecución por separado, pero no mira hacia dentro del modelo, sino hacia fuera: hacia la relación entre la respuesta final y los documentos que esa misma ejecución recuperó.
La métrica es deliberadamente simple: la intersección léxica entre el texto de la respuesta y el texto de las fuentes recuperadas. Cuanto más se apoya la respuesta en el material encontrado, mayor es su puntuación. La ejecución que se inventó algo por su cuenta o se desvió comparte menos palabras con sus documentos y recibe un peso menor.
Por qué funciona la señal
La lógica es la siguiente: si el agente realmente encontró páginas relevantes y construyó su conclusión sobre ellas, las formulaciones de la respuesta inevitablemente se cruzarán con las formulaciones de las fuentes: términos, nombres, giros. No es un indicio perfecto de corrección, pero es robusto allí donde las log-probabilidades ya están corrompidas.
La ventaja clave de RGV es que calcula la señal fuera del contexto contaminado. La evaluación se construye sobre el par "respuesta — documentos", no sobre el estado del modelo en el momento de la generación, por lo que copy inflation no la afecta. De paso, el método prescinde del acceso a las log-probabilidades de los tokens y de llamadas adicionales al LLM: ningún modelo juez, ninguna segunda pasada, solo el conteo de intersecciones, una operación que se puede hacer con código común casi gratis.
Resultados
Los experimentos se realizaron con cuatro benchmarks para agentes de búsqueda y cinco modelos de lenguaje distintos. El panorama se repite: RGV supera de forma estable a la votación por confianza.
La medición más reveladora es en las preguntas "minority-correct", donde la respuesta correcta aparece solo en una o dos ejecuciones de ocho. Es precisamente aquí donde la ponderación por confianza fracasa con más fuerza: las probabilidades infladas arrastran la votación hacia la versión mayoritaria pero incorrecta. El incremento de RGV en esas preguntas alcanza el +35%, y en precisión general, hasta el +5.4%.
Las cifras deben leerse con una salvedad: no es "un cinco por ciento más de calidad para cualquier sistema de búsqueda", sino una mejora del procedimiento de agregación con el modelo y el conjunto de ejecuciones fijos. Es decir, el método no cambia nada en el propio agente: solo elige con más cuidado entre lo que el agente ya generó.
Qué significa esto en la práctica
Si estás construyendo un agente de múltiples pasos y ya usas self-consistency o cualquier votación por probabilidades, RGV tiene tres ventajas prácticas:
- No cuesta nada en inferencia. No se necesitan llamadas adicionales al modelo; el peso se calcula a posteriori sobre respuestas y documentos ya listos.
- Funciona con modelos cerrados. Las log-probabilidades de los tokens no siempre están disponibles y a veces quedan totalmente ocultas tras la API. La comparación de textos está libre de esta limitación.
- Se depura de forma predecible. La métrica es transparente: se puede ver qué palabras dieron coincidencia y entender por qué la ejecución recibió ese peso.
Dónde puede tropezar el método
El punto débil es evidente desde la propia construcción: la intersección léxica premia la coincidencia de palabras, no la coincidencia de significado. Una respuesta reformulada pero correcta recibirá un peso injustamente bajo; un resultado numérico o un resumen breve tampoco se cruzarán apenas con el texto original, aunque le correspondan por completo. La situación inversa es aún más desagradable: una ejecución que simplemente cita largamente lo encontrado obtendrá una puntuación alta sin haber aportado nada a la solución.
De ahí la estrategia razonable: percibir RGV no como un reemplazo de todas las señales, sino como un voto adicional, especialmente útil justo allí donde la confianza del modelo deja de significar algo. También es lógico combinarlo con verificaciones de otros tipos: comparación de significados, evaluación por un modelo aparte, verificación por hechos. Los autores, a juzgar por el planteamiento del problema, avanzaban exactamente en esa dirección: de "confiar en la sensación interna del modelo" a "evaluar lo que realmente hizo".
Conclusión
La historia del copy inflation es una buena ilustración de un problema general de los pipelines agénticos: las técnicas depuradas de forma aislada con un solo modelo y un solo paso de razonamiento se desmoronan silenciosamente cuando al ciclo se añaden búsqueda, contexto y textos ajenos. La confianza del modelo deja de ser una medida de corrección y se convierte en una medida de facilidad de copia.
RGV propone un camino alternativo que parece casi aburrido: contar la intersección de palabras entre la respuesta y las fuentes. Pero es precisamente esa monotonía lo que hace atractivo al método: es barato, transparente, no requiere las entrañas del modelo y ofrece una ganancia notable allí donde la respuesta correcta se ahoga en el ruido. Para los equipos que construyen agentes de búsqueda a partir de API ya hechas, es un caso raro de mejora útil que no exige ni reentrenamiento ni nuevos presupuestos de inferencia.


