De la publicación al repositorio: dónde se rompe la cadena
Una publicación científica no es un manual de montaje. Incluso un texto detallado con fórmulas y gráficos no contiene todo lo necesario para ejecutar el código y obtener los mismos números. Precisamente esa brecha es la que investiga el trabajo titulado ReproAgent: Contract-Guided Paper-to-Code Reproduction, que formaliza la tarea de paper-to-code reproduction: un agente científico de IA debe convertir un artículo en un repositorio ejecutable en el que se conserven el método, el protocolo experimental y los artefactos.
La causa de la dificultad, según los autores, no está en la "debilidad" de los modelos, sino en la fragmentación de la especificación. La parte explícita —algoritmos, métricas, composición de los artefactos— sí está presente en el artículo, pero en trayectorias largas del agente esos detalles se van perdiendo, se diluyen del contexto de trabajo. La parte implícita —los valores por defecto de los frameworks, las convenciones heredadas de trabajos afines— no se menciona en absoluto en el texto: para los autores del artículo es tan obvio que no requiere palabras. Esos detalles no se pueden reconstruir "por consideraciones generales", y sin ellos el código o no se ejecuta o arroja resultados distintos.
Datos formales del preprint: arXiv:2608.24291, categoría principal — cs.AI, adicionalmente se indica cs.SE; enviado el 25 de agosto de 2026. Autores — Xue Hu, Zewei Pan, Zhongyuan Wang, Zhou Liu, Zeli Su y Wentao Zhang, remitente — Xue Hu. El trabajo fue aceptado en Findings of EMNLP 2026, DOI: 10.48550/arXiv.2608.24291.
El contrato de implementación como ancla para el agente
La idea principal de ReproAgent no es dejar que el agente "simplemente lea el artículo y escriba código". En su lugar, se construye un contrato de implementación (implementation contract) permanente: un artefacto que vive a lo largo de todo el trabajo y sobrevive a trayectorias largas, a diferencia del texto original en el contexto.
El contrato se nutre de dos canales independientes:
- canal de requisitos (implementation-requirement) — convierte fragmentos del artículo en obligaciones concretas sobre el código: qué debe implementarse exactamente, qué métricas calcular, qué datos cargar;
- canal de evidencias (reference-evidence) — extrae pistas de contenido y estructurales de repositorios relacionados, es decir, recupera esas mismas convenciones implícitas que no están en el texto.
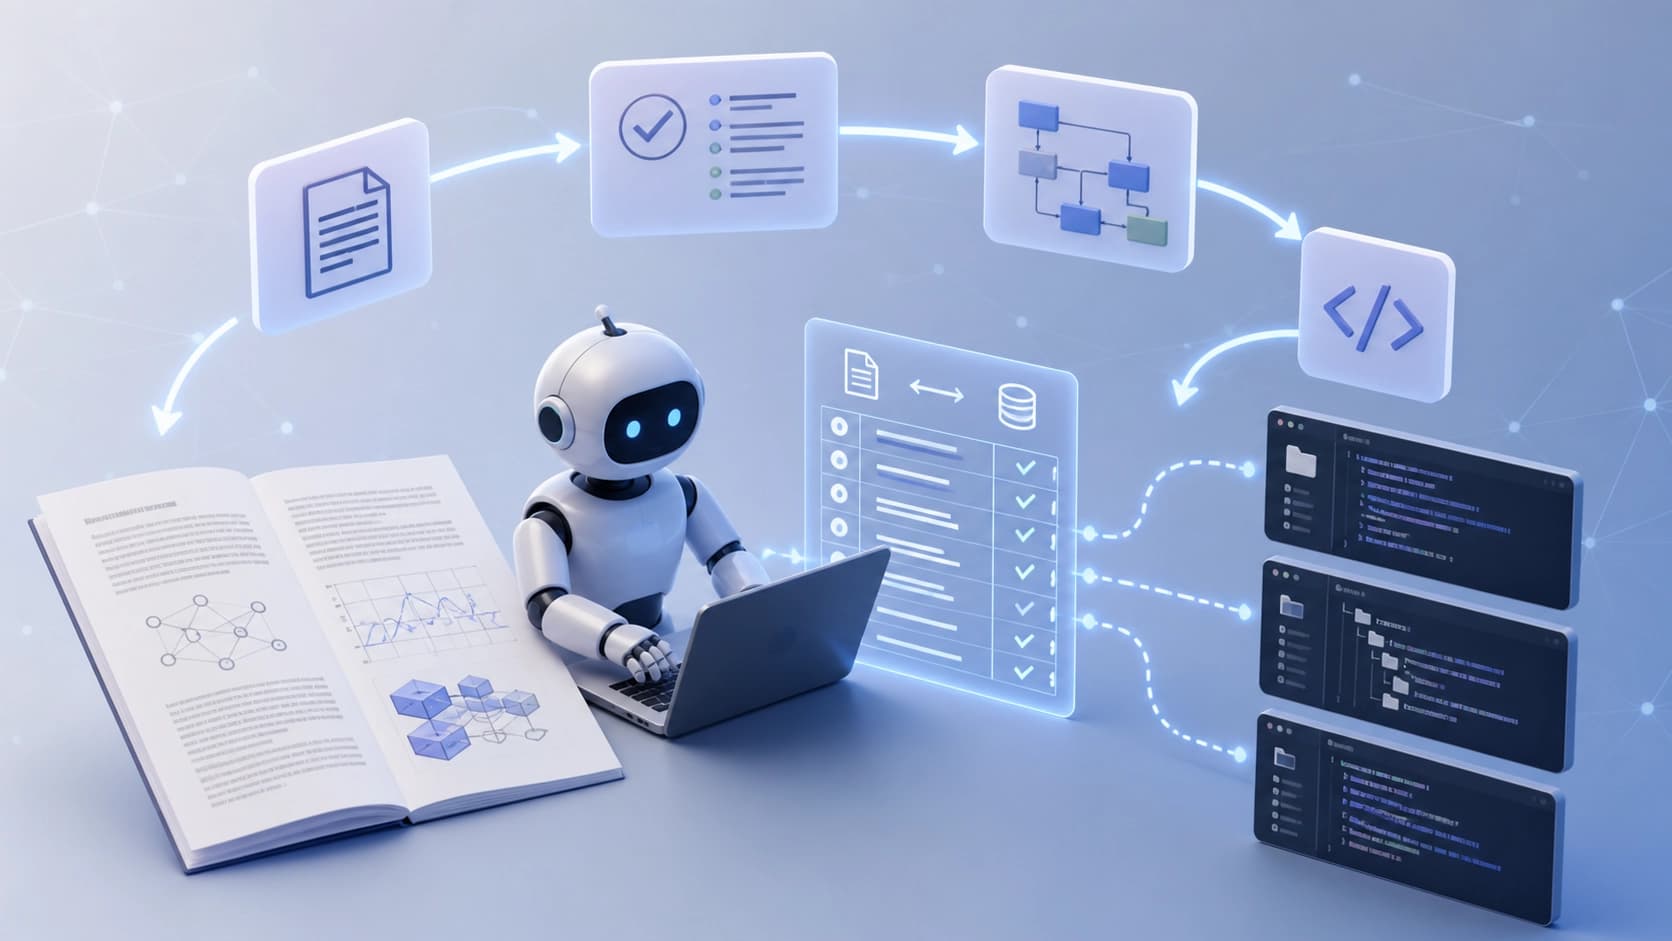
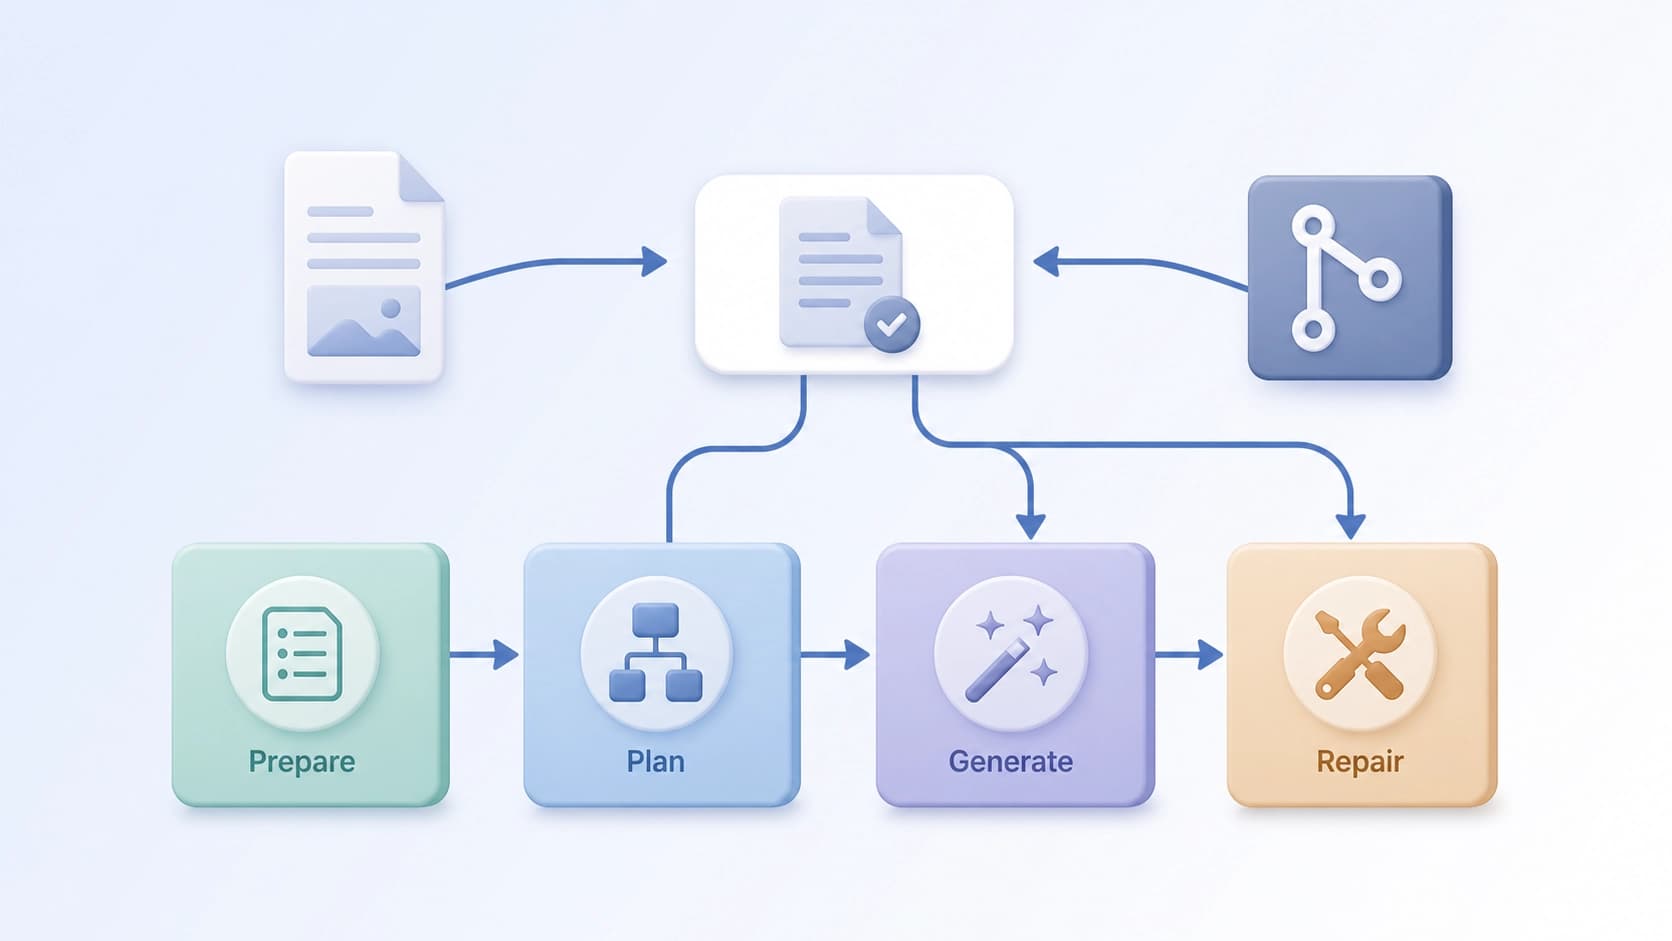
Después ambos flujos confluyen: se vinculan a work packages —paquetes de trabajo— y luego se proyectan en contratos a nivel de archivos individuales. Esa proyección es importante porque es precisamente a nivel de archivos donde el agente tiene que actuar, y es ahí donde normalmente se pierde la conexión entre "la idea del artículo" y "la línea de código".
El sentido de la construcción es que la obligación es primaria y la generación es secundaria. El agente no intenta recordar el detalle necesario en el momento de escribir el código: se remite a un requisito ya fijado.
Cuatro etapas y el papel de la reparación
El trabajo se describe como un pipeline de cuatro etapas consecutivas que forman la abreviatura Prepare — Plan — Generate — Repair.
- Prepare — preparación: análisis del artículo y los materiales relacionados, llenado inicial del contrato.
- Plan — planificación: división de la tarea en paquetes de trabajo y vinculación de obligaciones y evidencias a ellos.
- Generate — generación de código según los contratos a nivel de archivos.
- Repair — reparación: el contrato se reutiliza para entender qué exactamente se desvió del requisito, en lugar de parchear errores al azar.
Fíjese en la asimetría: el contrato se necesita no solo en la entrada, sino también al final, al corregir errores. Esta es, quizá, la parte más práctica de la idea. La mayoría de los pipelines agénticos son fuertes en la etapa de escritura y débiles en la de depuración, porque para el momento del primer error la especificación original ya está difuminada. Aquí permanece a mano.
Verificación: PaperBench Code-Dev
Los autores probaron el enfoque en PaperBench Code-Dev, un benchmark donde el agente debe reproducir código a partir de artículos científicos. Resultado: la puntuación media más alta entre los scaffolds con el mismo backbone. Es importante que el efecto se observe con dos modelos base distintos: Claude Sonnet 4.5 y Gemini 3 Flash.
Qué significan estos términos. Backbone es el modelo base, el "cerebro" del agente. Scaffold es el envoltorio a su alrededor: reglas, memoria, orden de los pasos, herramientas. La comparación con el mismo backbone es la forma correcta de mostrar que la ventaja proviene precisamente de la arquitectura y no de un modelo más potente. ReproAgent es justamente una contribución a la clase de los scaffolds.
Además, los autores realizaron ablaciones por canales: si se desactiva el canal de requisitos o el canal de evidencias, la calidad end-to-end cae. A ello se suman análisis de artículos individuales donde se ve qué aporta exactamente cada canal en ejemplos concretos. Ese doble control —medición global más análisis cualitativo— hace que las conclusiones sean más convincentes que una sola cifra en una tabla.
El código y los artefactos experimentales, según afirman los autores, están en acceso abierto.
Qué cambia esto en la práctica
El valor del trabajo no está solo en el resultado en el benchmark, sino en la propia formulación del problema. La "fragmentación de la especificación" es una buena explicación de por qué los agentes escriben con seguridad código que parece correcto pero no reproduce los resultados. Los detalles explícitos se pierden a medida que se alarga la trayectoria; los implícitos faltan desde el principio.
El contrato de implementación propone un camino alternativo: sacar las obligaciones del frágil contexto a un objeto estable aparte y consultarlo en todas las etapas, incluida la depuración. Este recurso parece transferible: requisitos fijados de forma similar pueden ser útiles también en otras tareas donde el agente necesita mantener las condiciones iniciales durante mucho tiempo: migraciones, reproducción de infraestructura, tareas de ingeniería prolongadas.
Las limitaciones también se desprenden de la lógica del método: la calidad del contrato depende directamente de la calidad de la extracción de requisitos y de lo adecuados que resulten los repositorios relacionados encontrados. Si no hay código público sobre el tema, el canal de evidencias trabaja a ciegas. Pero al menos una tesis de los autores suena convincente ya ahora: la reproducibilidad de un trabajo científico es un problema de especificación, no de velocidad de generación de código.