
RBS-Attention: aceleración del prefill de prompts largos mediante la búsqueda de bloques infravalorados
El artículo presenta un método que complementa la selección de bloques basada en la similitud media con una búsqueda de candidatos capaces de ocultar tokens importantes. En un contexto de 128K, los autores informan de una aceleración de la atención durante el prefill de hasta 20,65 veces; en Qwen3-32B, el resultado de RULER fue de 88,65, frente a 89,52 con atención densa.
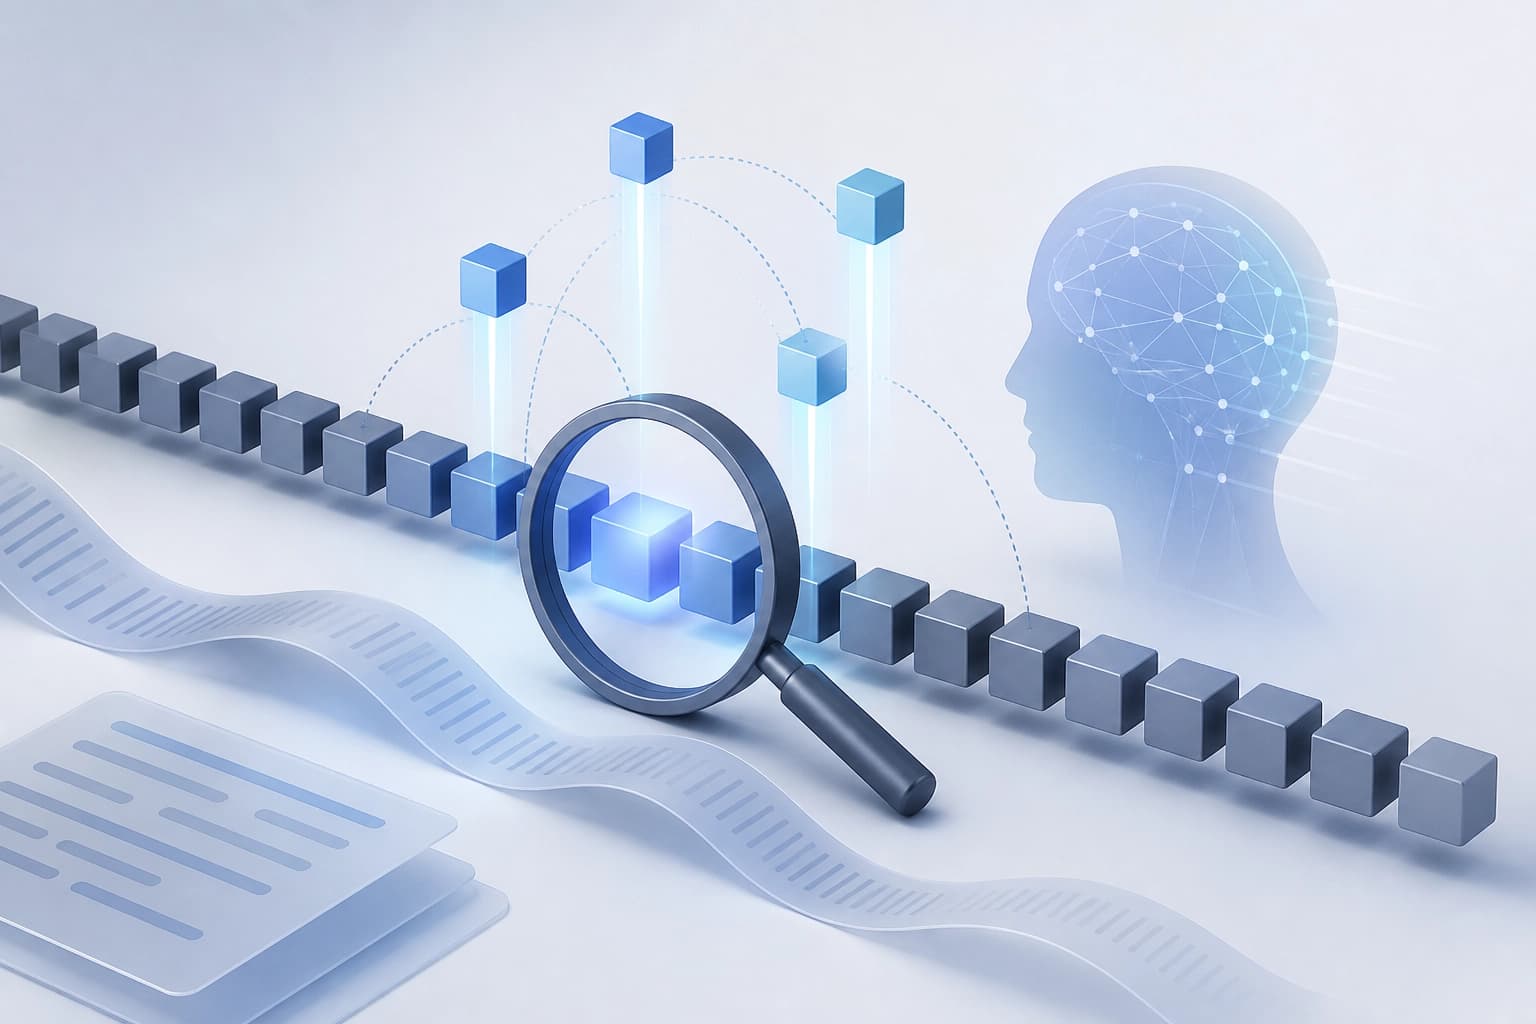
Qué parte de la inferencia acelera el método
El prefill procesa el prompt antes de que comience la generación. El self-attention denso recorre toda la entrada, por lo que un contexto largo aumenta la carga computacional de esta etapa.
RBS-Attention selecciona bloques de forma dispersa para el prefill y puede reducir los costes computacionales. Sin embargo, el centroide de un bloque promedia la relevancia de los tokens y puede ocultar un token importante entre otros irrelevantes. Los autores llaman a este fallo mean dilution.
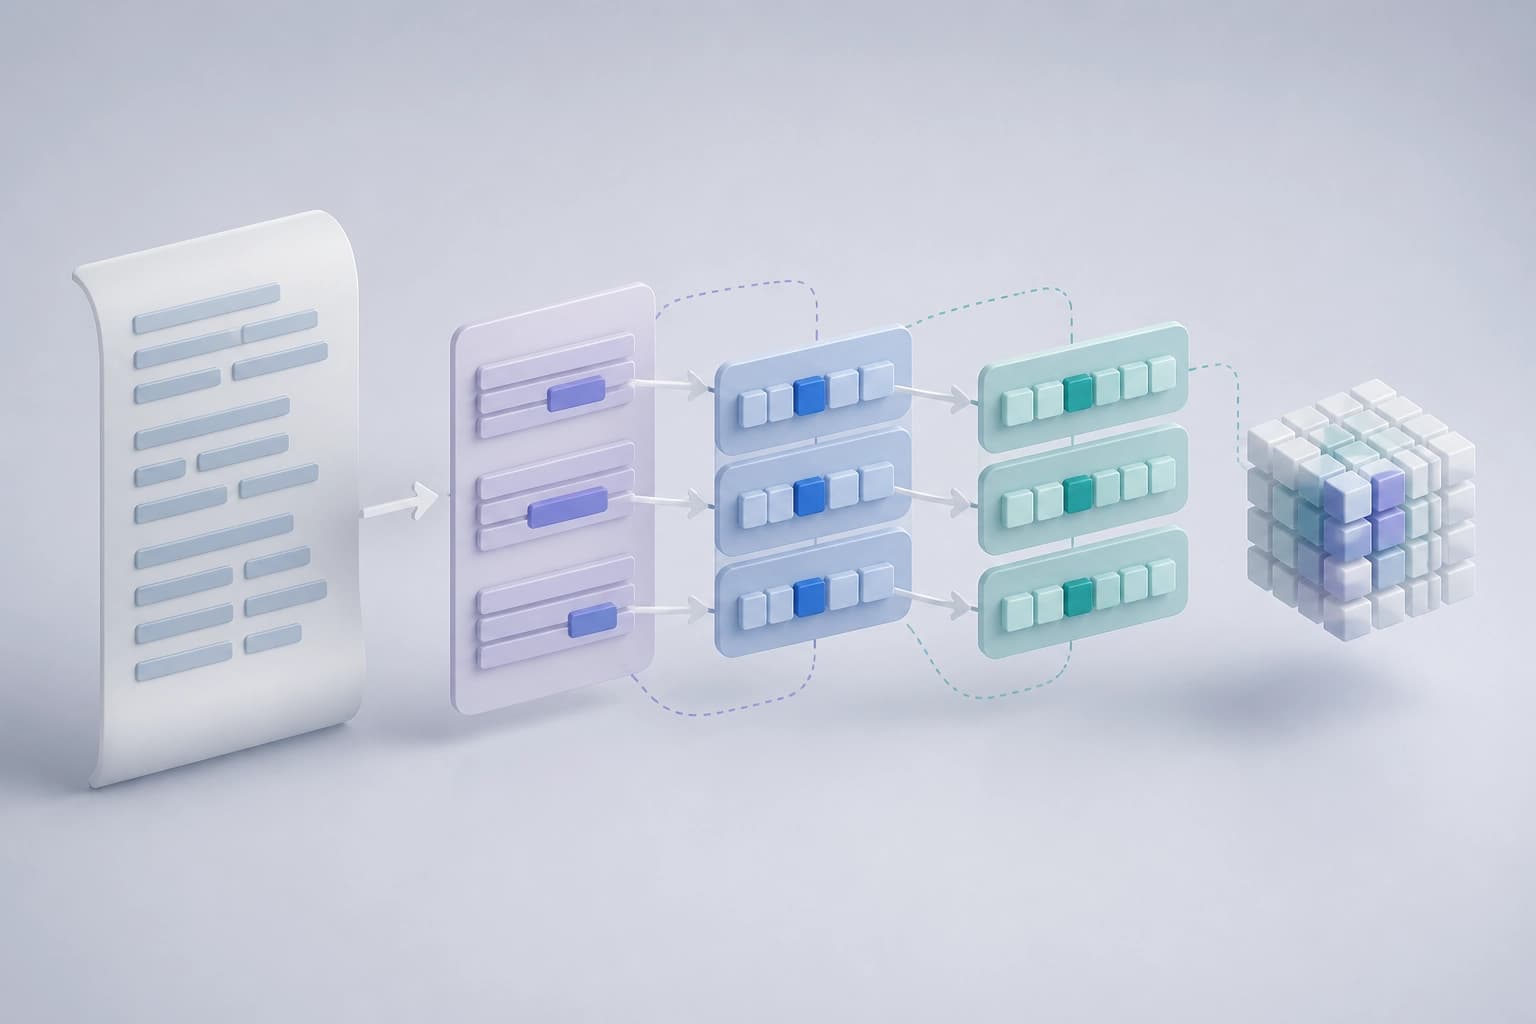
En la práctica, el método acelera el prefill sin depender únicamente de la relevancia media de todo un bloque.
Cómo funciona la selección de bloques
El método no requiere entrenamiento y utiliza dos ramas complementarias:
- Rama base: estima la relevancia media del bloque mediante el centroide.
- Rama de recuperación: tiene en cuenta el radio máximo del bloque de keys y su distribución, que depende del prompt, la capa y la cabeza. Así detecta bloques cuya relevancia podría haberse subestimado.
Cada rama aplica por separado un umbral a su selección. Después, el método combina las máscaras y controla la contribución de los bloques de recuperación. La ejecución sigue realizándose mediante FlashAttention regular con bloques dispersos.
Este diseño resulta adecuado para escenarios en los que la selección basada en centroides puede pasar por alto tokens relevantes aislados y se necesita mantener la ejecución con bloques dispersos.
Qué resultados de velocidad se muestran
Las mediciones se realizaron en una H100 con un contexto de 128K. Para Qwen3-30B-A3B-Instruct-2507-FP8, el artículo presenta las siguientes aceleraciones:
| Etapa | Aceleración |
|---|---|
| Atención de prefill independiente | 20.65× |
| Atención de prefill en vLLM | 11.92× |
| Tiempo total hasta el primer token | 5.97× |
Estos resultados corresponden a una configuración concreta. Deben considerarse por separado de la evaluación de calidad y no extrapolarse a otros modelos sin las mediciones correspondientes.
Qué se sabe sobre la calidad y las evaluaciones
En el modelo denso Qwen3-32B, la puntuación total de RULER fue de 88.65. Para el attention denso, se indica una puntuación de 89.52.
La calidad también se evaluó en LongBench-v2, InfiniteBench y Video-MME. En los experimentos complementarios se midió la conservación de los datos relevantes, se compararon selectores con la misma densidad y se probaron distintos tamaños de bloque, umbrales y cantidades de memoria.
Al elegir un método, conviene evaluar la velocidad y la calidad por separado: los resultados de RULER presentados no sustituyen las pruebas en tareas importantes para cada aplicación concreta.
Preguntas frecuentes
Material similar
Todos los materiales
Toollery: selección de herramientas para agentes LLM entre decenas de miles de opciones sin necesidad de ajuste fino
Toollery construye un índice de búsqueda a partir de las descripciones de habilidades y herramientas y, al recibir una consulta, solo envía al modelo un conjunto limitado de candidatos. En experimentos con bibliotecas de hasta decenas de miles de funciones, el enfoque permite mantener la calidad de selección con un top-K fijo, aunque el efecto final depende del perfil de carga y del almacenamiento en caché del proveedor.
11 noviembre 2026
Diagnóstico por etapas de agentes GUI al analizar dashboards: el benchmark DashAct
Se presenta DashAct, un benchmark de 348 trayectorias verificadas por humanos que desglosa el trabajo de los agentes GUI con paneles interactivos en tres etapas y cuatro condiciones visuales. Los resultados revelan problemas persistentes para predecir acciones y vincularlas con objetivos visuales, así como la dependencia de las respuestas de los agentes del apoyo contextual y espacial.
11 noviembre 2026
WILSON: integración de aumentos y portaobjetos del paciente para el análisis anatomopatológico y la elaboración de informes
El preprint presenta WILSON, un modelo de visión y lenguaje que codifica imágenes de portaobjetos completos y series de muestras de un mismo paciente a distintos aumentos, en lugar de limitarse a un único portaobjetos «mejor». Sin necesidad de ajustarlo a la tarea, supera a modelos especializados y de mayor tamaño para portaobjetos en varias métricas, con una carga computacional considerablemente menor, y sus descripciones diagnósticas obtuvieron puntuaciones más altas de los patólogos.
11 noviembre 2026