
Diagnóstico por etapas de agentes GUI al analizar dashboards: el benchmark DashAct
Se presenta DashAct, un benchmark de 348 trayectorias verificadas por humanos que desglosa el trabajo de los agentes GUI con paneles interactivos en tres etapas y cuatro condiciones visuales. Los resultados revelan problemas persistentes para predecir acciones y vincularlas con objetivos visuales, así como la dependencia de las respuestas de los agentes del apoyo contextual y espacial.
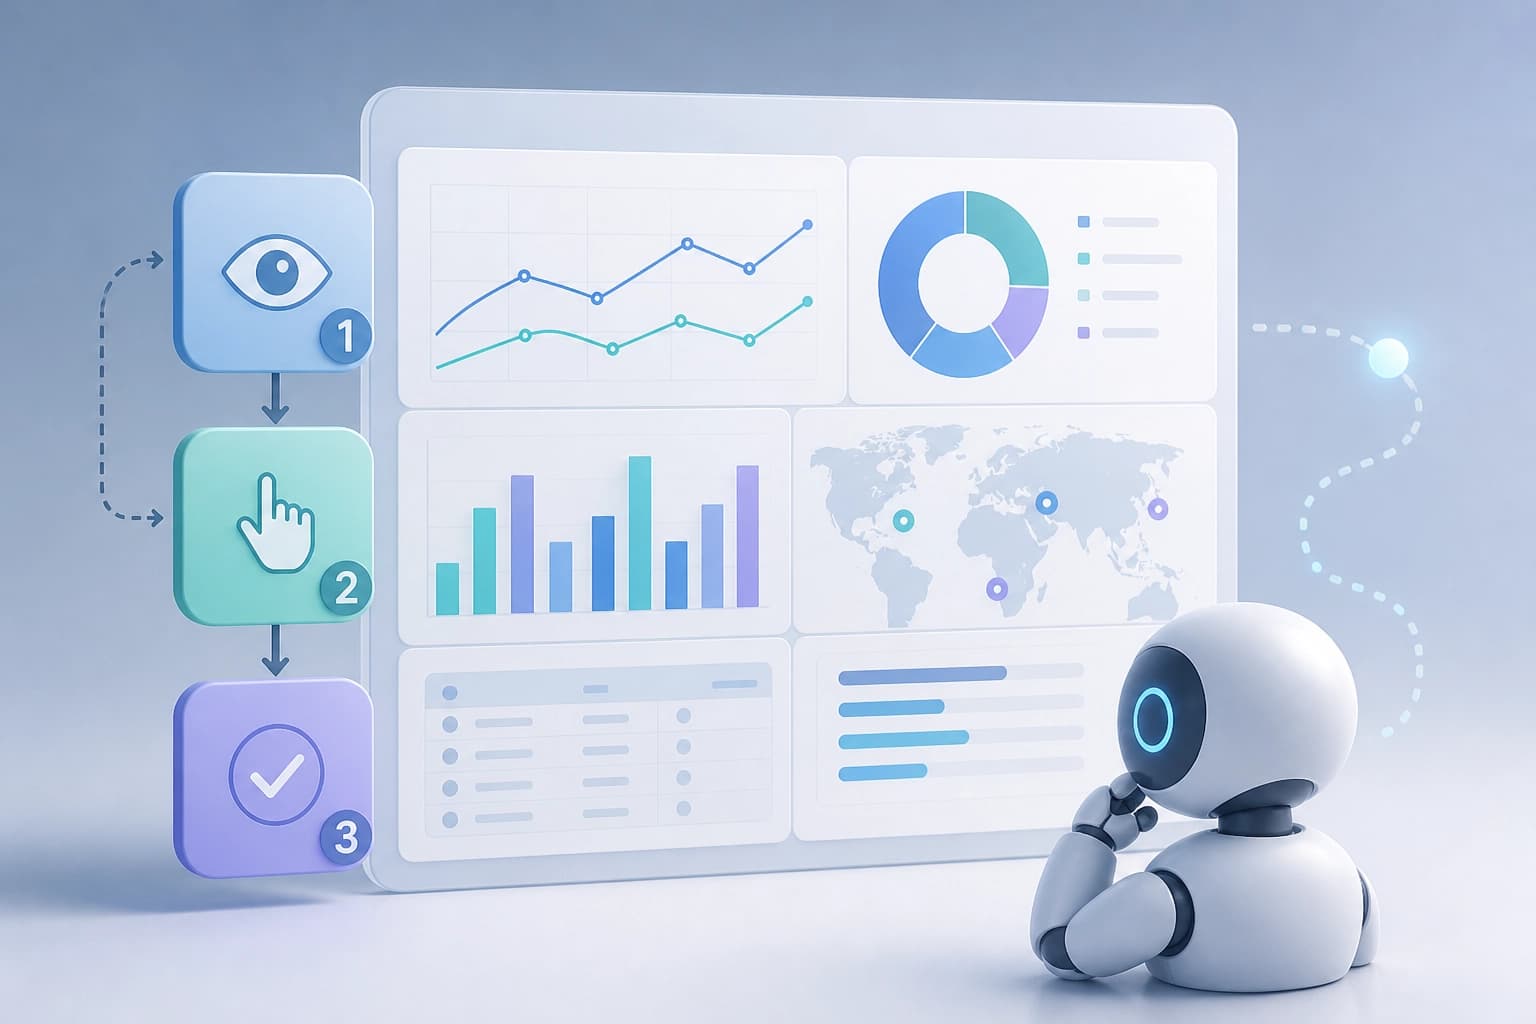
Qué evalúa DashAct
DashAct es un benchmark para evaluar agentes GUI durante el análisis interactivo de paneles de control. Evalúa las mismas interacciones anotadas con distintos niveles sistemáticos de apoyo contextual y espacial. La versión v2 está fechada el 19 de octubre de 2026; la primera versión, el 26 de septiembre de 2026.
Conclusión: DashAct compara agentes GUI en las mismas interacciones anotadas. Criterio práctico: elegir un benchmark para diagnosticar fallos, no solo para obtener una métrica final.
Tres etapas de diagnóstico
El benchmark divide el diagnóstico en tres etapas. Van desde la ejecución completa hasta las comprobaciones aisladas. Cuatro condiciones visuales modifican las condiciones de las mismas interacciones.
| Etapa | Qué evalúa | Función en el diagnóstico |
|---|---|---|
| end-to-end execution | Ejecución completa de la interacción con el panel de control | Muestra los fallos durante la ejecución en línea |
| verified-context action prediction | Predicción de acciones con el contexto verificado | Separa los errores de predicción de acciones |
| target-conditioned grounding | Fundamentación visual del objetivo según la condición | Comprueba la precisión de la localización del objetivo |
Las anotaciones coherentes de acciones y ubicación espacial vinculan los resultados de las etapas. Ayudan a interpretar los fallos durante la ejecución en línea.
Conclusión: las etapas no se duplican entre sí. Criterio práctico: empezar por end-to-end execution para investigar un fallo general y, después, pasar a la predicción de acciones y al grounding para encontrar el origen del error.
Cómo se organizan las trayectorias y las anotaciones
El conjunto contiene 348 trayectorias de interacción verificadas por personas. Las trayectorias incluyen dependencias entre etapas (milestone dependencies). Las anotaciones jerárquicas de objetivos (hierarchical target annotations) definen la estructura de las tareas. Las anotaciones coherentes de acciones y ubicación espacial están vinculadas a las mismas interacciones.
Este etiquetado permite comparar los resultados de las etapas. Si un agente falla en end-to-end execution, las anotaciones muestran en qué paso y respecto a qué objetivo se produjo el fallo. Esto hace que el diagnóstico sea reproducible.
Conclusión: el valor de DashAct reside en la coherencia de sus anotaciones. Criterio práctico: comprobar si coinciden las anotaciones de acciones y de ubicación espacial antes de concluir que el agente ha cometido un error.
Condiciones visuales y respuesta de los modelos
DashAct evalúa las mismas interacciones en cuatro condiciones visuales. La respuesta al apoyo contextual y espacial depende del modelo. Un mismo agente puede rendir de manera distinta cuando cambia el nivel de apoyo. Comparar solo una condición no permite evaluar la robustez.
Conclusión: para el diagnóstico hay que examinar las cuatro condiciones visuales. Criterio práctico: registrar cómo cambia el resultado con el apoyo contextual y espacial, en lugar de fijarse únicamente en la precisión final.
Qué mostraron los experimentos y la adaptación de Qwen
Los experimentos revelaron dificultades persistentes en la predicción de acciones y en la fundamentación visual precisa de los objetivos. El estudio de adaptación basada en Qwen mejoró además la localización de objetivos y online Milestone Coverage. La mejora afectó a la localización de objetivos y a online Milestone Coverage. Estos resultados corresponden a distintas etapas del diagnóstico.
Conclusión: la adaptación basada en Qwen es útil para la localización de objetivos y online Milestone Coverage. Criterio práctico: evaluar online Milestone Coverage por separado de la localización de objetivos para observar el efecto de la adaptación.
Cómo integrar DashAct en un diagnóstico por etapas
El diagnóstico por etapas comienza con end-to-end execution. Después viene verified-context action prediction. La última etapa es target-conditioned grounding. Las cuatro condiciones visuales repiten las mismas interacciones en diferentes condiciones.
El orden importa: cada etapa sucesiva acota el origen del error. Las anotaciones vinculan los resultados y evitan que se pierda el contexto. Si el fallo se repite en distintas etapas, es más probable que la causa esté en el agente y no en una condición aislada.
Conclusión: DashAct ofrece una estructura para analizar los fallos. Criterio práctico: usar las tres etapas y las cuatro condiciones visuales. Evaluar el resultado de la adaptación de Qwen según la localización de objetivos y online Milestone Coverage.
Preguntas frecuentes
Material similar
Todos los materiales
Toollery: selección de herramientas para agentes LLM entre decenas de miles de opciones sin necesidad de ajuste fino
Toollery construye un índice de búsqueda a partir de las descripciones de habilidades y herramientas y, al recibir una consulta, solo envía al modelo un conjunto limitado de candidatos. En experimentos con bibliotecas de hasta decenas de miles de funciones, el enfoque permite mantener la calidad de selección con un top-K fijo, aunque el efecto final depende del perfil de carga y del almacenamiento en caché del proveedor.
11 noviembre 2026
WILSON: integración de aumentos y portaobjetos del paciente para el análisis anatomopatológico y la elaboración de informes
El preprint presenta WILSON, un modelo de visión y lenguaje que codifica imágenes de portaobjetos completos y series de muestras de un mismo paciente a distintos aumentos, en lugar de limitarse a un único portaobjetos «mejor». Sin necesidad de ajustarlo a la tarea, supera a modelos especializados y de mayor tamaño para portaobjetos en varias métricas, con una carga computacional considerablemente menor, y sus descripciones diagnósticas obtuvieron puntuaciones más altas de los patólogos.
11 noviembre 2026
Invariantes polinómicos canónicos en el diagnóstico de fallos de simuladores de RL: dónde son realmente útiles
El estudio analiza si está justificado incorporar leyes físicas a modelos de dinámica entrenables: los invariantes extraídos de las trayectorias y llevados a una forma canónica mediante bases de Gröbner ofrecen una mejora modesta en las predicciones, pero destacan en el diagnóstico: permiten localizar la restricción incumplida e identificar el parámetro concreto que es erróneo.
10 noviembre 2026