
WILSON: integración de aumentos y portaobjetos del paciente para el análisis anatomopatológico y la elaboración de informes
El preprint presenta WILSON, un modelo de visión y lenguaje que codifica imágenes de portaobjetos completos y series de muestras de un mismo paciente a distintos aumentos, en lugar de limitarse a un único portaobjetos «mejor». Sin necesidad de ajustarlo a la tarea, supera a modelos especializados y de mayor tamaño para portaobjetos en varias métricas, con una carga computacional considerablemente menor, y sus descripciones diagnósticas obtuvieron puntuaciones más altas de los patólogos.
Por qué un solo portaobjetos representativo no es suficiente
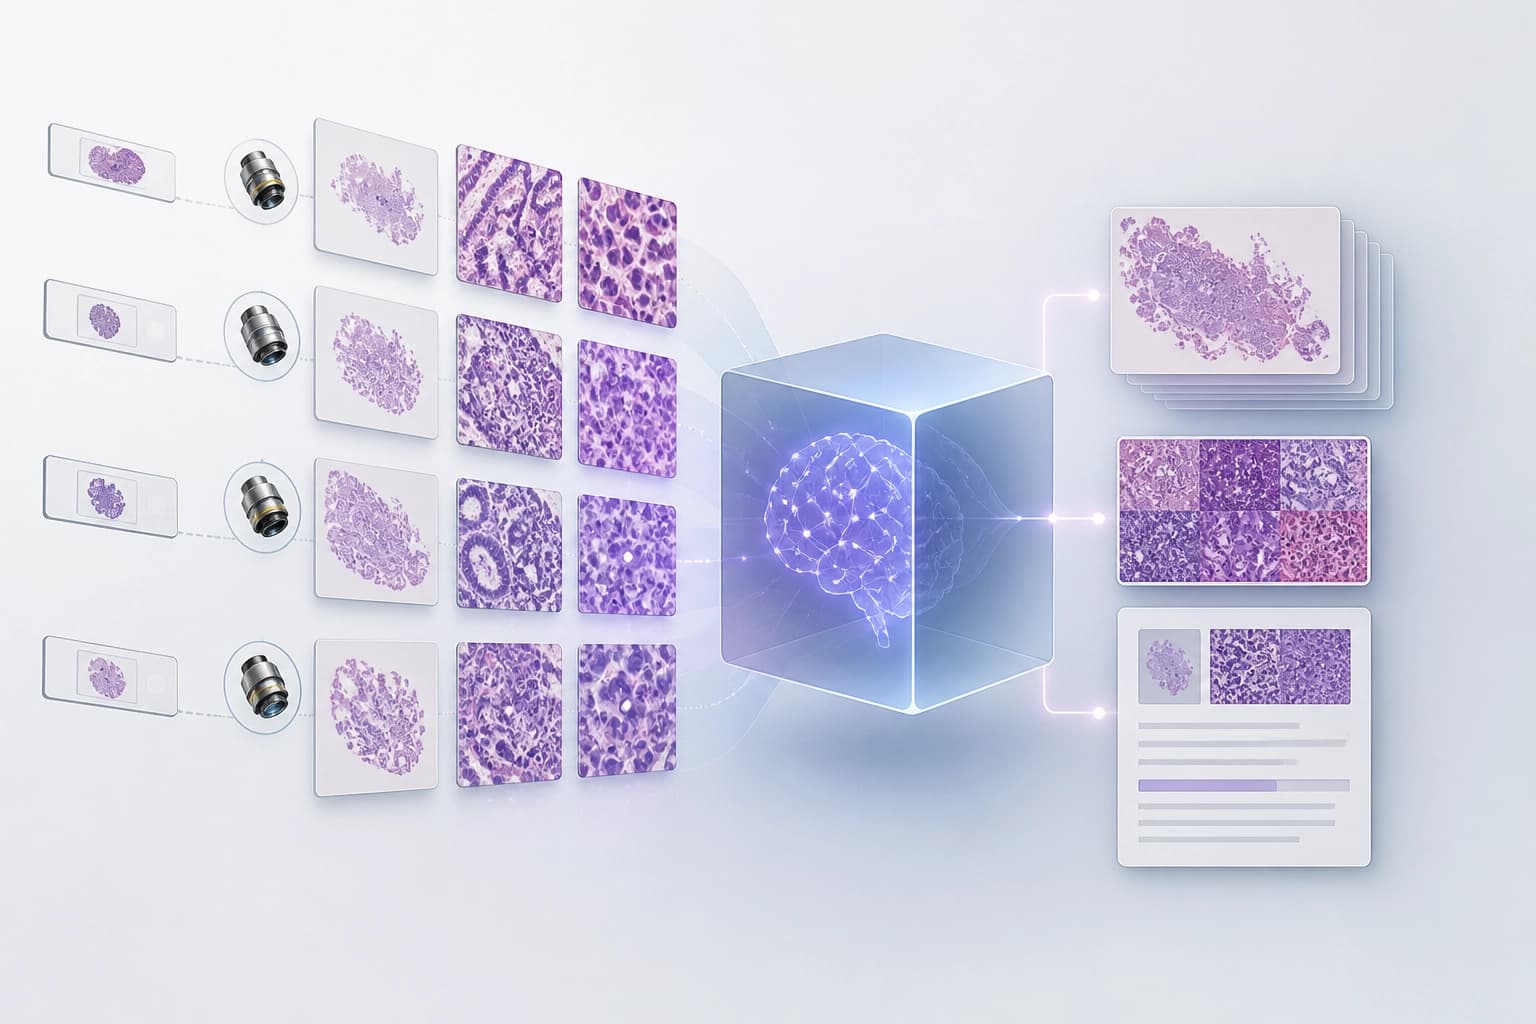
Los patólogos examinan cortes de tejido con distintos aumentos y en varios portaobjetos. Combinan la información morfológica para establecer un diagnóstico. La mayoría de los modelos fundacionales para patología codifican miles de fragmentos de imagen de un único portaobjetos representativo («best»). Después, los modelos agregan esas características.
Limitaciones de este enfoque:
- el modelo recibe un único portaobjetos «best», no el caso completo;
- las características de distintos aumentos no se vinculan en una representación común;
- el contexto del paciente se pierde al agregar los fragmentos.
Criterio práctico: para una tarea a nivel de caso se necesita un modelo que admita varios portaobjetos y distintos aumentos. Un solo portaobjetos representativo no basta para este tipo de tarea.
Cómo combina el modelo los aumentos y los portaobjetos
WILSON es un modelo fundacional de visión y lenguaje. Representa imágenes de portaobjetos completos y casos con varios portaobjetos mediante composiciones multimagnificación. Permite realizar análisis a nivel del paciente.
Qué incluye la representación:
- imágenes de portaobjetos completos;
- casos con varios portaobjetos;
- varios aumentos integrados en composiciones multimagnificación.
Conclusión: el modelo conserva en una sola representación la información morfológica de distintos aumentos y portaobjetos. Esto lo diferencia del enfoque basado en un único portaobjetos «best».
Entrenamiento y cobertura de los datos
El conjunto de entrenamiento de WILSON consta de unos 189 000 portaobjetos. Los datos abarcan 42 órganos y 838 entidades diagnósticas.
Cobertura:
- 189 000 portaobjetos;
- 42 órganos;
- 838 entidades diagnósticas.
La lista de órganos y entidades establece el marco para evaluar la tarea. El especialista comprueba que el órgano y la entidad diagnóstica estén incluidos en esa lista.
Resultados sin entrenamiento específico para la tarea
WILSON superó a un modelo especializado a nivel de caso en macro-F1, sin entrenamiento específico para la tarea. Obtuvo 0.52, frente a 0.38.
| Comparación | WILSON | Alternativa |
|---|---|---|
| Macro-F1 en una tarea a nivel de caso | 0.52 | 0.38 |
| Operaciones computacionales | entre 400 y 1 350 veces menos | modelos a nivel de portaobjetos considerablemente más grandes |
El modelo también obtuvo resultados comparables a los de modelos a nivel de portaobjetos considerablemente más grandes. Aun así, requiere entre 400 y 1 350 veces menos operaciones computacionales.
Conclusión: la calidad del análisis a nivel de caso no tiene por qué aumentar junto con el coste computacional. Una representación compacta y multiescala ofrece una referencia práctica.
Ajuste para tareas específicas
El ajuste fino de extremo a extremo mejoró los resultados de WILSON en las tareas de:
- subtipificación del cáncer de mama;
- gradación de linfocitos estromales.
Criterio práctico: para una tarea específica conviene considerar el ajuste fino de extremo a extremo. El modelo base permite realizar análisis a nivel de caso sin ajuste, y el ajuste fino mejora los resultados en tareas concretas.
Búsqueda y generación de texto diagnóstico
En recuperación de imágenes y texto, WILSON superó a PRISM en recall@1. Obtuvo un 75.6%, frente al 58.1%.
| Métrica | WILSON | PRISM |
|---|---|---|
| recall@1 | 75.6% | 58.1% |
Cinco patólogos con certificación board otorgaron puntuaciones más altas a las descripciones diagnósticas de WILSON. Los modelos competidores obtuvieron puntuaciones más bajas.
Criterio práctico: para la búsqueda y la preparación de informes son importantes dos capacidades: la recuperación y la generación de texto. Se evalúan con tareas similares a las del flujo de trabajo.
Qué significa esto al elegir un modelo
Los autores concluyen que las representaciones compactas y multiescala pueden sustentar modelos fundacionales computacionalmente eficientes y orientados a la práctica clínica. Para elegir un modelo, esto implica realizar varias comprobaciones.
Criterios:
- el modelo admite varios portaobjetos;
- el modelo vincula distintos aumentos;
- el análisis se realiza a nivel del paciente;
- la calidad se mide en tareas a nivel de caso;
- se tienen en cuenta las operaciones computacionales;
- la recuperación y la generación de texto se evalúan por separado.
Conclusión: un único portaobjetos «best» y la agregación de miles de fragmentos no abarcan el contexto del paciente. El modelo se elige en función de cómo integra ese contexto y de cuántos recursos computacionales requiere.
Preguntas frecuentes
Material similar
Todos los materiales
Diagnóstico por etapas de agentes GUI al analizar dashboards: el benchmark DashAct
Se presenta DashAct, un benchmark de 348 trayectorias verificadas por humanos que desglosa el trabajo de los agentes GUI con paneles interactivos en tres etapas y cuatro condiciones visuales. Los resultados revelan problemas persistentes para predecir acciones y vincularlas con objetivos visuales, así como la dependencia de las respuestas de los agentes del apoyo contextual y espacial.
11 noviembre 2026
Invariantes polinómicos canónicos en el diagnóstico de fallos de simuladores de RL: dónde son realmente útiles
El estudio analiza si está justificado incorporar leyes físicas a modelos de dinámica entrenables: los invariantes extraídos de las trayectorias y llevados a una forma canónica mediante bases de Gröbner ofrecen una mejora modesta en las predicciones, pero destacan en el diagnóstico: permiten localizar la restricción incumplida e identificar el parámetro concreto que es erróneo.
10 noviembre 2026
AURA-Eval: cómo comprobar que un agente LLM reconoció el riesgo y cambió su siguiente paso
El framework evalúa el comportamiento de los agentes LLM no por su veredicto final, sino por cómo reaccionan ante el riesgo en puntos clave: se interrumpen las trayectorias de llamadas a herramientas y, a continuación, el modelo debe continuar razonando y actuando, mientras que un panel de jueces LLM analiza la detección del riesgo, la naturaleza del paso y su seguridad. En 1249 tareas recopiladas a partir de 157 trayectorias de R-Judge, los actos inseguros aumentan en 20 modelos cuando no hay una vía segura, y retirar la supervisión antes de la ejecución convierte el 52,3 % de los casos inicialmente seguros en inseguros.
10 noviembre 2026