
La sabiduría de las multitudes choca con la uniformidad
Cuando hay que predecir algo sobre el futuro —el comportamiento del mercado, el desenlace de un evento, el destino de una tecnología— surge una idea simple: cuantas más modelos consultemos, más fiable será la respuesta. La lógica parece irrefutable: sistemas distintos se equivocan de formas distintas, así que promediar suavizará los errores aleatorios.
Pero este esquema tiene una trampa. Si todos los participantes de la «multitud» razonan de manera parecida, sus votos no son testimonios independientes, sino una misma opinión multiplicada por copia. Diez respuestas casi idénticas no aportan más información que una sola; solo crean una sensación de confianza y aumentan la factura de inferencia.
Precisamente en torno a este problema se construye el trabajo «Diverse by Reasoning: Harnessing the Wisdom of LLM Crowds for Future Prediction», preparado por Niropam Chetlapalli, Yiming Liao, Min-Chun Chen y Keke Chen. El preprint arXiv:2608.24001 apareció el 25 de agosto de 2026, al día siguiente ya salió una versión revisada, y el propio artículo fue enviado a IEEE BigData 2026.
Simplemente «más modelos» no resuelve el problema
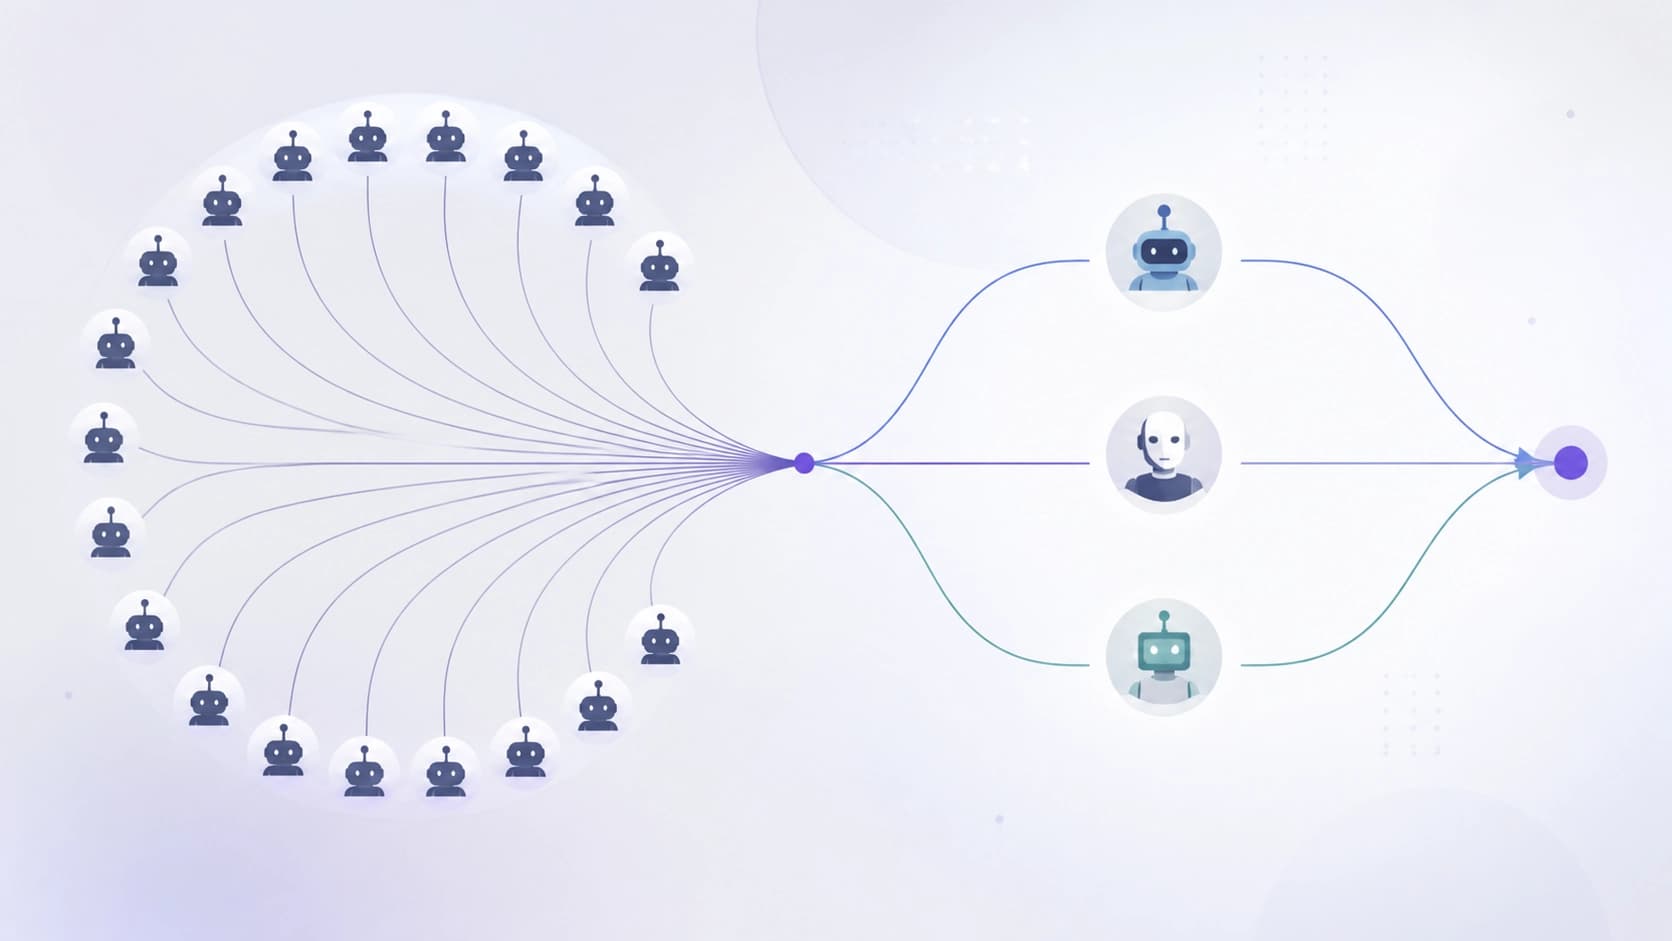
La observación clave de los autores: distintos modelos grandes de lenguaje pueden comportarse de forma redundante. Están entrenados con datos comparables, tienden a formulaciones similares y a patrones de razonamiento típicos. Como resultado, ampliar mecánicamente la lista de participantes no aporta la diversidad por la que se hacía todo esto.
Aquí es importante distinguir dos conceptos. La cantidad es cuántos modelos consultamos. La diversidad es cuán diferente llegan a sus conclusiones. Lo segundo no se deriva automáticamente de lo primero: se pueden reunir veinte participantes y obtener veinte variaciones de una misma idea.
Método: los modelos se seleccionan por su estilo de razonamiento, no por sus respuestas
Cómo es la selección conductual
Los autores proponen un marco que denominan orientado al comportamiento. La esencia no es comparar modelos por la corrección de sus respuestas finales, sino entender cómo piensan.
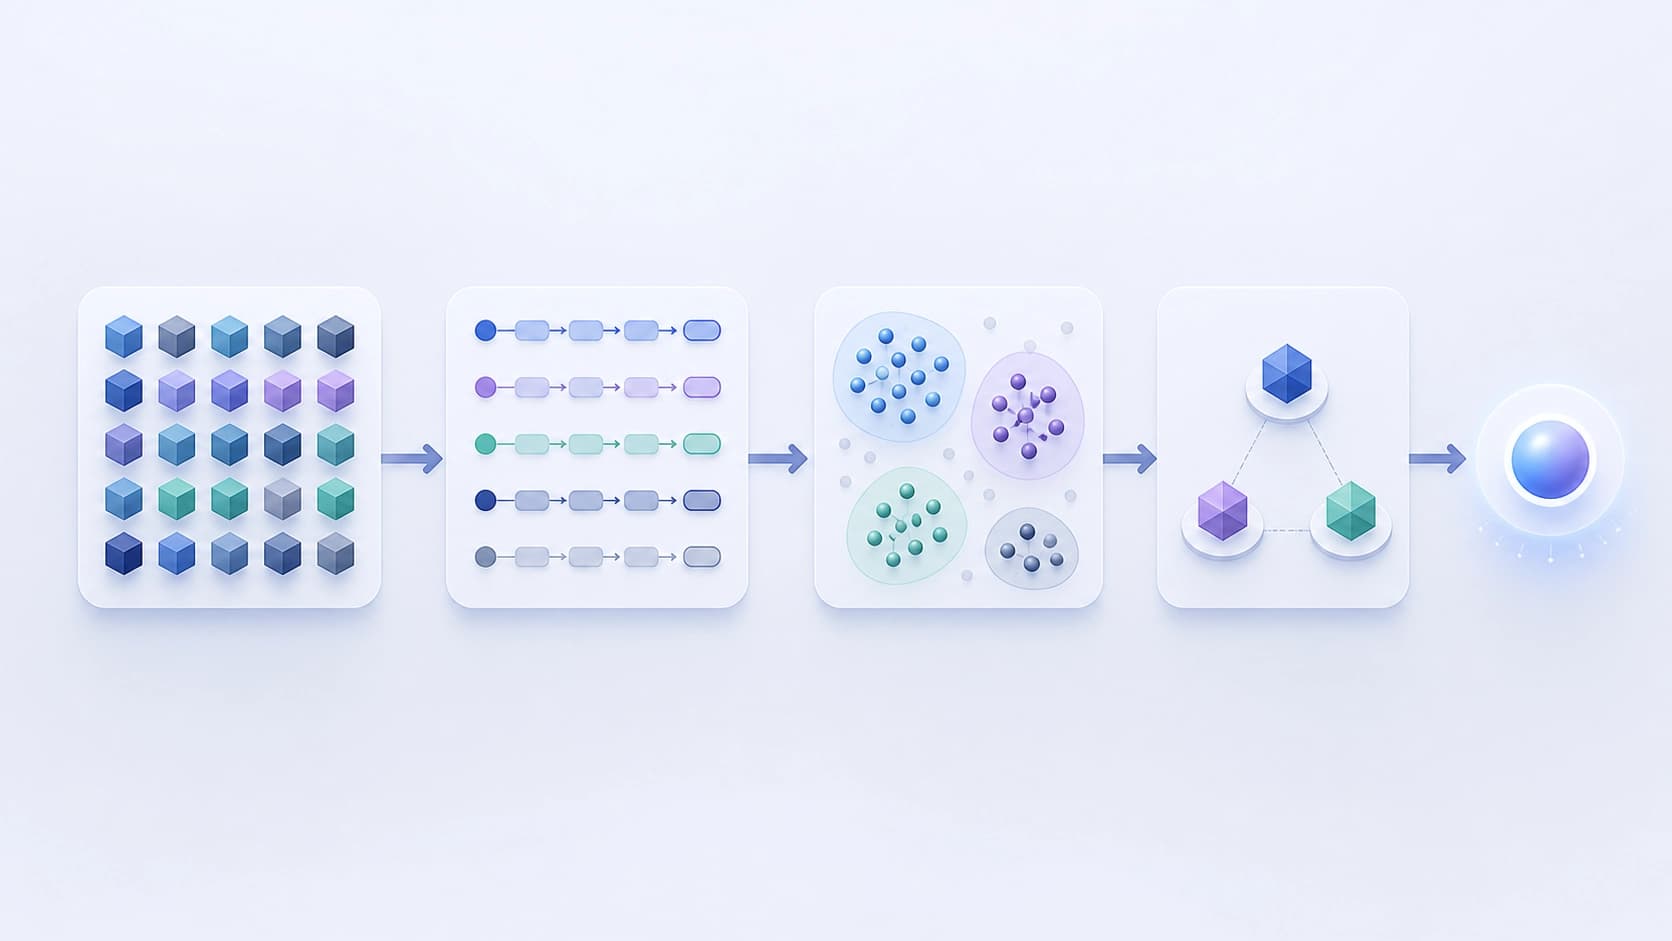
El esquema es el siguiente:
- Cada uno de los modelos se ejecuta sobre un conjunto de tareas independientes, no relacionadas con la predicción del futuro. Se recogen no tanto las respuestas como las cadenas de razonamiento —esos mismos reasoning traces.
- A partir de estos rastros se construye un perfil conductual: qué pasos da el modelo, cómo descompone la tarea, dónde se equivoca, a qué argumentos recurre.
- Los modelos se agrupan en clústeres por similitud de comportamiento. Para ello se utiliza el algoritmo K-means++.
- De cada clúster se toma un representante: el medoide, es decir, el modelo más típico de su grupo.
- Ya esta compacta «multitud» de medoides emite el pronóstico colectivo.
La idea, si se piensa bien, no es nueva: así se procede en estadística cuando, de rasgos correlacionados, se deja un solo representante para no duplicar la misma información. La novedad aquí está en que el «rasgo» pasa a ser la manera de razonar de un modelo de lenguaje, y no una característica numérica.
Con qué se evaluó
El experimento se construye sobre 25 modelos. Siete benchmarks de desarrollo se usaron para describir y separar los modelos por comportamiento, y dos benchmarks aparte —ya sobre predicción del futuro— para evaluar la calidad de las «multitudes» resultantes. Esta separación es fundamental: las tareas con las que se construye el perfil no coinciden con las tareas con las que se calcula el resultado. De lo contrario se trataría de un entrenamiento con filtración, y las cifras no significarían casi nada.
Resultado: tres modelos superan a veinticinco
Lo más llamativo del trabajo es el resultado de la comparación. Una «multitud» de solo tres modelos medoides, reunida mediante agrupamiento conductual, se comportó mejor que la votación habitual sobre los 25 modelos a la vez. Y esto se cumple para ambos benchmarks de predicción.
Además, el ahorro resultó considerable: el número de llamadas a los modelos se redujo un 88%, y los costes de inferencia, aproximadamente un 80%. Para la práctica, esto es casi más importante que el propio aumento de precisión. Los sistemas de predicción a menudo chocan no con la calidad de la respuesta, sino con su precio: si para cada pregunta hay que consultar a una veintena de modelos, la solución deja de ser rentable mucho antes de ser imprecisa.
De aquí se desprende una conclusión poco evidente: la composición de la «multitud» pesa más que su tamaño. Veinticinco modelos no son una ventaja automática frente a tres, si esos veinticinco en esencia se repiten entre sí.
No toda diversidad es igualmente útil
Los autores extraen una conclusión más, sutil, que es fácil pasar por alto. Resulta que lo importante no es maximizar la diversidad como tal, sino la representatividad: hasta qué punto los participantes seleccionados reflejan los distintos polos de comportamiento que existen entre los modelos.
La diferencia es fundamental. Se pueden reunir tres modelos que difieren entre sí de forma aleatoria y en detalles menores, y obtener ruido en lugar de señal. O se puede seleccionar uno de cada grupo conductual realmente distinto, y obtener un conjunto compacto que cubre el espacio de soluciones. Lo primero es heterogeneidad superficial; lo segundo, diversidad real. Funciona lo segundo.
Aquí se impone un paralelismo con la pericia habitual. Un buen comité no es el que tiene más personas, sino el que representa enfoques y puntos de vista distintos. Cinco especialistas de áreas diferentes suelen ser más útiles que quince egresados de un mismo departamento.
Qué significa esto en la práctica
Para quienes construyen servicios de predicción sobre modelos de lenguaje, las conclusiones del artículo ofrecen una receta bastante concreta:
- No obsesionarse con la longitud de la lista de modelos. Ampliar el conjunto sin analizar el comportamiento significa pagar por respuestas duplicadas.
- Primero medir el comportamiento, luego elegir la composición. Una pasada por tareas ajenas y el agrupamiento ofrecen una imagen clara de quién destaca realmente en el conjunto.
- Ahorrar con criterio. Reducir el número de llamadas en un orden de magnitud manteniendo o mejorando la precisión cambia la economía del producto, no solo sus características técnicas.
- Tener presentes las limitaciones. Todo esto se verificó con un conjunto concreto de 25 modelos y dos benchmarks de predicción; no conviene trasladar las cifras tal cual a otros dominios y otros modelos.
La idea principal del trabajo suena casi humana: el valor de la opinión colectiva no se sostiene en la cantidad de votos, sino en que esos votos sean realmente distintos. Aplicado a los modelos de lenguaje, esto significa que hay que medir no una lista de nombres, sino el estilo de pensamiento, y a partir de él armar el equipo.


