
Por qué «muéstrame dónde está» es la pregunta equivocada
La prueba clásica de orientación visual parece casi de escuela: se da una imagen y una frase como «la carpeta azul en el estante inferior», y el modelo debe señalar dónde se encuentra el objeto buscado. Una consulta, una respuesta, una métrica: acertó o no.
El esquema es cómodo, pero describe una orden, no una conversación. En la comunicación real, una persona rara vez ofrece una descripción exhaustiva a la primera. Dice «pues esa cosa que está junto a la ventana» y espera que su interlocutor adivine o pregunte de nuevo. El entendimiento mutuo se construye a lo largo del diálogo, a veces en dos turnos, a veces en cinco.
Los autores del trabajo arXiv:2608.23978 (Zhengxiang Wang y Owen Rambow, artículo aceptado en EMNLP 2026) proponen considerar precisamente esa etapa omitida como objeto de medición. Su pregunta es la siguiente: ¿es capaz el modelo no solo de mirar, sino también de preguntar cuando las imágenes y las palabras no bastan para una inferencia inequívoca?
Cómo está diseñado el experimento
Déficit de información controlado
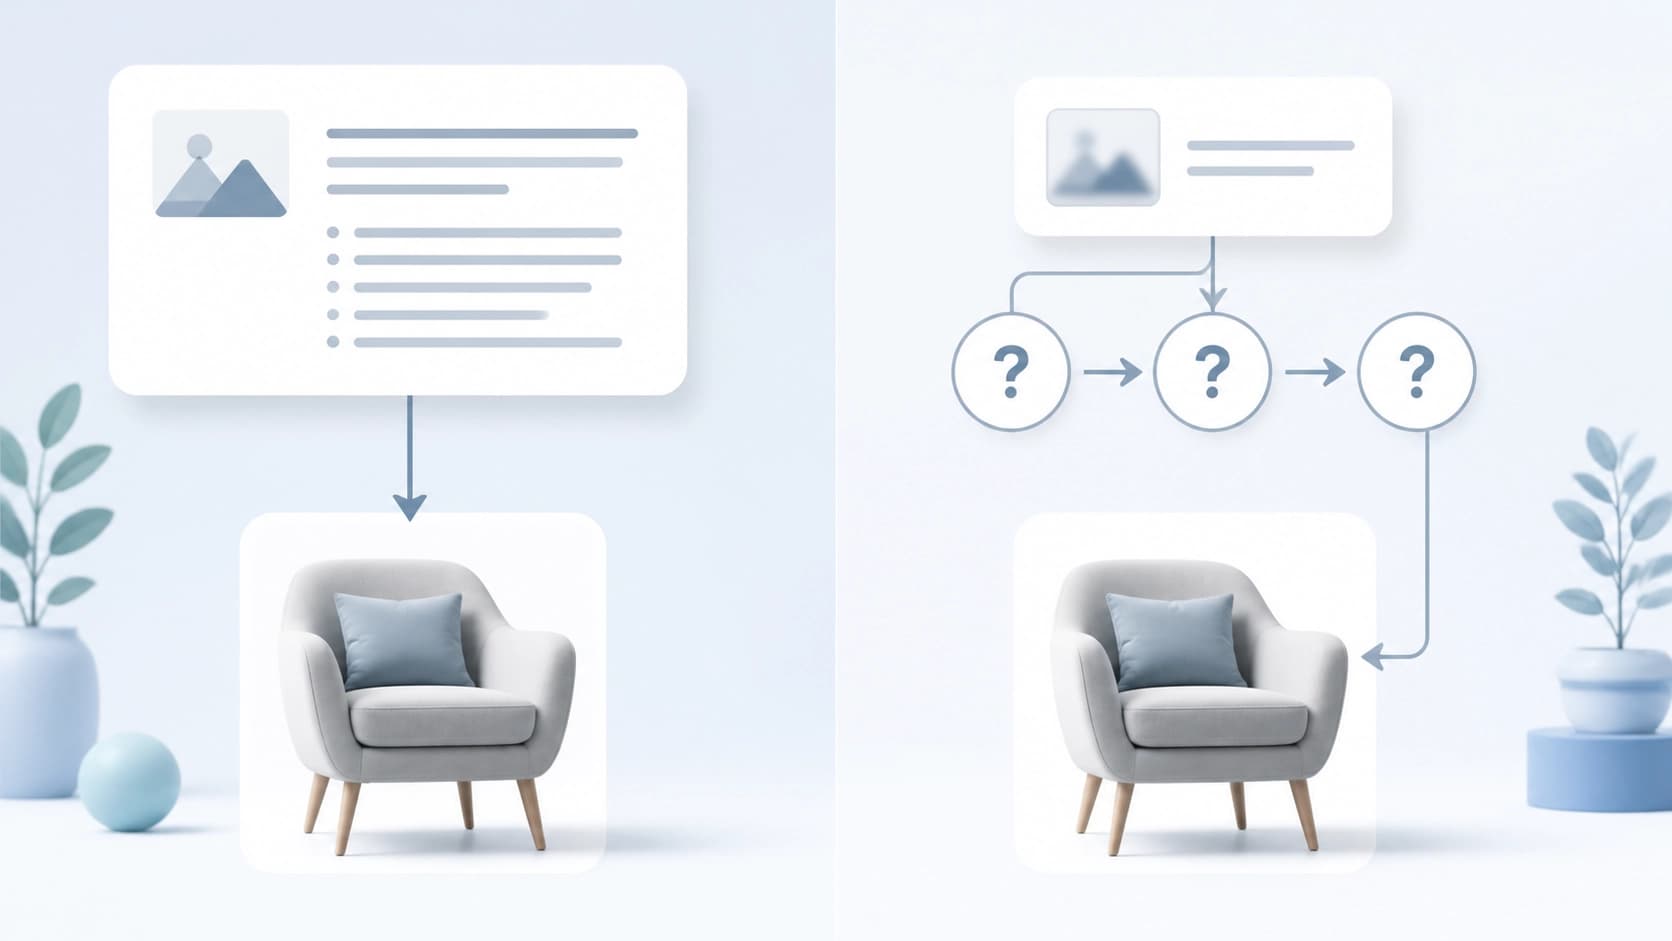
La idea clave no es medir la precisión «en promedio», sino regular de forma gradual cuánta información sobre el objetivo se proporciona de antemano y cuánta debe obtener el modelo por sí mismo. En un extremo de la escala, la tarea apenas se distingue de una prueba unipaso habitual: la descripción es detallada y el objetivo es evidente. En el otro, no existe formulación inicial alguna, y todo lo que el modelo sabe sobre el objeto buscado debe extraerlo de sus propias preguntas aclaratorias.
Esta construcción permite separar la habilidad de reconocimiento de la habilidad de mantener un diálogo. Un modelo que encuentra perfectamente un objeto con una pista precisa puede fracasar por completo cuando la pista debe armarse pieza a pieza.
Cuatro contextos y cuatro protocolos
El entorno experimental se apoya en cuatro contextos visuales cercanos a escenarios humanos y en cuatro protocolos de interacción distintos. Esto es importante: el resultado no se reduce a una única configuración afortunada o desafortunada. De paso, se comprobó quién formula exactamente la descripción —una persona u otro modelo—, así como la influencia del volumen de razonamiento, los intentos repetidos y el cambio de proveedor de descripciones. Los patrones de los que se habla más abajo se reprodujeron en todas estas variantes.
Dónde se rompe exactamente
La brecha con el ser humano se mantiene en todos los protocolos
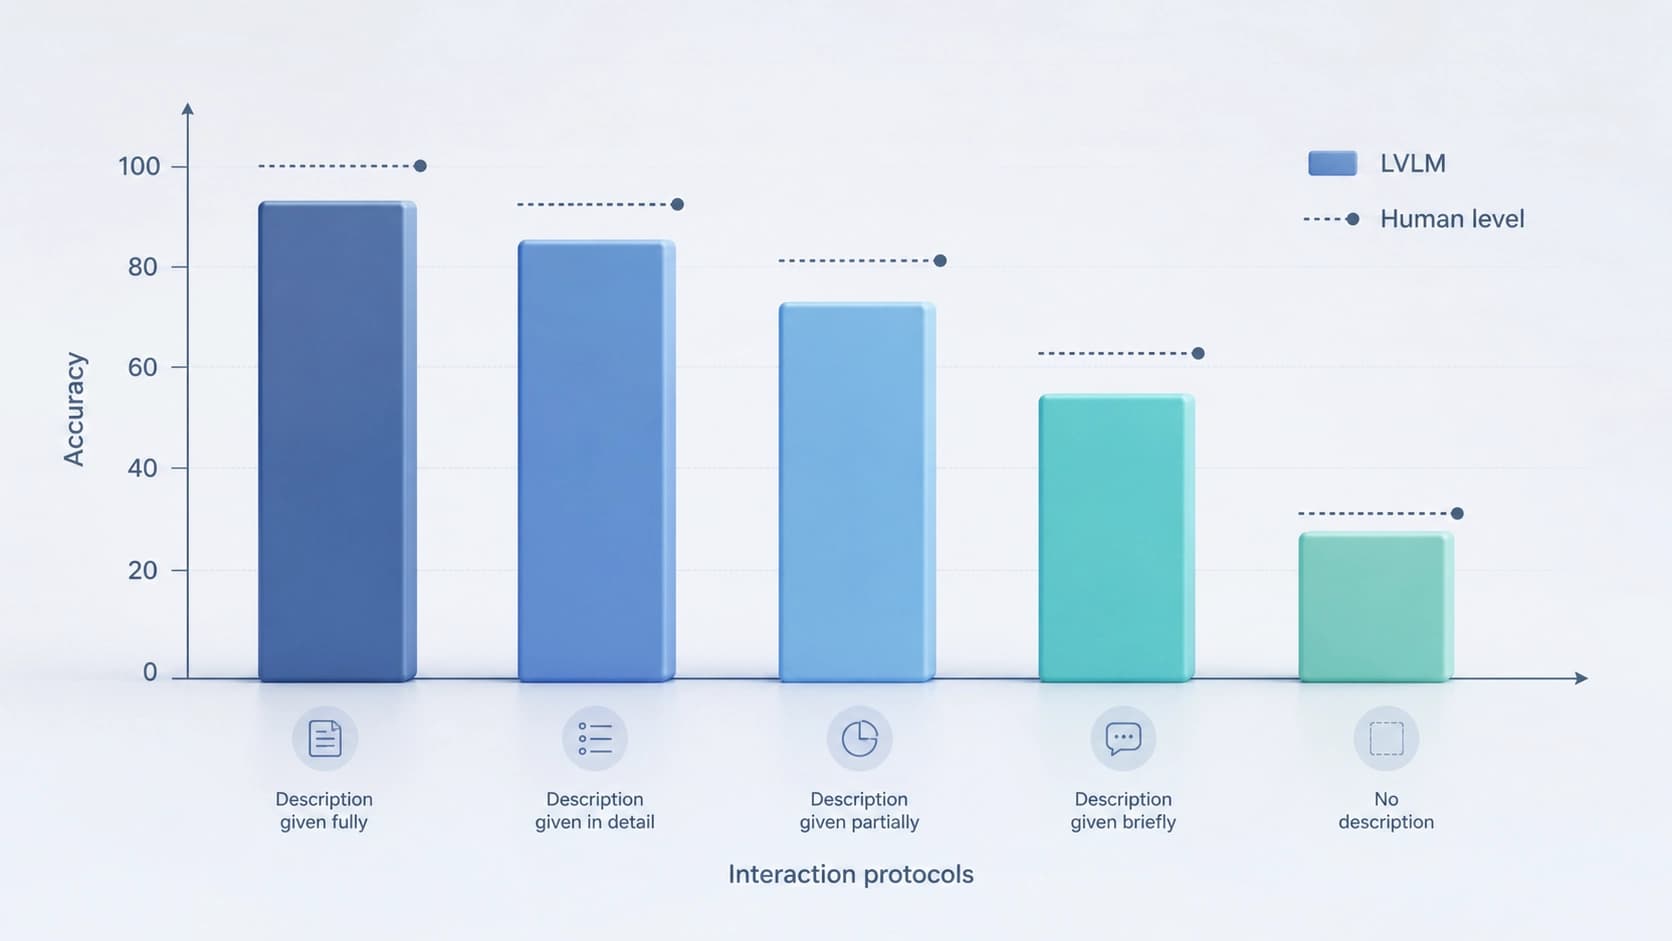
La conclusión principal no es alegre: en ninguno de los modos los actuales grandes modelos visuales-lingüísticos se acercaron a los indicadores base humanos. La brecha persiste tanto cuando la tarea parece casi trivial como cuando exige un diálogo real. No se trata de unos pocos puntos porcentuales, sino de una diferencia cualitativa en fiabilidad.
Lo peor es cuando no hay descripción alguna
Los resultados más bajos se registraron en el escenario donde falta la formulación inicial del objetivo. El modelo debe construir por sí mismo la hipótesis sobre qué buscar, hacer preguntas y, a partir de las respuestas, acotar el área de búsqueda. Esto ya no va de reconocimiento, sino de comportamiento proactivo: hay que decidir por cuenta propia que falta información y formular una consulta que cubra esa carencia.
Aquí se manifiesta el fallo que da título al trabajo: mirar, el modelo sabe; preguntar, no. O bien apuesta por la conjetura, o bien plantea preguntas que no aclaran nada.
La aclaración funciona, pero no siempre
La interacción no es inútil. Cuando una pregunta aclaratoria corrige o complementa la descripción inicial, la precisión aumenta notablemente. Es decir, el mecanismo de diálogo está presente en el modelo y aporta beneficios, pero solo en el papel de editor de la formulación ajena. En cuanto la formulación debe crearse desde cero, la ventaja desaparece.
La confianza por delante de la precisión
Una línea de análisis aparte es la calibración. Los modelos declaran sistemáticamente una confianza superior a la que confirma su precisión real. En la práctica, esto significa que por la respuesta del modelo no se puede juzgar si merece confianza: tanto la elección correcta como la incorrecta van acompañadas de un tono igual de animoso.
Para las aplicaciones, esto es más peligroso que simples errores. Si el sistema se equivoca pero señala honestamente su incertidumbre, se le puede volver a preguntar o llamar a una persona. Si se equivoca con aire convencido, no es posible incorporar esa red de seguridad.
Por qué la tarea es más difícil de lo que parece
La orientación visual interactiva requiere el funcionamiento simultáneo de tres mecanismos:
- emparejamiento visual — vincular las palabras con los objetos de la imagen, incluidas las relaciones espaciales y las propiedades;
- búsqueda de información — entender qué datos faltan y obtenerlos mediante una pregunta, no mediante el ensayo y error;
- síntesis — reunir respuestas dispersas en una única hipótesis y no perderla por el camino.
Cada habilidad por separado existe en mayor o menor medida en los modelos actuales. Lo que se rompe es la articulación entre ellas: lo visto no se convierte en pregunta, y la respuesta a una pregunta no reconfigura la imagen del mundo.
Qué significa esto en la práctica
Si construyes un producto sobre la base de un modelo multimodal —digamos, GPT-4o o cualquier otra API con soporte de imágenes—, las conclusiones del trabajo se traducen fácilmente en decisiones de ingeniería:
- No confíes en la primera descripción. Si el usuario formula una consulta de forma vaga, prevé un ciclo de aclaraciones, no una única consulta-respuesta.
- No te fíes de la confianza declarada. Es mejor construir la calibración sobre tu propio etiquetado para una tarea concreta, y no sobre la autoevaluación del modelo.
- Diseña las preguntas por el modelo. Si el sistema no sabe entender por sí mismo qué le falta, el papel de preguntador tendrá que asumirlo una capa de lógica externa.
- Prueba con tu propio déficit de información. Es útil comprobar cómo se comporta el pipeline exactamente en los modos en los que, según los datos de los autores, la precisión se desploma.
Conclusión
El trabajo constata no una ausencia de capacidades, sino una discordancia de habilidades. Los modelos ven lo suficiente para responder a preguntas bien planteadas, pero no comprenden la situación lo bastante como para plantearlas ellos mismos. Mientras esa brecha no se cierre, la orientación visual interactiva seguirá siendo una tarea en la que el ser humano continúa siendo el eslabón más fiable del diálogo.


