
Cómo empezar con DALL-E 3: una guía paso a paso de la configuración a imágenes terminadas
Red neuronal OpenAI crea imágenes de descripciones de texto. Rompemos cómo obtener acceso, elaborar un aviso detallado y descargar el resultado, así como dónde se pueden encontrar opciones gratuitas.
¿Qué es DALL-E 3 y dónde funciona?
DALL-E 3 es la última versión del modelo de imagen generativa de OpenAI. Se convierte en descripciones de texto simples en imágenes hechas listas, y lo hace notablemente más exacto que sus predecesores. La diferencia clave es la integración integrada con una interfaz de chat: no sólo puede enviar un mensaje, sino también discutirlo con la red neuronal, aclarar detalles y guiar el proceso de generación paso a paso. Como resultado, el modelo se transforma de un generador simple en un ilustrador de pleno derecho con un modo de conversación.
El acceso al modelo está disponible mediante planes pagados. Para los usuarios individuales, la opción más obvia es una suscripción de ChatGPT Plus a $20 por mes. Le permite crear hasta 50 imágenes cada tres horas, haciéndolo adecuado tanto para la experimentación regular como para tareas comerciales. Las empresas pueden inscribirse en el plan empresarial, donde se discuten los términos individualmente. Si aún no quieres pagar, hay un camino más ligero — sitios web gratuitos de terceros que trabajan con el modelo. Normalmente tienen un límite de generación diaria, pero es suficiente para un primer intento.
Conectarse y empezar a generar
Elija su método de acceso
Primero, decide dónde trabajarás. Si necesita el conjunto completo de funciones y la integración de chat sin costura, suscriba en el sitio web oficial de OpenAI. Después del pago, acceso a DALL-E 3 se abrirá en su cuenta — el modelo ya se integrará en la interfaz de chat. Para una prueba rápida sin registro, un sitio como dalle3.org funciona bien. Tales plataformas generalmente no requieren una tarjeta bancaria, pero el número de intentos por día es limitado — todavía, puede averiguar si este estilo de interacción le conviene.
Inicie sesión en su cuenta y envíe su primera solicitud
Los suscriptores sólo necesitan ir al sitio web de ChatGPT y comenzar una nueva conversación. Allí verás un campo de entrada regular - ahí es donde escribes tu mensaje. La interfaz también le permite preguntar al modelo para ayudar con la redacción: escribir "come up with a detailed description of a scene with an astronaut in a blooming forest" — y la red neuronal sugerirá una versión ampliada de la solicitud, que luego puede enviar directamente a la generación. La primera imagen aparecerá dentro de unos segundos, después de lo cual puede guardarla o seguir refinando los detalles.
Cómo crear impulsos y refinar el resultado
Los detalles más importantes
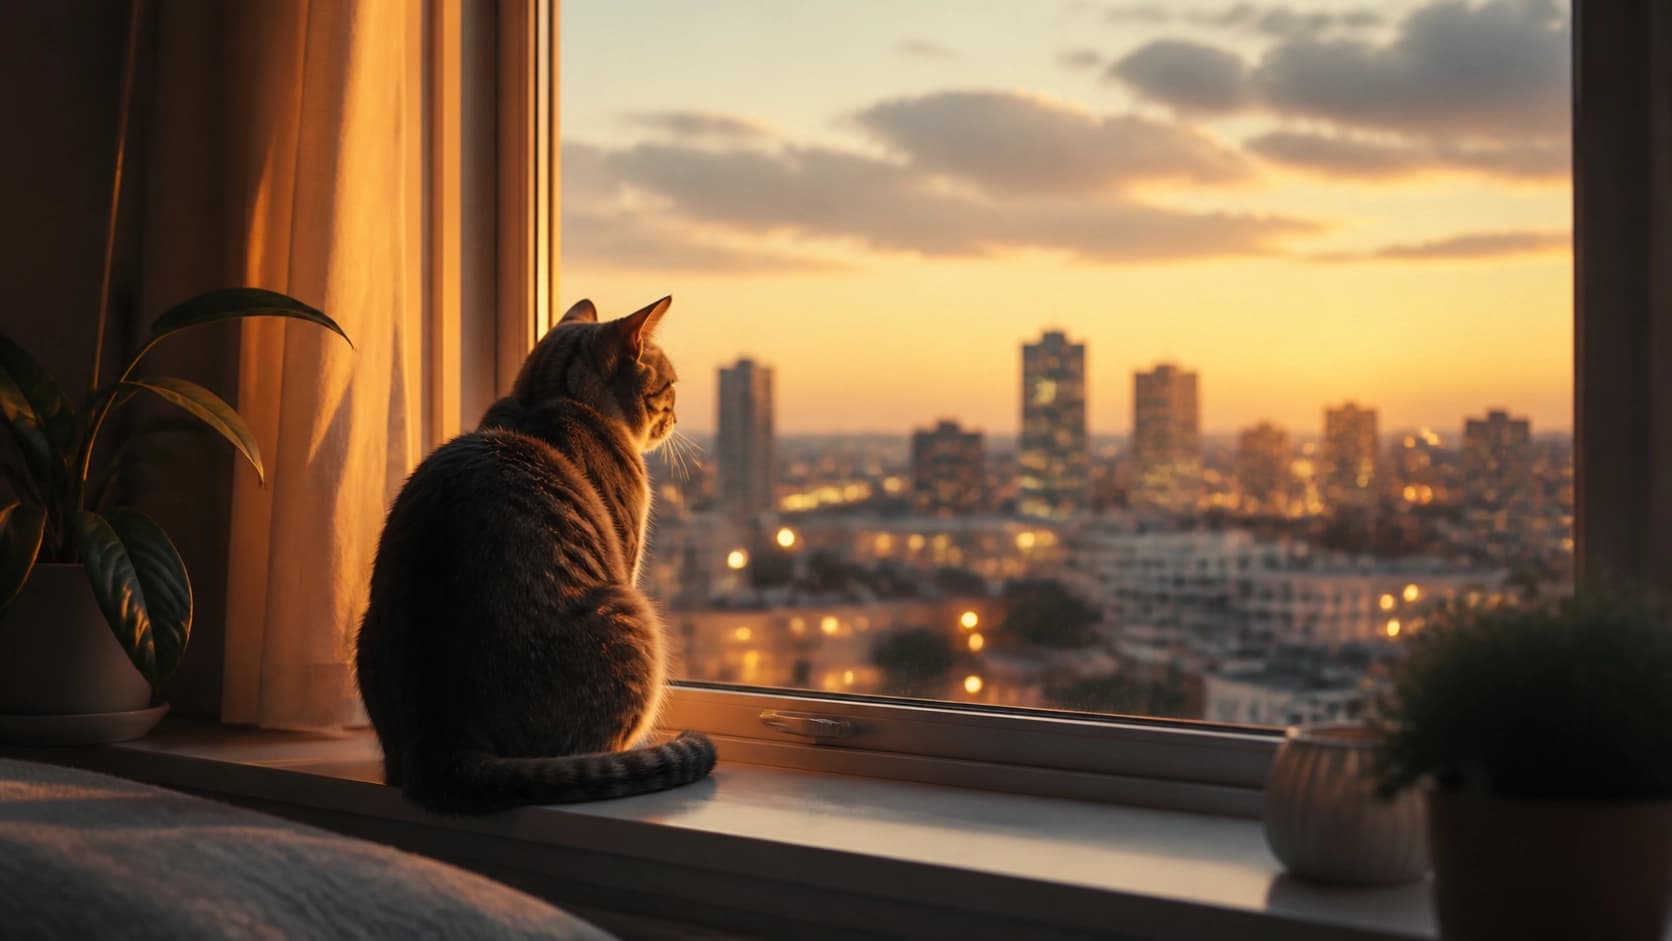
DALL-E 3 entiende bien las descripciones ricas, pero sin detalles el resultado a menudo resulta borroso. Especifique colores, tamaños, materiales, iluminación, colocación de objetos, e incluso estado de ánimo. En lugar de "draw a cat", es mejor escribir "un gato gris rayado acostado en una ventana, luz nocturna, ciudad fuera de la ventana, estilo de pintura digital". El modelo convierte estos detalles en elementos visuales precisos. Si no estás seguro de cómo estructurar un aviso, puedes pedir ayuda a ChatGPT, lo que significará una breve solicitud en un escenario detallado, y habrá menos rondas de redo.
Refining and downloading
Por defecto, DALL-E 3 produce dos variantes de imagen para cada solicitud. Si uno de ellos ya funciona —grande, puede moverse directamente a descargar. Pero más a menudo querrás cambiar algo: color, fondo, postura de carácter o composición. En lugar de empezar desde cero, escriba en la conversación qué arreglar, y el modelo redibujará la imagen con sus ediciones en mente. Puedes mantener este diálogo en marcha hasta obtener el resultado que quieras. Una vez que la imagen esté lista, haga clic en el icono de descarga — el archivo se guardará en su dispositivo de alta calidad.
Dónde utilizar imágenes generadas
La gama de aplicaciones para tales imágenes es prácticamente ilimitada. En marketing, se utilizan para redes sociales, banners publicitarios y anuncios de eventos. Los diseñadores los utilizan como base para conceptos, presentaciones y simulacros. Las generaciones también se utilizan para crear impresiones sobre ropa, tazas, tarjetas de felicitación y otros productos personalizados.
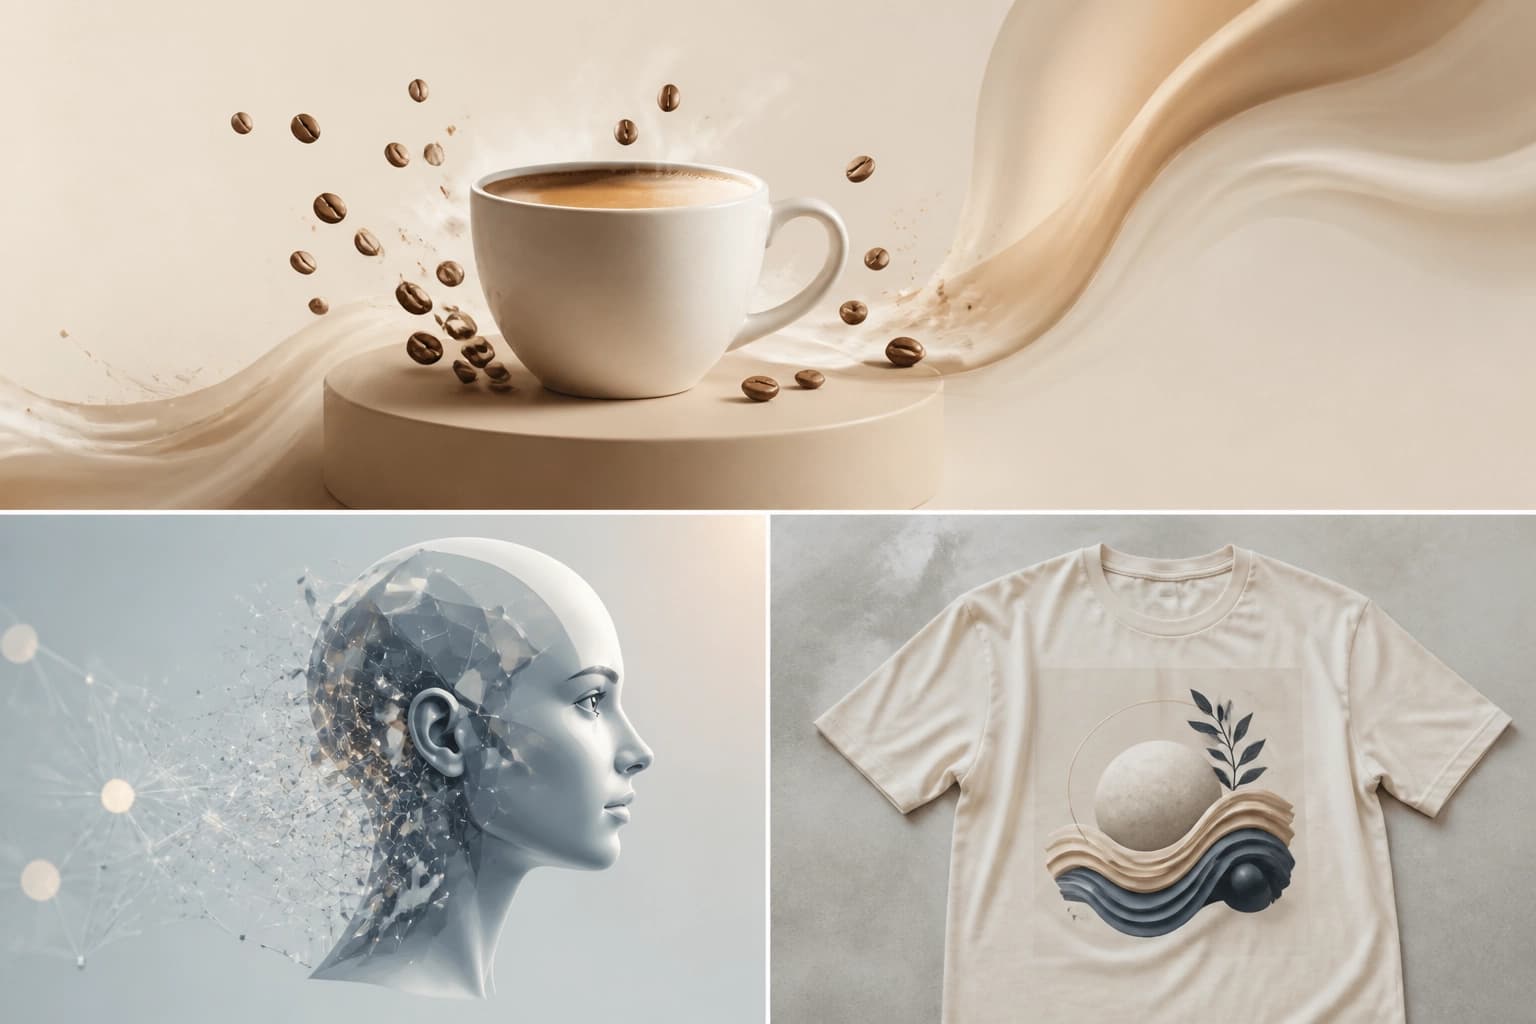
En la educación, estas imágenes ayudan a crear materiales visuales para lecciones y cursos, y en medios y entretenimiento — para ilustrar artículos, vídeos, cubiertas y arte de concepto de juego. Lo principal es comprobar siempre si el resultado coincide con la tarea, y no dude en refinarlo en la conversación, porque es precisamente la capacidad de ajustarse de forma interactiva que hace que trabajar con este modelo sea tan conveniente.
Preguntas frecuentes
Material similar
Todos los materiales
Método GoldiMask para el ajuste fino de modelos de lenguaje de difusión: selección del contexto y ponderación de objetivos
Este trabajo presenta GoldiMask, un enfoque de ajuste fino supervisado para modelos de lenguaje con difusión discreta que selecciona los tokens visibles mediante la maximización aproximada de una función submodular y asigna pesos a los objetivos restantes según su utilidad para el entrenamiento. Los experimentos con varios modelos y conjuntos de datos muestran un aumento de la precisión media y mejoras en tareas de razonamiento lógico y programación, además de menos iteraciones de decodificación paralela en GSM8K y MATH-500 con una calidad similar.
30 octubre 2026
MSEB de Google Research: implementación de codificadores de audio conforme al contrato del benchmark y evaluación en cuatro clases de tareas
Análisis práctico del paquete mseb==0.1.0: arquitectura por capas de types, encoder y evaluators, dos codificadores de demostración sobre un corpus sintético y llamada directa a métricas de clasificación, agrupamiento, búsqueda y segmentación. El material muestra cómo adaptar un modelo propio al MultiModalEncoder abstracto, interpretar el formato SoundEmbedding y crear TaskMetadata para enviarlo posteriormente a un benchmark.
10 octubre 2026
LoRA de base cero para el ajuste fino de LLM tras el RL sin perder las capacidades de razonamiento
Los autores proponen un método de adaptación paramétricamente eficiente para modelos entrenados mediante aprendizaje por refuerzo, en el que las actualizaciones de LoRA se proyectan en un espacio nulo aproximado de las activaciones de razonamiento. Este enfoque permite conservar una precisión de razonamiento comparable a la del modelo antes del ajuste fino, sin sacrificar la calidad de adaptación de la LoRA convencional.
5 octubre 2026