Por qué el SFT después del RL amenaza el razonamiento
El aprendizaje por refuerzo desarrolla las capacidades de razonamiento de los modelos de lenguaje grandes. Este enfoque se ha convertido en una forma eficaz de realizar el posentrenamiento de los LLM. El ajuste fino supervisado posterior adapta el modelo pos-RL a nuevos ámbitos de conocimiento o tipos de comportamiento. Este SFT puede sobrescribir gravemente las capacidades adquiridas.
Enfoques existentes para reducir el olvido:
- repetición de experiencias;
- inicialización especializada;
- optimización restringida con proyección del gradiente.
Estos métodos ofrecen una conservación limitada de las capacidades o requieren un esfuerzo computacional adicional considerable. Criterio práctico: para un modelo pos-RL, se elige un método que reduzca el riesgo de sobrescribir el razonamiento.
El espacio nulo como recurso para la adaptación
Los autores muestran que las activaciones relacionadas con el razonamiento se concentran en subespacios de baja dimensión. Queda una capacidad considerable en el espacio nulo para la adaptación. Los espacios nulos aproximados se pueden estimar de forma fiable con un número reducido de ejemplos.
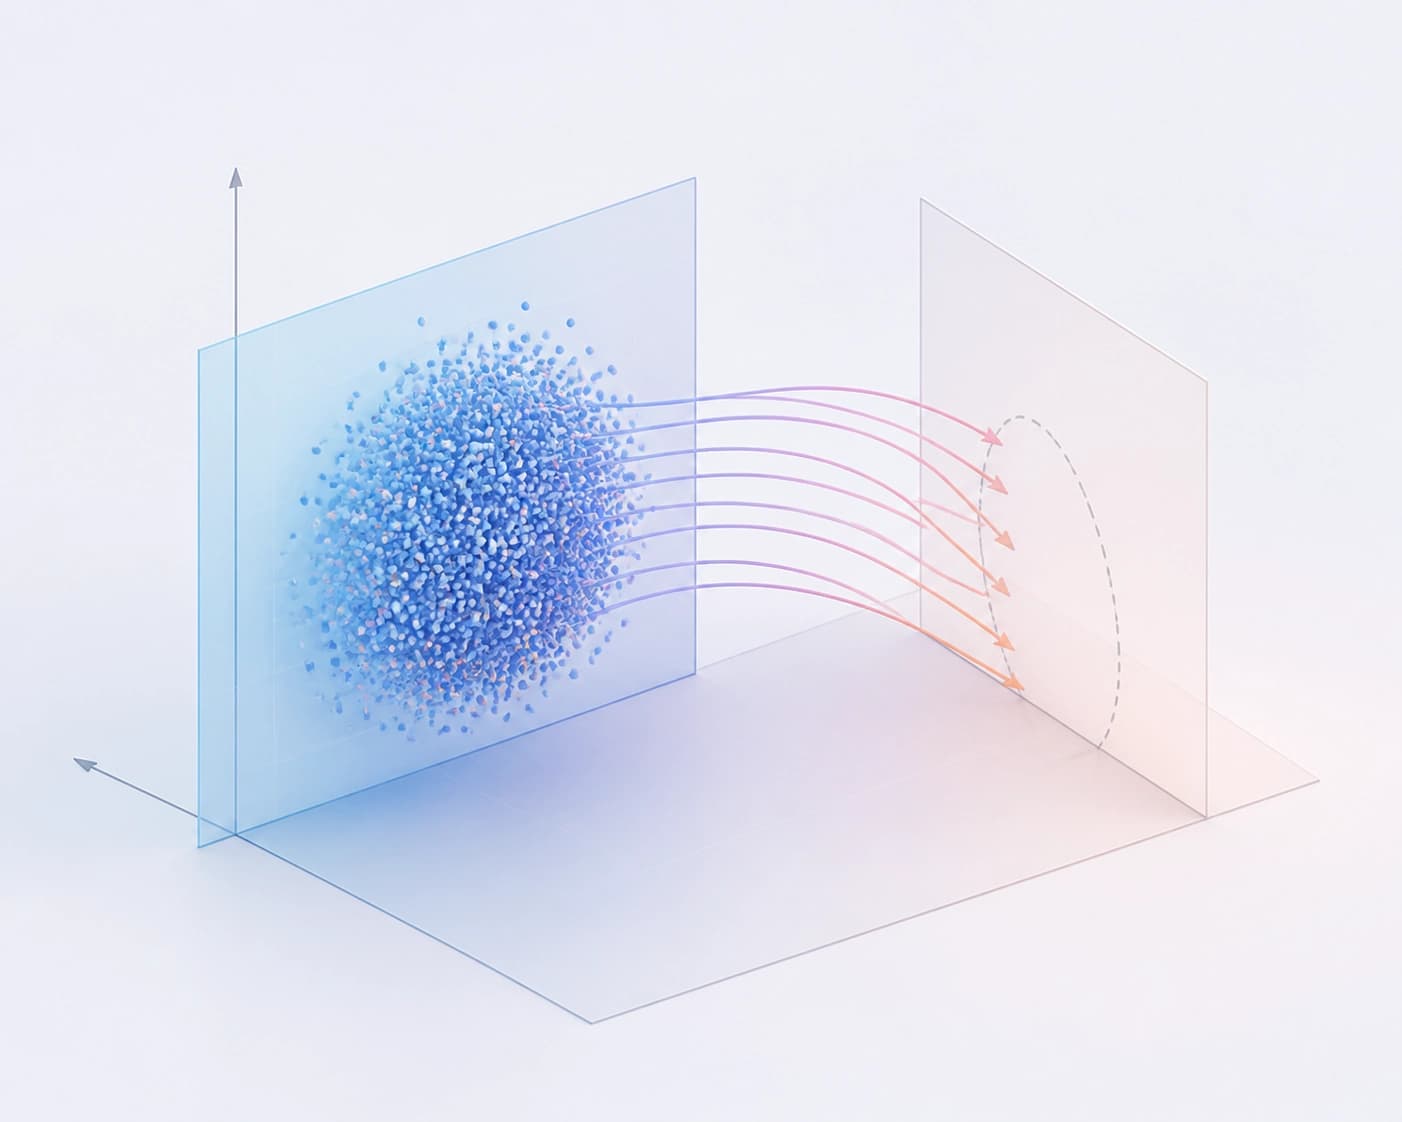
Criterio práctico: un método que construye actualizaciones en el espacio nulo aprovecha la capacidad disponible. No afecta a las activaciones del razonamiento.
Cómo funciona NB-LoRA
Null-Basis Low-Rank Adaptation (NB-LoRA) es un método de adaptación eficiente en parámetros para LLM pos-RL. Se propuso en el artículo arXiv:2609.25618. El método conserva las capacidades de razonamiento adquiridas.
Etapas de funcionamiento:
- A partir de las activaciones del razonamiento, se construye una base nula aproximada fija.
- Las actualizaciones de LoRA se reparametrizan mediante esta base.
- La conservación del razonamiento se formula como una restricción para preservar los estados ocultos a nivel de capa.
- La restricción se mantiene durante todo el ajuste fino.
Criterio práctico: se elige NB-LoRA cuando se necesita realizar SFT y conservar el razonamiento del modelo pos-RL.
Comparación con los enfoques existentes
La tabla compara los mecanismos y las características.
| Criterio | Enfoques existentes | NB-LoRA |
|---|---|---|
| Mecanismo | Repetición de experiencias, inicialización especializada, optimización restringida con proyección del gradiente | Reparametrización de LoRA mediante una base nula aproximada fija |
| Característica | Conservación limitada de las capacidades o esfuerzo computacional adicional considerable | Restricción para preservar los estados ocultos a nivel de capa |
Criterio práctico: si la prioridad es conservar el razonamiento, NB-LoRA ofrece una restricción integrada. Los enfoques existentes obligan a elegir entre una conservación limitada y un esfuerzo computacional adicional.
Resultados experimentales y criterio de selección
Los experimentos abarcan varios LLM entrenados con RL y diversas tareas posteriores. NB-LoRA muestra una calidad de adaptación al nivel de la LoRA estándar. El método conserva la precisión del razonamiento cerca del nivel anterior al ajuste fino. La conservación también se mantiene en los benchmarks de razonamiento reservados.
Criterio práctico: para los LLM pos-RL en los que el SFT amenaza el razonamiento, NB-LoRA es una opción que conviene probar en las propias tareas.