Por qué los agentes necesitaban otra medición más
La mayoría de los benchmarks de agentes responden a preguntas claras: si el modelo eligió la herramienta correcta, si armó bien los argumentos, si llegó al resultado esperado. Casi todas esas mediciones se construyen en torno a la ejecución secuencial: una llamada tras otra, sin prisa ni competencia por recursos.
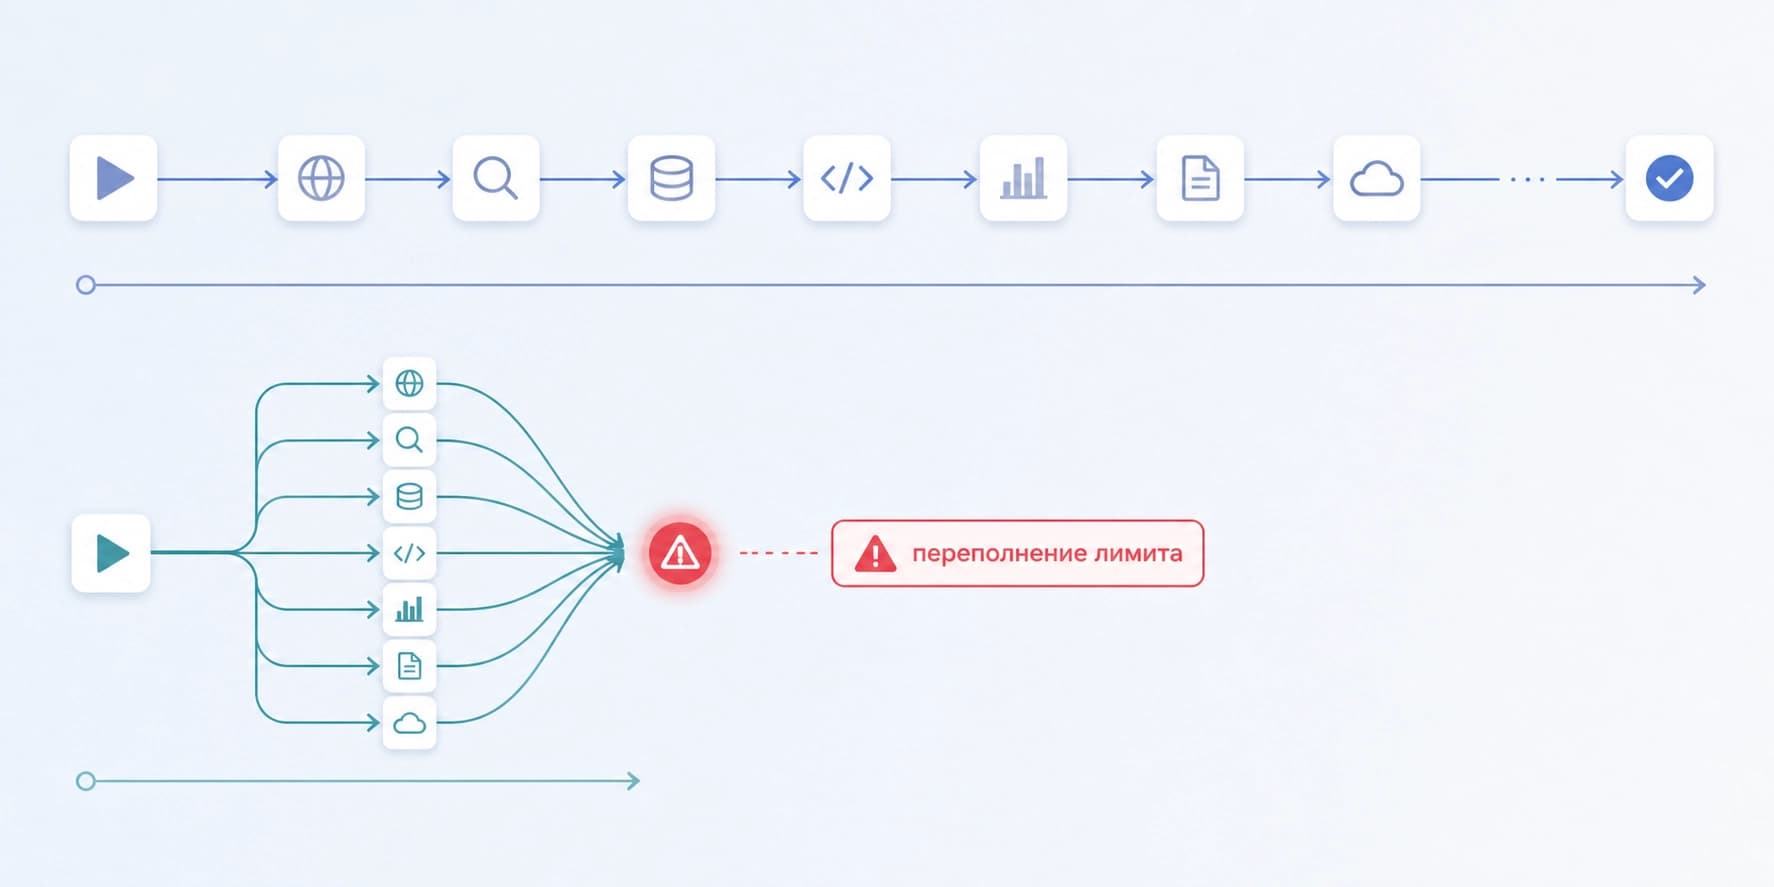
La explotación se ve distinta. Para mantenerse dentro de una latencia aceptable, el agente tiene que lanzar llamadas independientes en paralelo. Pero el paralelismo sin tener en cuenta los límites choca con otro muro: cuotas agotadas, memoria desbordada, un servicio externo caído.
PeakBench trata justamente ese punto ciego. Los autores Zhi-Kai Chen, Xu-Xiang Zhong, Song-Yan Li, De-Chuan Zhan y Han-Jia Ye lo describen en el preprint arXiv:2608.24509 (v1 del 25 de agosto de 2026, categorías cs.AI y cs.SE); prometen publicar el código junto con el artículo.
La idea clave de la que nace todo el trabajo: un agente tiene dos formas de fracasar, y son opuestas. La ejecución secuencial es segura pero lenta: los límites no se superan simplemente porque nada ocurre al mismo tiempo. La paralela sin considerar los recursos es rápida, pero provoca desbordamientos que se podrían haber evitado con facilidad. Entre esos dos polos está eso que nadie midió del todo bien.
Qué es el benchmark
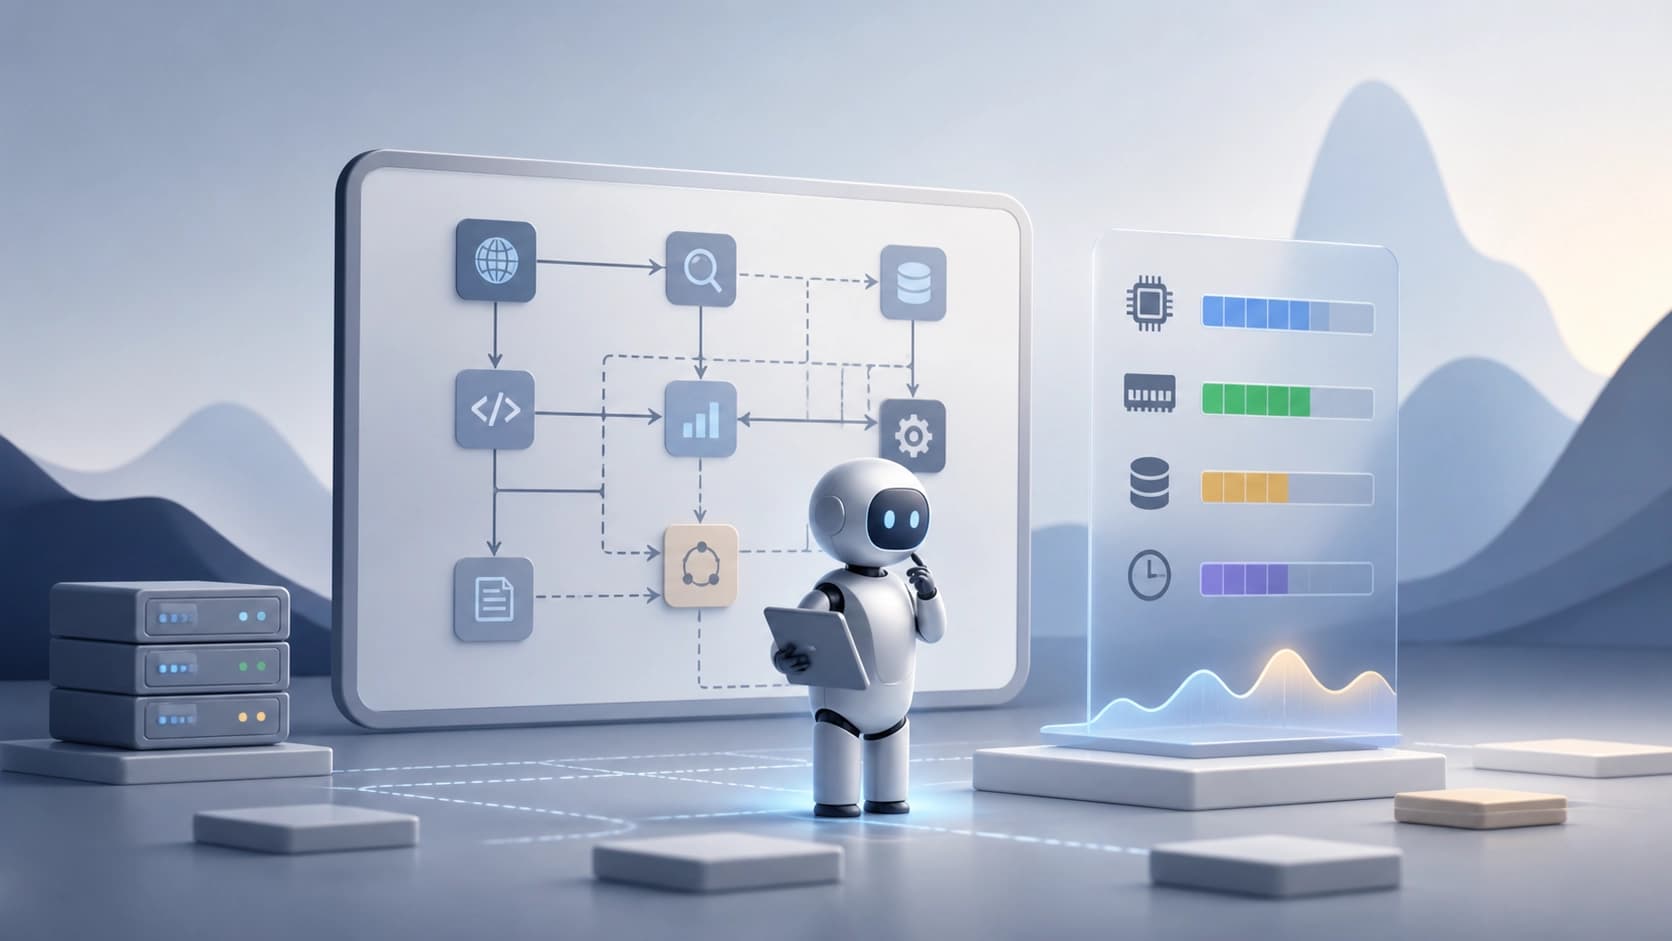
En lugar de tareas estáticas con respuestas de referencia, aquí se usan flujos de trabajo multiherramienta ejecutables. Cada uno tiene dos añadidos importantes: anotaciones de dependencias que muestran qué pasos están realmente conectados entre sí, y perfiles de recursos medidos: cuánta memoria, tiempo o cuota consume una llamada concreta.
Esa construcción cambia el objeto mismo de la evaluación. La pregunta «¿se obtuvo la respuesta correcta?» pasa a un segundo plano, y al primero pasa la pregunta «¿cómo distribuyó el agente el trabajo en el tiempo y no se pasó del presupuesto?».
Planificación lógica frente a física
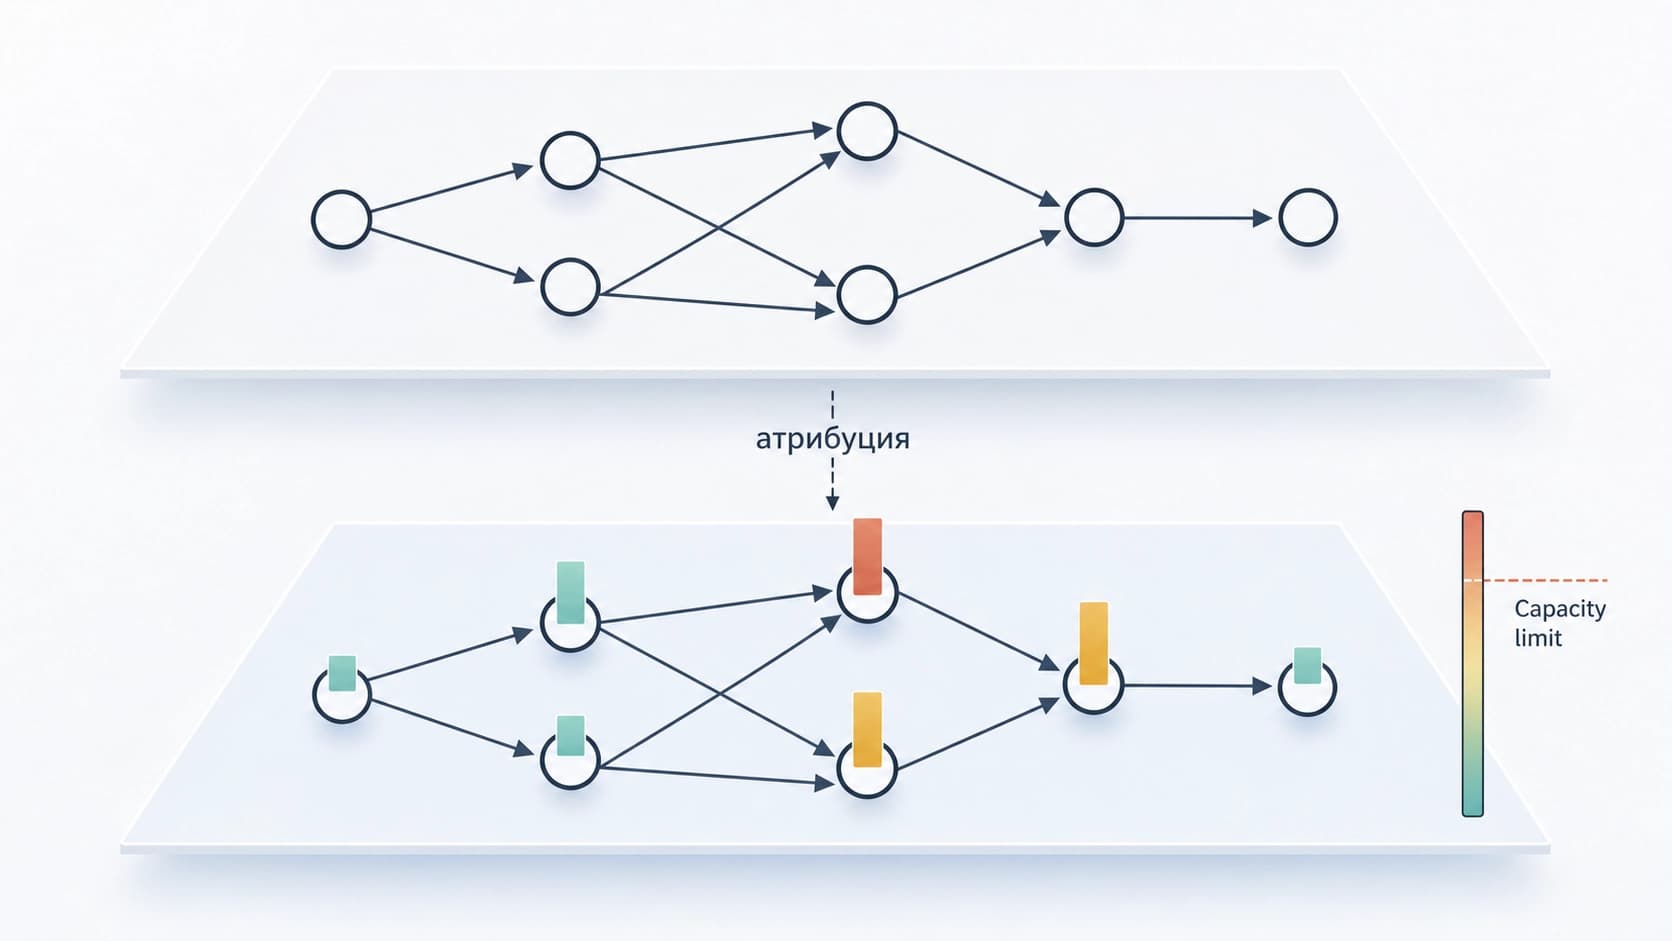
La dificultad central al evaluar este tipo de procesos es la atribución. Cuando una ejecución se desmorona, no queda claro qué es exactamente lo que falló: si el agente interpretó mal las dependencias, o las interpretó bien pero no contó los recursos disponibles, o ambas cosas a la vez. Meter todo en una sola métrica de éxito significa perder lo más útil.
Por eso la evaluación se divide en dos partes. Una dimensión se ocupa de la planificación lógica: el orden de los pasos, la corrección de las dependencias, la ausencia de vínculos inventados. La otra se ocupa de la planificación física, es decir, del cronograma con las restricciones reales. Estas dimensiones tienen sus propias métricas, y un fallo en una no enmascara el éxito en la otra.
Orden incorrecto y presupuesto incorrecto son enfermedades distintas
El esquema de dos partes no busca una taxonomía bonita, sino el diagnóstico. Si el agente se equivocó a nivel de lógica, de nada sirve hablarle del tamaño de la cuota: no entendió qué depende de qué. Si la lógica está bien pero la ejecución falla, el problema está en el planificador o en cómo se le comunicó al agente los recursos disponibles.
La conclusión práctica para quienes construyen sistemas de agentes: antes de arreglar algo, conviene entender a cuál de las dos capas pertenece el fallo. El prompt engineering, el entrenamiento con trayectorias y el ajuste de herramientas curarán averías completamente distintas.
Resultado principal: una lógica cuidadosa no protege de la sobrecarga
La conclusión más incómoda del trabajo suena así: una planificación lógica sólida no garantiza ni una ejecución segura ni una eficiente en condiciones de recursos limitados. El agente puede construir un grafo de dependencias impecable y, aun así, tumbar el sistema lanzando a la vez todo lo que no está conectado por aristas.
Revelar los recursos reduce el número de desbordamientos evitables
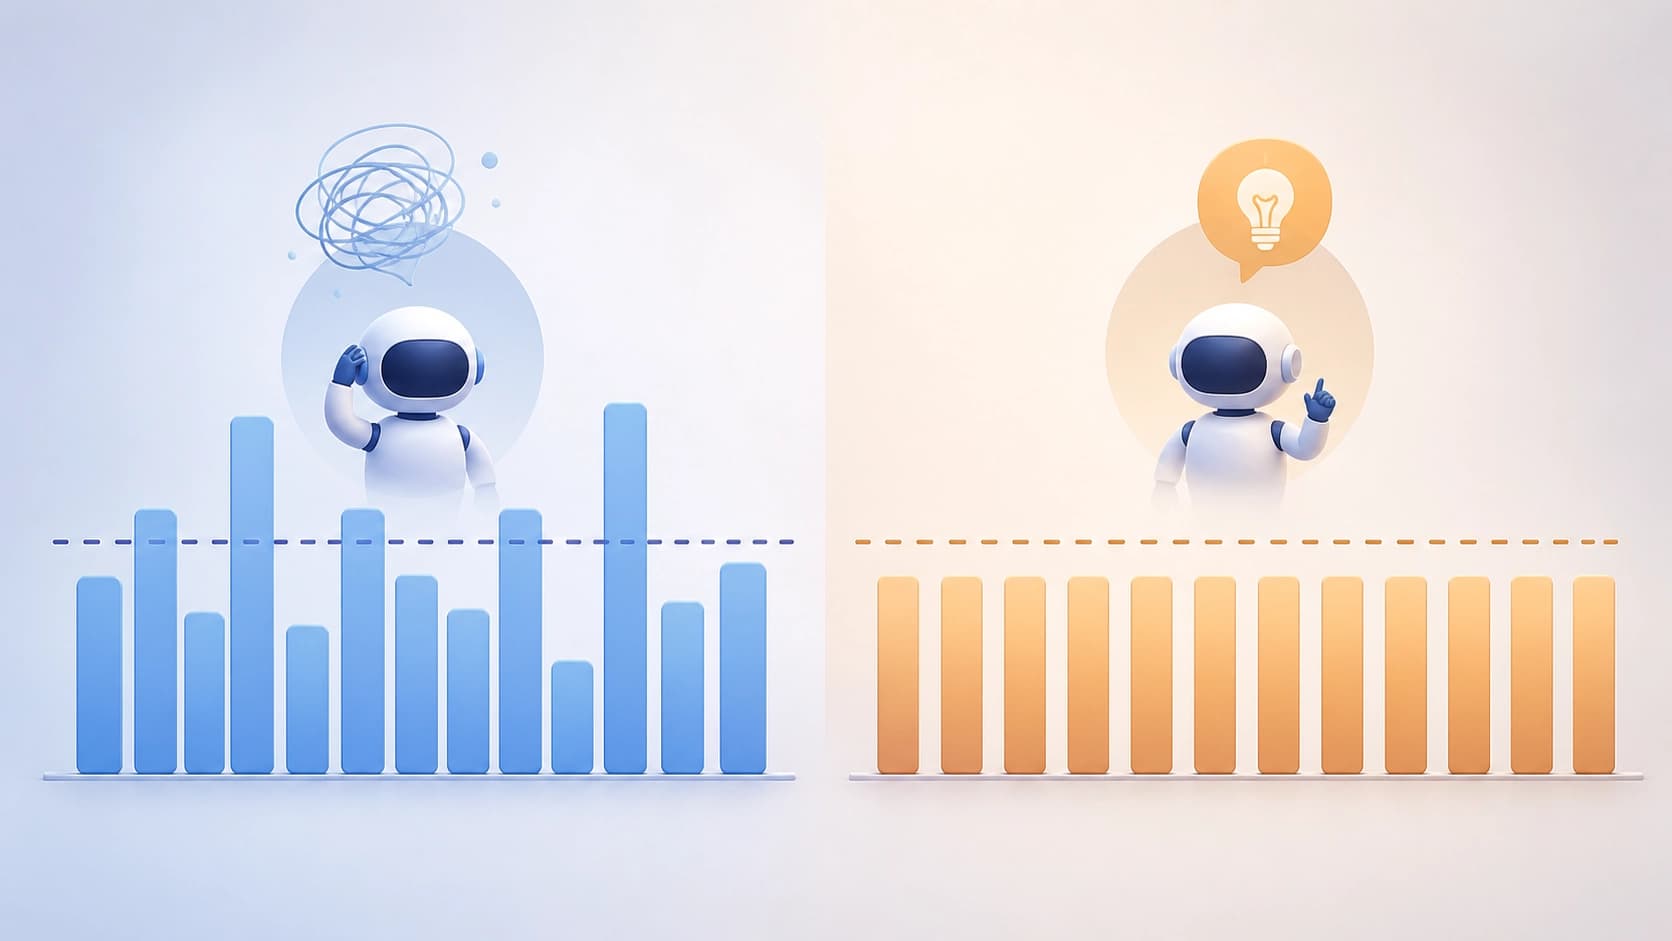
La segunda observación: si se le da al agente información sobre los recursos disponibles, la cantidad de desbordamientos evitables baja y la utilización sube. No es magia ni una arquitectura nueva: simplemente en el contexto no solo entran las descripciones de las herramientas, sino también los presupuestos que hay que respetar.
Aquí es importante no sobreestimar el efecto. Se trata de que la transparencia sobre los recursos es una intervención barata y funcional, no de que resuelva el problema por completo: el agente todavía tiene que gestionar esa información con criterio.
A quién le sirve
El benchmark está pensado como un banco de pruebas para diagnosticar el comportamiento de los agentes consciente de los recursos, y ese es su propósito principal. Más que arrojar una puntuación final, muestra dónde exactamente se rompe el modelo: en la comprensión de las dependencias o en la disciplina de gasto.
De ahí surgen varios escenarios de uso. Para quienes desarrollan frameworks de agentes: una forma de probar el planificador antes de producción, y no después de un incidente. Para investigadores: un planteamiento reproducible para experimentar con presupuestos en el contexto. Para quienes eligen un modelo para una tarea con límites estrictos: la posibilidad de ver la diferencia entre modelos que las pruebas habituales de éxito simplemente no muestran.
Qué conviene tener en cuenta
El enfoque tiene un costo de entrada evidente: los perfiles de recursos hay que medirlos y las dependencias, anotarlas. En sistemas reales los límites meten ruido, los servicios externos cambian de comportamiento bajo carga y el costo de una llamada no siempre se conoce de antemano. El cuidado de laboratorio aquí es mayor que en el campo de batalla, y no conviene trasladar las conclusiones tal cual a producción.
Pero el marco en sí es útil incluso sin el benchmark. Dos preguntas —«¿entendió bien el agente qué depende de qué?» y «¿se mantuvo dentro del presupuesto?»— tiene sentido hacérselas a cualquier sistema de agentes, aunque no se tenga a mano un banco de pruebas listo para verificarlas.