La tarea larga de un agente de código no es una sola consulta, sino decenas: llamadas al modelo, invocaciones de herramientas, ediciones de archivos, ejecuciones repetidas de pruebas. Y casi en cada una de esas ejecuciones surge la idea: ¿y si cambio de modelo ahora mismo?
Por qué el cambio sobre la marcha parece ventajoso
La economía aquí es simple. Un modelo fuerte cuesta más por token, pero razona mejor. Uno débil es más barato, pero se atasca en lo complejo. De ahí surgen dos maniobras naturales:
- Escalada — cuando el modelo barato se queda atascado, conectamos el caro y potente.
- Degradación — cuando la parte difícil ya quedó atrás, volvemos al barato para no pagar de más por la rutina.
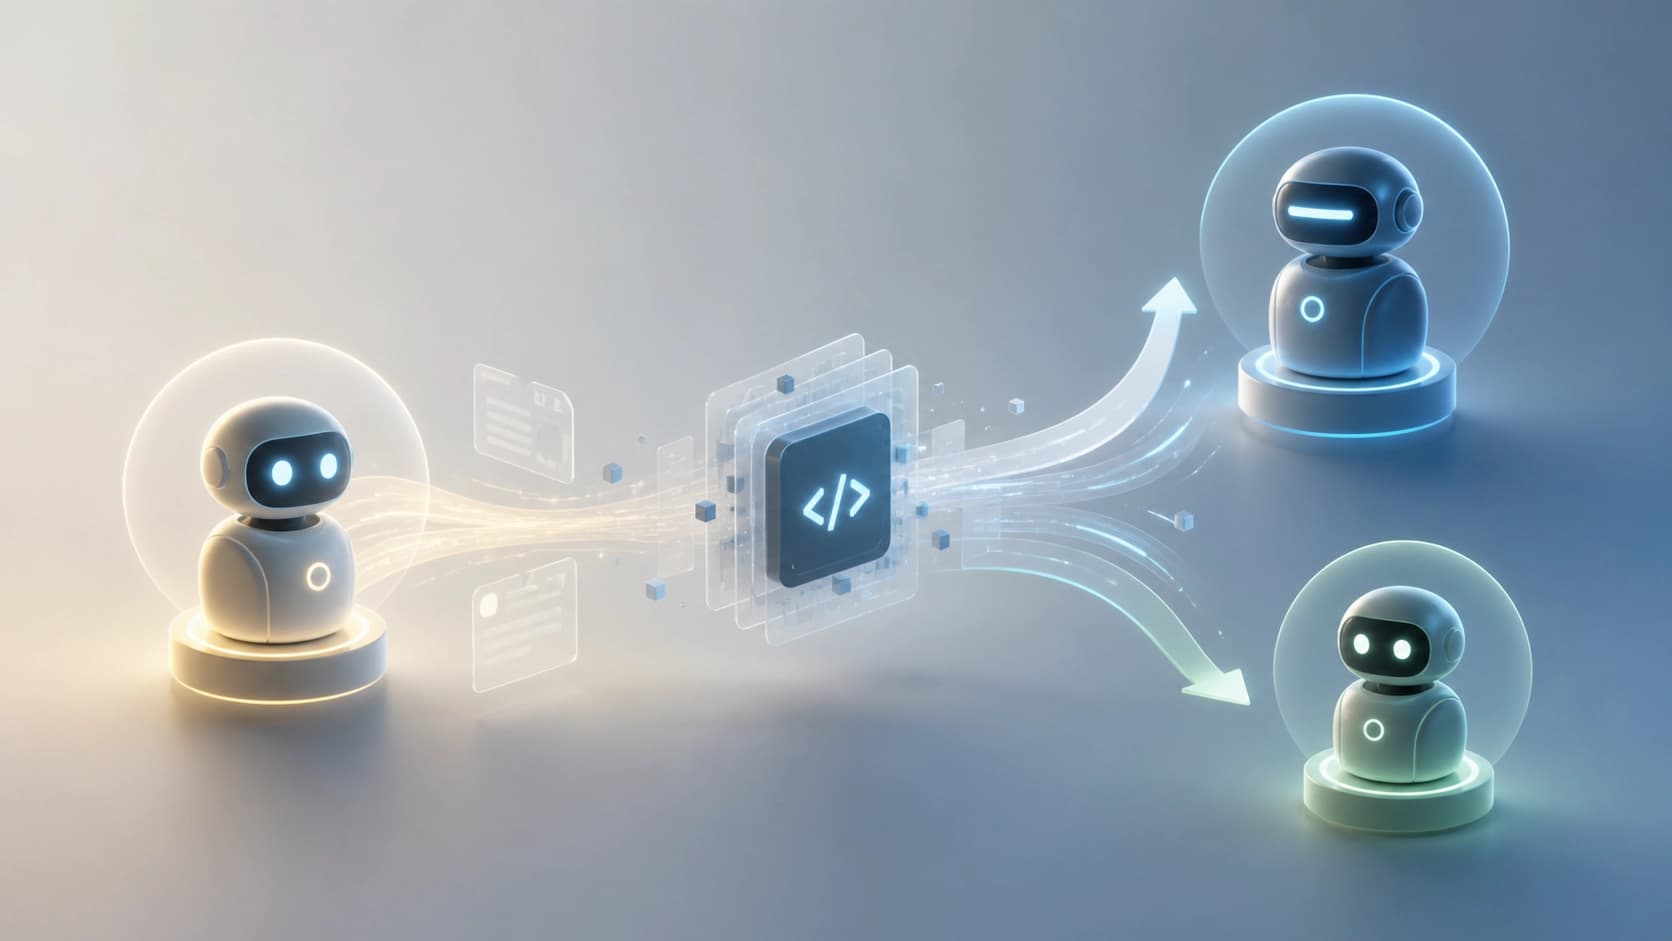
Sobre el papel, la ruta híbrida parece ideal: el modelo caro se paga solo donde realmente se necesita. Pero el agente no le transmite al siguiente modelo únicamente los archivos y el estado del repositorio. Le transmite el historial: la cadena de razonamiento, la salida de las herramientas, los intentos fallidos, las decisiones intermedias. La parte receptora continúa una trayectoria que construyó otro modelo — con otro estilo, otro grado de detalle, otras costumbres. Precisamente ese momento es el que analizan los autores del preprint «The Handoff Tax: Continuing Non-Native Trajectories in LLM Agents» (arXiv:2608.24358, 25 de agosto de 2026).
Cómo está diseñado el experimento
El trabajo se apoya en pares de modelos: baratos y menos capaces (en el texto del artículo — LC, low cost) frente a caros y más potentes (HC, high cost). Los pares se tomaron de dos familias — Claude y GPT, es decir, la verificación no se hizo con un solo proveedor, sino con dos a la vez, lo que eleva notablemente el valor de las conclusiones.
Se variaron tres cosas:
- La dirección de la transferencia — hacia arriba, a un modelo más fuerte, y hacia abajo, a uno más débil.
- El momento del cambio dentro de una tarea larga.
- El formato de transferencia del contexto — lo que los autores llaman la interfaz.
El último punto es el más interesante. Se compararon tres variantes: la transferencia completa de toda la trayectoria, la compactación (un resumen comprimido del historial) y la eliminación de la trayectoria conservando solo el estado del repositorio. En otras palabras, la pregunta era: ¿cuánto «pensamiento» ajeno vale la pena mostrarle realmente al nuevo modelo?
Resultado principal: el impuesto sobre la transferencia
La conclusión resultó aleccionadora. En la escalada, la transferencia completa del historial cierra menos de la mitad de la brecha de calidad entre el modelo débil y el fuerte — y va acompañada de un sobrecoste notable. Es decir, pagas la tarifa del modelo caro, pero obtienes solo una parte de su ventaja. A esa diferencia los autores la llamaron handoff tax — el impuesto por el traspaso de control.
Y no es un artefacto de un solo proveedor: el patrón se repitió en ambas familias. La explicación lógica es que el modelo fuerte gasta contexto en descifrar el laberinto ajeno, adopta parcialmente las suposiciones erróneas de su predecesor y arranca no desde cero, sino con un lastre. Parte de sus capacidades se destina a «leer el diario ajeno» en lugar de a resolver la tarea.
Asimetría: hacia abajo sí, hacia arriba con matices
La observación más útil es que el impuesto no es simétrico. La degradación, al contrario, dio un punto ventajoso en la relación precio-calidad: cambiar a un modelo barato después de completar un razonamiento complejo funciona.
Aún más interesante es que el formato preferido de transferencia del contexto se invierte según la dirección:
- En la escalada, ayuda más reducir la información sobre la trayectoria del modelo débil. Menos ruido — un arranque más limpio.
- En la degradación, eliminar la trayectoria del modelo fuerte reduce la calidad. Aquí el historial funciona como apoyo y conviene conservarlo.
La explicación se sugiere sola: tras el modelo débil queda un rastro de callejones sin salida, y al fuerte eso solo lo estorba. Y tras el fuerte queda un plan bien calibrado y decisiones correctas, por las que el débil puede avanzar como sobre rieles. Esta ya es mi interpretación, no una conclusión literal del artículo, pero concuerda bien con las cifras.
Qué hacer en la práctica
Las conclusiones prácticas son las siguientes:
- Cambien menos de lo que les apetece. Cada cambio no es una operación gratuita, sino una transacción con un precio desconocido.
- Escalen en la frontera, no «cuando se atasquen». Un buen punto es un ciclo completado con un fallo claro (por ejemplo, pruebas que fallan de forma consistente), no la mitad de un razonamiento.
- Hacia arriba, compriman; hacia abajo, conserven. Antes de transferirle al modelo fuerte, armen un resumen compacto: qué ya se hizo, qué no funcionó, qué restricciones hay. No conviene dejar la transcripción completa de los intentos.
- Hacia abajo se puede entregar con generosidad. Al modelo débil le resulta útil ver el plan y las ediciones que dejó el fuerte.
- Calculen su propio impuesto. La diferencia entre «historial completo» y «compactación» en la escalada es un A/B test listo para correr sobre sus propias tareas: es barato y muestra rápido si están pagando el impuesto o no.
Una idea aparte: a veces es más barato no cambiar de modelo en absoluto a mitad de camino. Si el fuerte solo se necesita para planificar, es más lógico separar los roles de antemano — plan del fuerte, ejecución del débil — que montar un traspaso de control dentro de una misma trayectoria.
Conclusión
Cambiar de modelo a mitad de tarea no es una palanca gratuita de optimización del presupuesto, sino una operación con su propio coste. Transferir una trayectoria ajena se come parte de la ventaja por la que estás pagando. La escalada, en este sentido, es más arriesgada de lo que parece; la degradación, en cambio, funciona de forma predecible. Y la principal técnica práctica no está en elegir el modelo, sino en elegir qué exactamente le muestras a ese modelo. Los resultados se obtuvieron con agentes de código y pares de modelos concretos, así que no conviene trasladarlos tal cual a todos los escenarios — pero como hipótesis de trabajo para mediciones propias sirven perfectamente.