
Granite.Trust: un conjunto de herramientas que convierte los requisitos de seguridad de GenAI en políticas operativas
Un equipo de investigadores de IBM presentó las herramientas Granite.Trust: un esquema YAML para describir el contenido permitido y prohibido en las respuestas de los modelos generativos, un generador de datos de entrenamiento consistentes y un kit de herramientas complementario. El enfoque permite fijar las reglas una sola vez y aplicarlas a lo largo de todo el ciclo de vida de la aplicación, desde la alineación del modelo hasta el control en la etapa de funcionamiento.
Por qué no existe una política única para todos
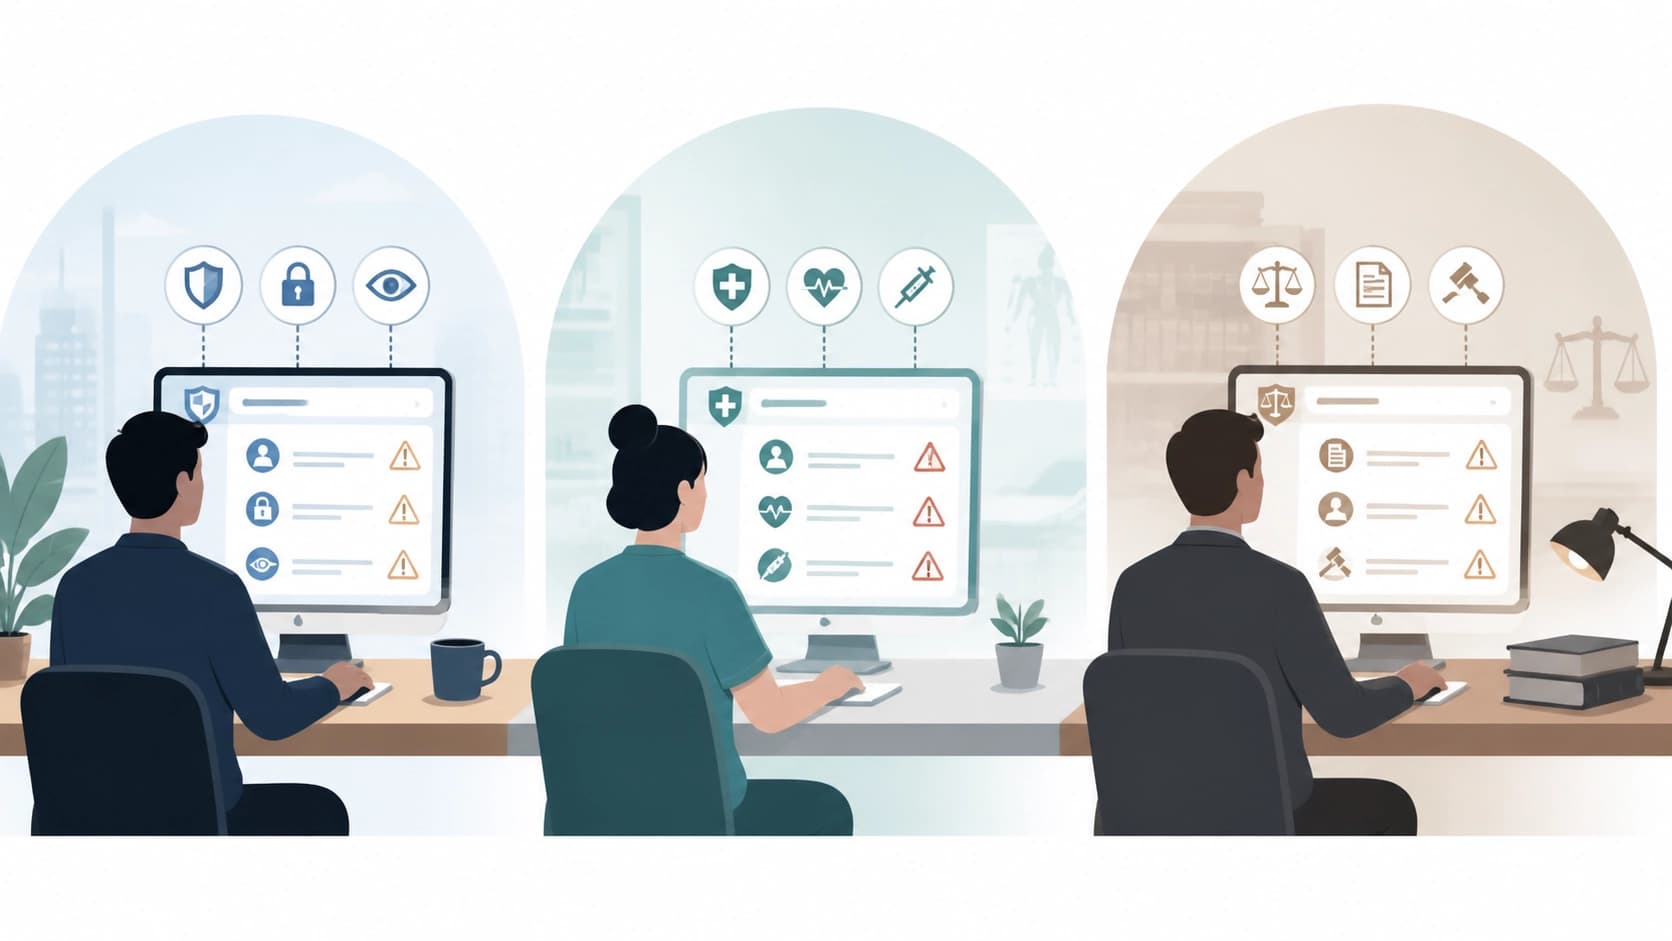
La IA generativa llega a organizaciones muy distintas, y el riesgo de cada una es propio. Un banco teme la filtración de datos de clientes y los consejos financieros erróneos, una clínica, las recomendaciones médicas inexactas, y una escuela, el contenido inapropiado en un diálogo con un adolescente. Súmese a esto los requisitos regulatorios del sector, los valores internos de la empresa y quién exactamente está al otro lado del chat: un empleado raso, un contratista o un usuario externo.
De aquí se desprende una conclusión incómoda: una plantilla única de seguridad para GenAI no funciona. Los ajustes hay que adaptarlos a cada escenario concreto, en lugar de copiarlos de un manual.
El segundo problema es instrumental. Los mecanismos habituales de especificación de políticas crecieron en torno a la gestión de accesos: responden a la pregunta «quién tiene acceso a qué recursos». Pero en las aplicaciones con modelos generativos es mucho más importante otra pregunta: qué puede llegar a aparecer en una respuesta. Las restricciones vinculadas al contenido se describen mal en términos de roles y permisos, y es en esa intersección donde suele empezar el trabajo manual, que no se puede escalar.
Qué propone Granite.Trust
El conjunto de herramientas se describe en el preprint de arXiv:2608.23870, en la sección cs.AI. El material se presentó el 24 de agosto de 2026 y entre los autores figuran Nathalie Baracaldo, Nicolas Mello, Kush R. Varshney, Heiko Ludwig, Kate Soule y David Cox, seis personas en total. El volumen de los archivos fuente es de unos 2,7 MB, lo que para un artículo con herramientas indica una base de código bastante tangible, y no solo un concepto.
Los autores declaran dos cosas principales.
Actionable Policy: la política como documento editable
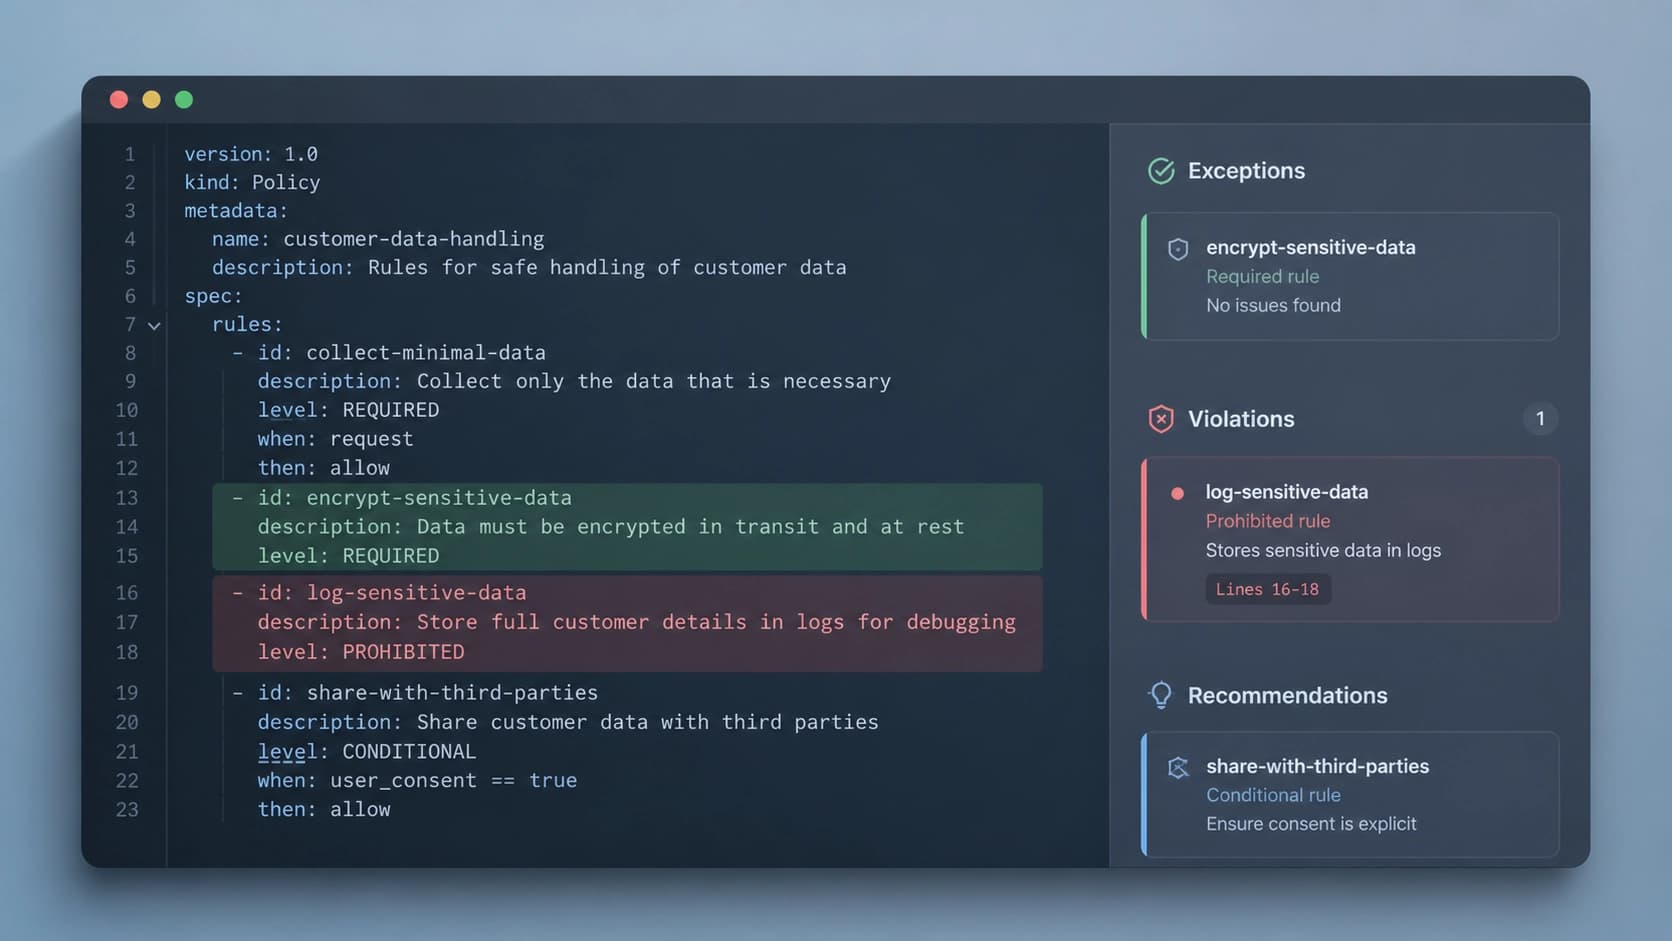
La primera es el esquema Actionable Policy, un formato basado en YAML. No es una «guía de seguridad» abstracta, sino una descripción legible por máquina de qué respuestas del modelo son admisibles y cuáles no. El detalle clave es la gestión basada en excepciones: las reglas tienen salvedades explícitas, y son precisamente ellas las que permiten rastrear los casos de incumplimiento de la política. En pocas palabras, el equipo obtiene no solo una lista de prohibiciones, sino también un mecanismo para entender dónde exactamente el modelo se salió de los límites y por qué.
Datos sintéticos para verificar la política
La segunda es el pipeline de generación de datos sintéticos. Crea ejemplos de entrenamiento alineados con la política ya descrita, y se necesitan con dos fines: el alineamiento del modelo y su evaluación. Además, hay un conjunto de utilidades que ayudan a diseñar el propio esquema y luego a controlar el cumplimiento de las reglas.
La lógica aquí es sensata: si la política existe por separado de los datos con los que se entrena el modelo, se queda en una declaración. Y cuando de la política surgen automáticamente ejemplos de «esto se puede» y «esto no se puede», los requisitos se convierten en algo verificable.
Se define una vez y se aplica en todo el ciclo
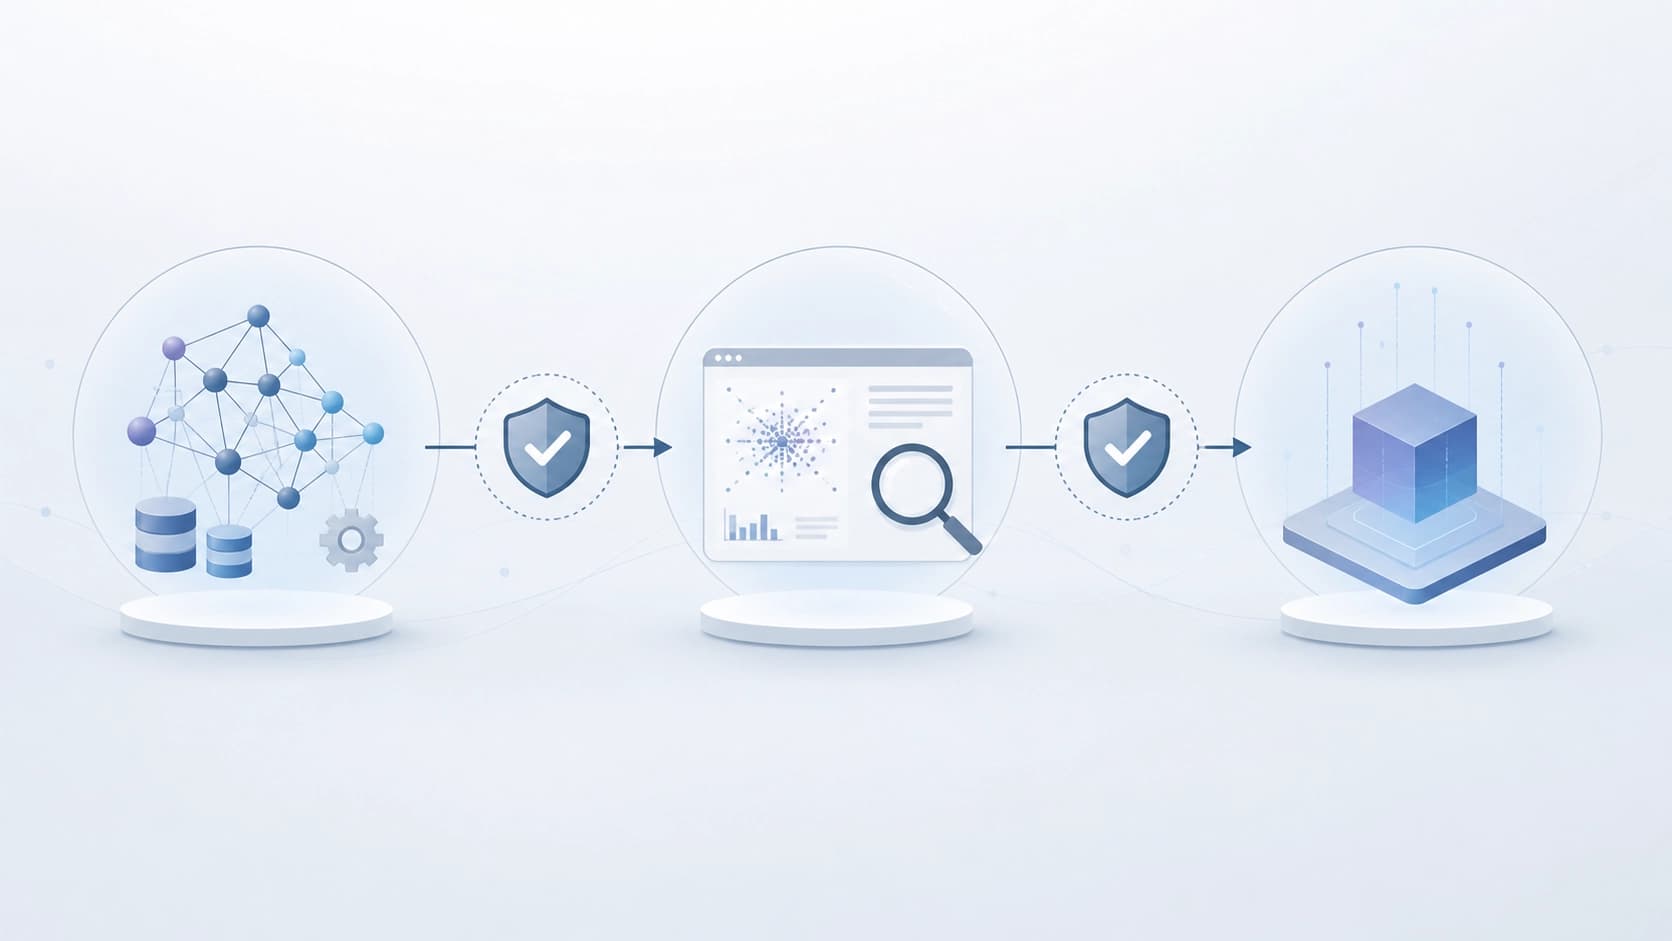
El principal valor práctico de esta combinación es que la política deja de ser un documento de un solo uso. La organización la formula una vez y luego la lleva consigo a lo largo de todo el ciclo de vida de la aplicación: desde la etapa de alineamiento del modelo hasta el monitoreo del producto ya en funcionamiento.
Esto cambia notablemente la rutina diaria de los equipos. Por lo general, los requisitos de seguridad viven en un lugar, las pruebas en otro y los registros de producción en un tercero, y hay que sincronizarlos a mano. Aquí, en cambio, se propone una única fuente de reglas de la que dependen tanto el entrenamiento como las verificaciones previas al lanzamiento y la observación del tráfico en vivo.
Conviene aclarar algo: el conjunto de herramientas no decide por la organización qué riesgos son críticos para ella. Ofrece un lenguaje para describir la política y una infraestructura para ejecutarla, pero el contenido mismo de las reglas sigue siendo tarea de las personas que entienden su producto, su sector y su audiencia.
Código abierto y hacia dónde mirar después
El esquema, los ejemplos de políticas y las propias herramientas están disponibles en abierto. Los autores invitan expresamente a enviar ideas, mejoras y comentarios: la apuesta típica de este tipo de proyectos por que la comunidad encuentre más rápido escenarios a los que el grupo de investigación no llegó.
El texto completo está disponible en varios formatos: PDF, una versión HTML experimental y los archivos fuente en TeX. El artículo tiene DOI — 10.48550/arXiv.2608.23870, así que se puede citar en documentos corporativos sin salvedades sobre un preprint sin identificador.
Si justamente está intentando trasladar los requisitos internos para GenAI del formato «presentación para el consejo de administración» a un formato que haga algo en el pipeline, este es exactamente el tipo de soluciones que conviene ver en vivo. Empiece por los ejemplos de políticas: muestran bastante bien hasta qué punto los autores se imaginan las restricciones reales, y no solo el planteamiento académico del problema.
Preguntas frecuentes
Material similar
Todos los materiales
OpenCollab: coordinación programable de agentes, entorno de ejecución controlado y métrica de cumplimiento de las normas
El framework integra la definición de la estructura de interacción entre agentes, un entorno común para los experimentos y un seguimiento detallado de los eventos, mientras que la métrica Adherence, introducida en este trabajo, refleja hasta qué punto la ejecución real se ajusta al esquema declarado. En los benchmarks, la configuración Duo alcanza un nuevo nivel de SOTA, mientras que la variante de un solo agente destaca por consumir la menor cantidad de tokens.
11 noviembre 2026
Toollery: selección de herramientas para agentes LLM entre decenas de miles de opciones sin necesidad de ajuste fino
Toollery construye un índice de búsqueda a partir de las descripciones de habilidades y herramientas y, al recibir una consulta, solo envía al modelo un conjunto limitado de candidatos. En experimentos con bibliotecas de hasta decenas de miles de funciones, el enfoque permite mantener la calidad de selección con un top-K fijo, aunque el efecto final depende del perfil de carga y del almacenamiento en caché del proveedor.
11 noviembre 2026
Diagnóstico por etapas de agentes GUI al analizar dashboards: el benchmark DashAct
Se presenta DashAct, un benchmark de 348 trayectorias verificadas por humanos que desglosa el trabajo de los agentes GUI con paneles interactivos en tres etapas y cuatro condiciones visuales. Los resultados revelan problemas persistentes para predecir acciones y vincularlas con objetivos visuales, así como la dependencia de las respuestas de los agentes del apoyo contextual y espacial.
11 noviembre 2026