Tres modelos, una licencia y ninguna salvedad
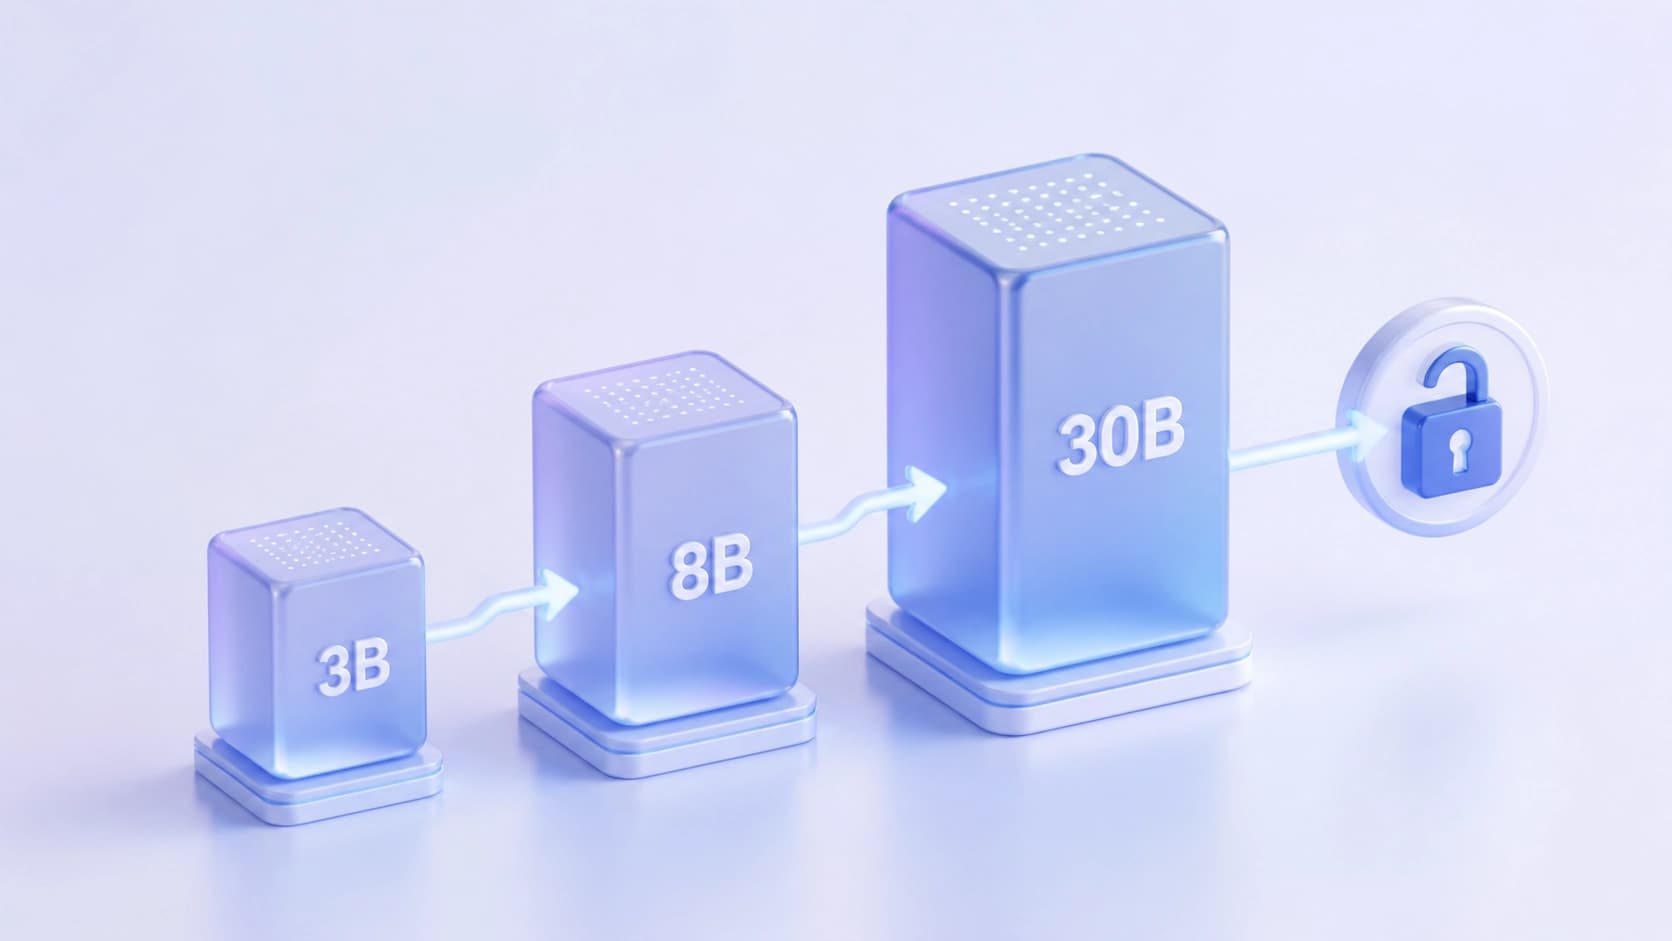
Granite 4.2 ya no es un asistente enfocado en seguir instrucciones, como lo fueron las versiones anteriores de la línea. IBM reestructuró la familia en torno al razonamiento explícito: cualquiera de los modelos primero expone una cadena de pasos y luego formula la respuesta. En el lanzamiento hay tres tamaños: 3B, 8B y 30B de parámetros.
La principal noticia para las empresas no está en los benchmarks, sino en la licencia. Los tres modelos se distribuyen bajo Apache 2.0: descargar, hacer fine-tuning y ejecutar en producción no requiere aprobaciones adicionales ni restricciones de uso comercial. Para empresas de sectores regulados, la posibilidad de mantener los pesos on-prem a menudo pesa más que cualquier línea en las tablas de métricas.
En paralelo se lanzaron dos modelos de voz Granite Speech 5.0 Turbo CTC de 470 millones de parámetros cada uno; hablamos de ellos por separado más abajo.
El modo de funcionamiento se cambia directamente en la plantilla de chat. Hay thinking, hay non-thinking y, entre ambos, low-effort: un presupuesto de razonamiento corto para preguntas simples, para no gastar tokens donde la tarea no lo justifica. En esencia, el mismo modelo cubre tanto el «piensa bien» como el «responde rápido».
Qué tamaño para quién
3B — el portátil de un desarrollador individual
El modelo más pequeño está pensado para desarrolladores individuales y startups pequeñas. Se puede ejecutar localmente a través de Ollama o LM Studio, incluso en los cuantizados GGUF publicados hasta Q4_K_M. Es el escenario de «lo instalé en el portátil y experimento sin factura de API».
8B — una GPU moderna por equipo
El tamaño intermedio está dirigido a equipos del mercado medio: una tarjeta gráfica actual es suficiente para mantener el modelo en el circuito de trabajo.
30B — el entorno corporativo
La variante superior requiere potencia de nivel A100 o H100, además de servicio en FP8 o NVFP4 sobre vLLM. Pero es el caso en que el modelo se puede instalar dentro del perímetro y no exponer los datos al exterior.
Sectores a los que IBM apunta claramente: desarrollo de software y herramientas para desarrolladores, servicios financieros, salud, telecomunicaciones, sector público y centros de contacto, estos últimos precisamente para los nuevos modelos de voz. Los escenarios típicos son agentes para escribir código, automatización de terminal y DevOps, investigación profunda y búsqueda, RAG sobre documentos largos, llamada estructurada de herramientas y transcripción masiva.
Arquitectura: un transformer denso sin trucos
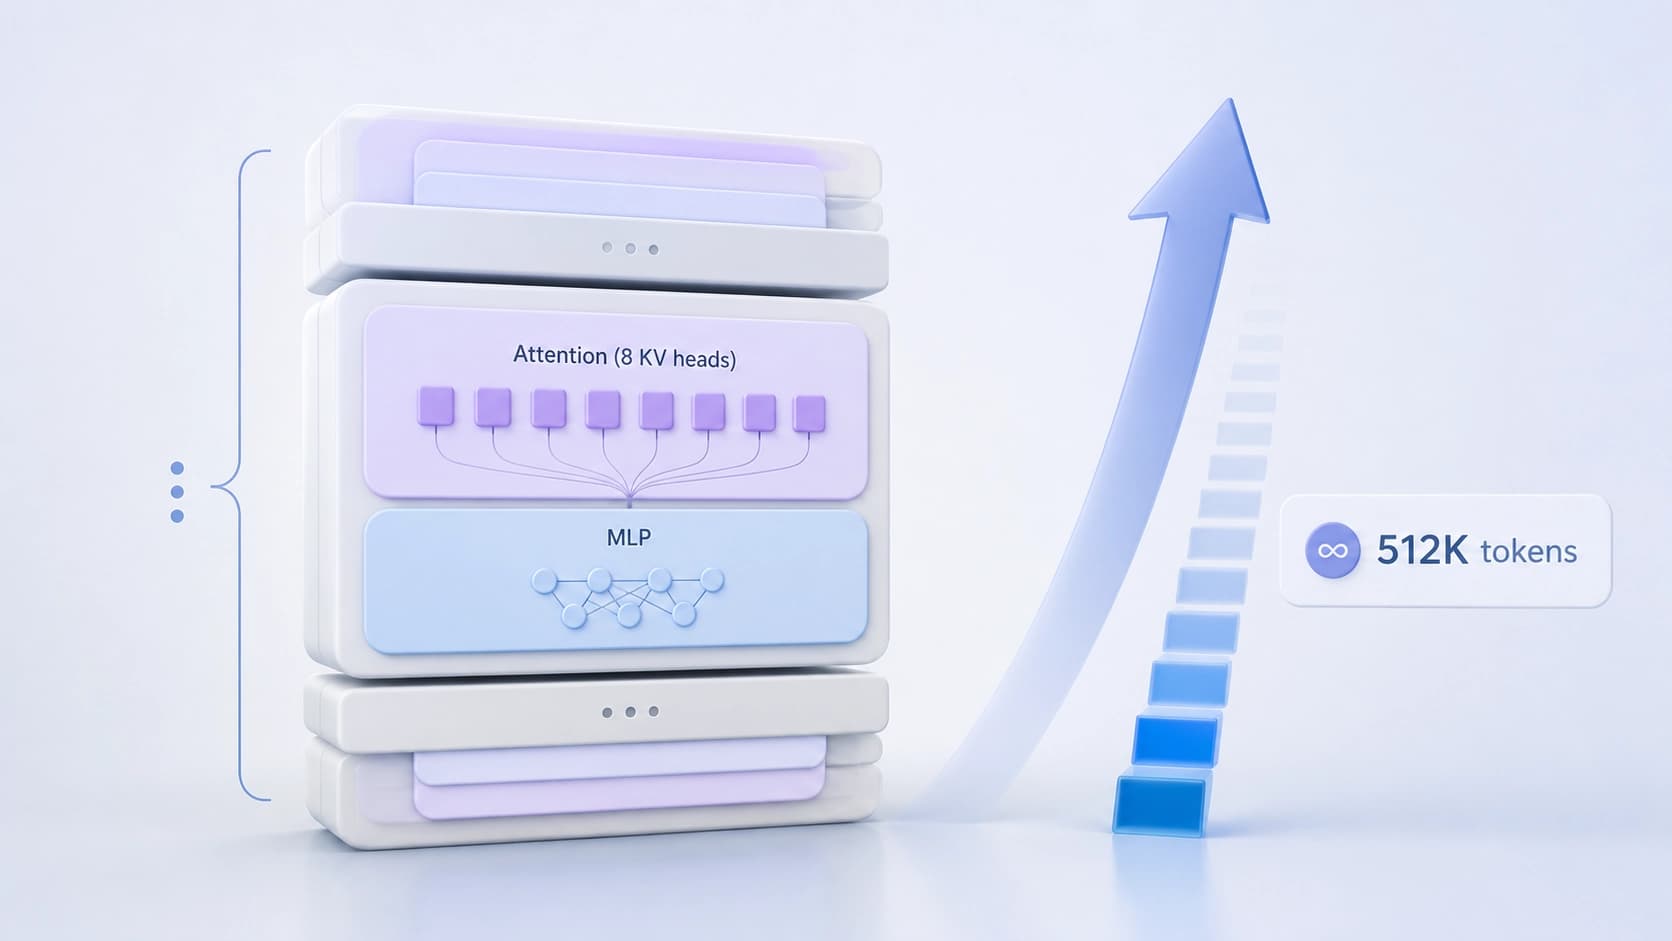
Granite 4.2 es un transformer denso decoder-only. Nada de hibridación, nada de mixture-of-experts: la apuesta está en la previsibilidad del comportamiento y la simplicidad del despliegue, algo lógico para un entorno corporativo.
Detalles técnicos:
- Grouped Query Attention con 8 cabezas KV;
- RoPE con θ = 10 000 000;
- SwiGLU en el MLP;
- RMSNorm con ε = 1e-5;
- embeddings de entrada y salida no vinculados;
- precisión bfloat16.
Los tamaños se diferencian así: el 3B tiene 40 capas y embeddings de 2560, el 8B tiene las mismas 40 capas pero embeddings de 4096, y el 30B tiene 64 capas y un tamaño oculto de MLP de 32 768.
En la tabla de arquitectura publicada se indica una longitud de secuencia de 131 072 tokens, es decir, 128K. Sin embargo, la ejecución de preentrenamiento constó de cinco fases e incluyó una etapa de contexto largo de hasta 512K tokens. El entrenamiento desde cero se hizo con aproximadamente 15 billones de tokens.
Entrenamiento: SFT y luego RL multifase
La etapa de supervised fine-tuning se basó en aproximadamente 7,2 millones de muestras, unos 100 mil millones de tokens, de los cuales alrededor de 65 mil millones son de entrenamiento. La mezcla de datos se distribuye así: 31,6% de ejemplos agénticos frente a 68,4% no agénticos, y la ingeniería de software representa el 69% de la parte agéntica.
Las trayectorias se recopilaron en harnesses, entre ellos OpenHands, SWE-agent, Terminus-2, MiniSWE, Codex y Goose. La calidad se filtró de dos formas: GPT-OSS-120B y Gemma 4 actuaron como jueces, además de una deduplicación por SHA-256 en los campos tools y messages.
El postentrenamiento no es una sola pasada, sino una cadena de RL por varios entornos. Cada etapa es una ejecución asíncrona independiente de GRPO que se warm-startea desde el checkpoint anterior; en lugar de una red de valor se usa una línea base leave-one-out, y el muestreo de importancia truncado limita la deriva en off-policy. El orden es el siguiente: primero RLVR, luego skill boosters, después SWE, Terminal y Search, y al final RLHF.
Aquí está la limitación más importante del lanzamiento: el bloque de RL agéntico se aplicó solo al 8B y al 30B. El 3B más pequeño solo pasa por RL básico y alineación, y esto explica en gran medida la brecha de capacidades entre los tamaños. El entrenamiento se llevó a cabo con NeMo-RL y NeMo-Gym en un clúster NVIDIA GB200 NVL72 alojado en CoreWeave. Además, en el pipeline se incorporaron 1 billón de tokens de código sintético de CodeAlchemy y una capa de decodificación especulativa para acelerar el servicio.
Qué muestran las métricas de IBM
Las cifras las declara la propia IBM, por lo que conviene leerlas como una referencia y no como una verificación independiente. El orden de los valores es 3B / 8B / 30B:
- SWE-Bench Verified: para el 3B no hay evaluación, el 8B tiene 47.6 y el 30B, 57.00;
- Terminal-Bench 2.1: 20.56 y 29.24 respectivamente;
- τ³-bench: 50.99 / 66.34 / 68.05;
- BFCL v4: 52.41 / 50.29 / 61.39;
- AIME25: 78.33 / 86.67 / 89.17;
- GPQA: 54.80 / 64.14 / 66.41;
- MMLU-Pro: 67.84 / 74.04 / 77.60;
- RULER 128K: 55.30 / 71.41 / 81.38.
Un detalle curioso: en la prueba de llamada de funciones el 8B queda ligeramente por debajo del 3B (50.29 frente a 52.41). Es un recordatorio de que el tamaño por sí solo no garantiza ventaja en cada habilidad concreta, y que elegir el modelo para la tarea importa más que perseguir el checkpoint superior.
Voz: 470 millones de parámetros sin backbone LLM
Los modelos de voz Granite Speech 5.0 Turbo CTC están diseñados de forma radicalmente distinta a los sistemas ASR habituales basados en modelos de lenguaje: aquí no se usa ningún backbone LLM, y la conversión de audio a texto se realiza mediante connectionist temporal classification. De ahí su compacidad: 470 millones de parámetros.
IBM declara un RTFx de alrededor de 12 600 en una sola H200, mientras que los actuales líderes de velocidad en el Open ASR leaderboard muestran unos 6 000. Para centros de contacto con grandes volúmenes de grabaciones, la diferencia en rendimiento se traduce directamente en dinero. El modelo se puede probar en una demostración sobre WebGPU.
En resumen
IBM ha construido un producto predecible para el mercado corporativo: modelos densos sin exotismos arquitectónicos, licencia abierta, despliegue en hardware propio y modos de razonamiento para distintos tipos de tareas. Las capacidades agénticas se concentran en el 8B y el 30B, por lo que el 3B conviene percibirlo como un punto de entrada económico y un modelo para escenarios simples, no como un «hermano menor» sin pérdidas. Conviene contrastar los detalles en el blog de IBM Research, la descripción técnica y el repositorio en GitHub, cuyos enlaces se incluyen junto con el lanzamiento.