
Once laboratorios desde cero: registro, configuración y primeros pasos en texto a palabra
Paso a paso, caminamos a través de la creación de una cuenta, eligiendo un plan, y eligiendo una voz de la biblioteca. Luego mostramos cómo generar voces, ajustar la expresión emocional y usar características como clonación de voz y apropiación para proyectos.
Registro y login
Para empezar a trabajar con ElevenLabsAbre el sitio web oficial del servicio y haz clic en "Prueba gratis" o "Regístrate" en la página principal. La forma más fácil de registrar es a través de Google OAuth — entonces no tendrá que recordar otra contraseña. Si prefiere el método clásico, introduzca su dirección de correo electrónico y cree una contraseña; el sistema enviará un correo electrónico con un enlace de confirmación a su bandeja de entrada. Siga ese enlace — y sólo entonces su cuenta se considera activa.
Después de confirmar, llegarás a tu panel personal. Puede explorar inmediatamente las secciones principales: generación de voz, proyectos, apropiación y otras características incorporadas. En esta etapa, usted no tiene que configurar nada — el servicio ofrecerá un breve recorrido introductorio por su cuenta.
Elegir un plan de precios y la configuración inicial
Justo después de entrar, vale la pena decidir un plan. ElevenLabs tiene un plan gratuito que es adecuado para las voces de prueba, así como las suscripciones pagadas a partir de Starter y subir a Enterprise. En el plan libre, el límite mensual de caracteres y el acceso a algunas características son generalmente restringidos, por lo que para el trabajo regular es mejor moverse a un nivel pagado adecuado.
A continuación, vaya a la Biblioteca de Voz — una biblioteca de voces preparadas creadas por la comunidad y la propia empresa. Aquí puede elegir una voz por género, edad , acento o estilo de habla. Preste atención a los filtros: ayudan a reducir la búsqueda si está buscando, por ejemplo, una voz masculina tranquila para instrucciones o una voz femenina enérgica para un comercial.
En esta etapa, también es útil comprobar la configuración de síntesis del discurso. El parámetro clave es la estabilidad — el deslizador de estabilidad. Si lo pones alto, la voz sonará estable y predecible, pero perderá cierta flexibilidad emocional. Un valor bajo agrega la vitalidad y la variedad de la intonación, pero a veces conduce a cambios inesperados de timbre. El valor óptimo depende de la tarea: los audiolibros suelen necesitar estabilidad, mientras que los diálogos necesitan lo contrario.
Creando tu primera voz
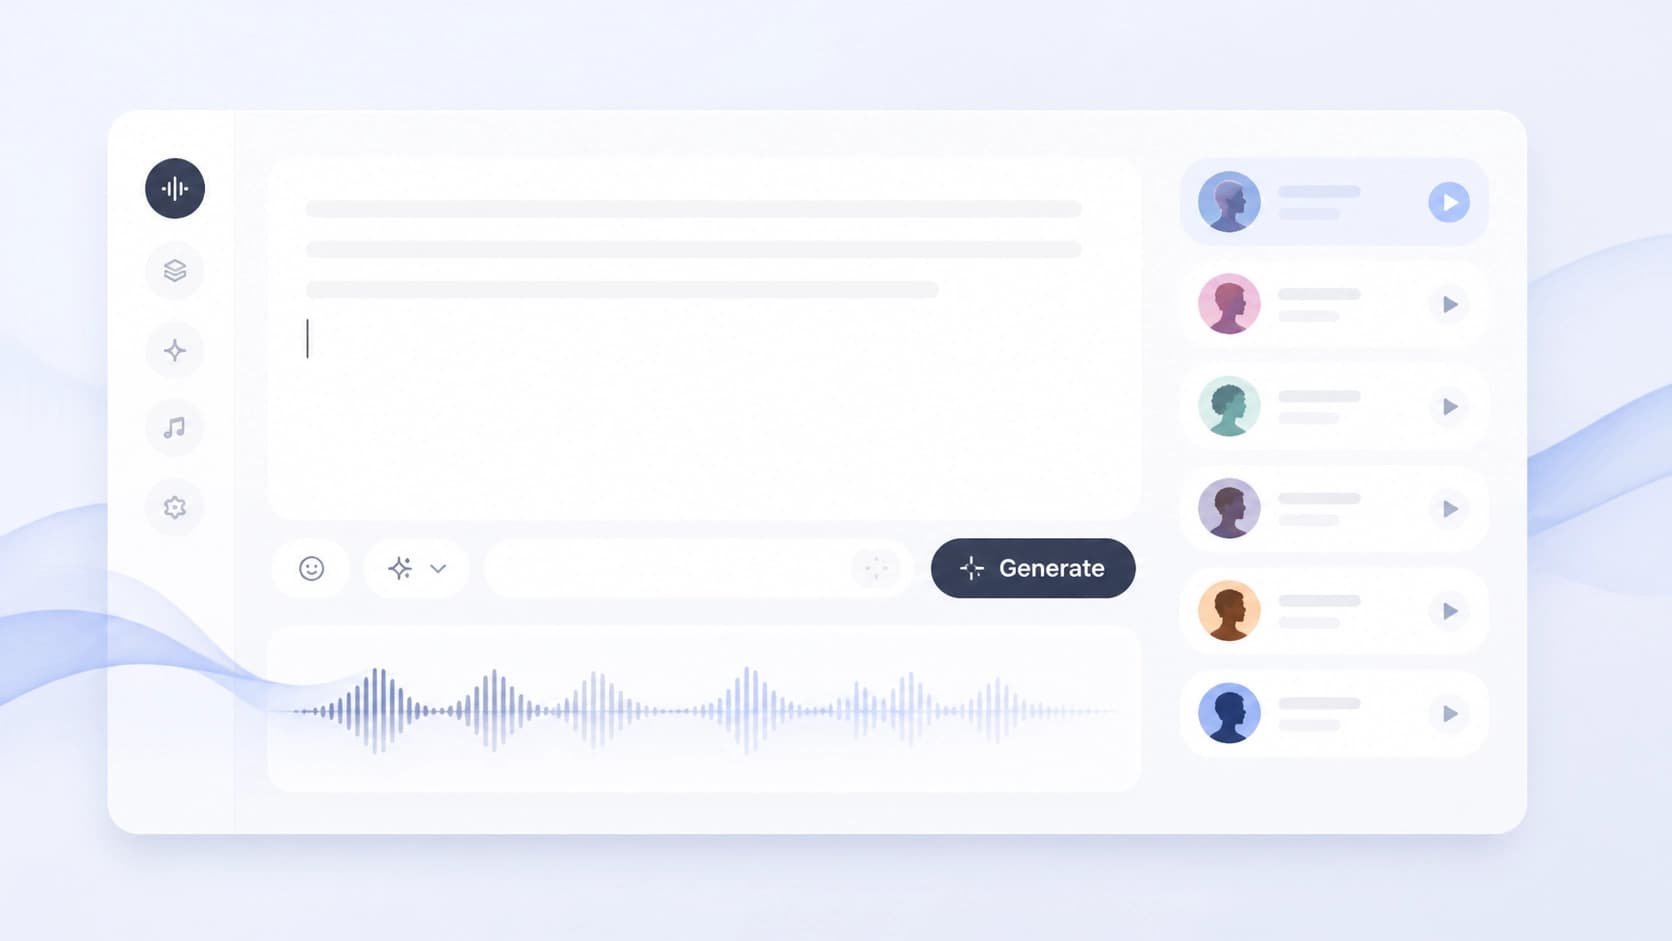
Una vez que se configura tu cuenta y se selecciona una voz, puedes seguir adelante a lo principal — generando el discurso del texto. En el ElevenLabs editor, pega tu texto en el campo dedicado, elige una voz que te guste de la biblioteca, y haz clic en Generar. En unos segundos, el sistema devolverá un archivo de audio terminado que puede escuchar directamente en el navegador o descargar.
Si quieres conseguir un personaje único, utiliza la herramienta de diseño de voz incorporada. Le permite configurar las características de voz "desde cero": género, edad, timbre e incluso características de pronunciación. Esto es conveniente para los creadores de contenido que necesitan una voz consistente para una serie, podcast o blog de vídeo.
Los usuarios avanzados deben prestar atención a Dubbing Studio. Esta característica está diseñada para proyectos multilingües: traduce y voz vídeos a otros idiomas, tratando de preservar la intonación original y el tono emocional. El servicio también tiene Audio Native — un plugin para sitios web que reproducen automáticamente una versión de audio de los artículos de texto.
Consejos prácticos para un comienzo seguro
Los principiantes suelen tener preguntas sobre cuotas y calidad. Para evitar que su trabajo sea interrumpido en el peor momento posible, mantenga un ojo en el mostrador de caracteres en su panel personal. In ElevenLabs, los límites de nivel libre son bastante modestos, por lo que para proyectos largos es mejor cambiar a un plan pagado de antemano o difundir la generación durante días.
No tengas miedo de experimentar con diferentes modelos de voz. El mismo texto puede sonar completamente diferente dependiendo del modelo y la configuración elegidos. Ejecute algunas generaciones de pruebas con el mismo texto y compare los resultados — esta es la manera más rápida de entender qué sonido se adapta a su proyecto.
Si algo sale mal — la voz suena distorsionada, el texto se lee demasiado rápido o demasiado lento— mira en el Centro de ayuda. Allí encontrará instrucciones para solucionar problemas comunes, recomendaciones para optimizar la configuración y respuestas a preguntas frecuentes. También es útil estudiar ejemplos de otros usuarios en la Biblioteca de Voz: el trabajo de otras personas muestra qué parámetros establecer para lograr el efecto deseado.
Preguntas frecuentes
Material similar
Todos los materiales
Anotación híbrida de imágenes: la automatización acelera el entrenamiento de modelos de visión por computadora
El artículo describe cómo el preetiquetado mediante algoritmos reduce el trabajo manual y mejora la calidad de los conjuntos de datos de entrenamiento, así como por qué sigue siendo necesaria la verificación selectiva por parte de una persona. También se analizan las limitaciones del método en condiciones de captura difíciles y con tipos de objetos poco frecuentes.
5 noviembre 2026
Método GoldiMask para el ajuste fino de modelos de lenguaje de difusión: selección del contexto y ponderación de objetivos
Este trabajo presenta GoldiMask, un enfoque de ajuste fino supervisado para modelos de lenguaje con difusión discreta que selecciona los tokens visibles mediante la maximización aproximada de una función submodular y asigna pesos a los objetivos restantes según su utilidad para el entrenamiento. Los experimentos con varios modelos y conjuntos de datos muestran un aumento de la precisión media y mejoras en tareas de razonamiento lógico y programación, además de menos iteraciones de decodificación paralela en GSM8K y MATH-500 con una calidad similar.
30 octubre 2026
Transformers añade compatibilidad para ejecutar modelos GGUF cuantizados en Apple Silicon
El artículo describe la integración del formato GGUF de llama.cpp en Transformers: inferencia local en Mac, carga de modelos a través de la API de la biblioteca y puesta en marcha de un servidor compatible con OpenAI. Con el ejemplo de Qwen3.5-4B, muestra cómo la elección del nivel de cuantización influye en el tamaño de los pesos y en los requisitos de memoria.
18 octubre 2026