
VLA মডেল VLALight ট্রাফিক সিগন্যাল নিয়ন্ত্রণ করে: রাস্তার পাশের ক্যামেরার ভিডিও থেকে সরাসরি এন্ড-টু-এন্ড অ্যাকশন নির্ণয় કરે
লেখকেরা VLALight প্রস্তাব করেছেন—দৃষ্টি-ভাষা-কর্ম শ্রেণির একটি এন্ড-টু-এন্ড মডেল, যা যানবাহন চলাচলের হাতে-তৈরি অবস্থা নির্ধারণের ধাপ এড়িয়ে সরাসরি মোড়ের ক্যামেরার বহু-দৃষ্টিকোণ রেকর্ডিংকে ট্রাফিক সিগন্যালের পরিবর্তনে রূপান্তর করে। এর ভিত্তি হলো মোড়ের টপোলজি-সচেতন যৌথ উপলব্ধি, শহরব্যাপী নেটওয়ার্ক স্তরে রিইনফোর্সমেন্ট লার্নিং এবং দ্রুত ও গভীর যুক্তির মধ্যে অভিযোজিত নির্বাচন; তিনটি শহরের সাতটি বাস্তব ডেটাসেটে সমাধানটি ট্রাফিক মডেল, রিইনফোর্সমেন্ট লার্নিং এবং LLM/VLM-ভিত্তিক বেসলাইনের চেয়ে ভালো ফল করেছে।
ট্রাফিক সিগন্যাল নিয়ন্ত্রণের VLA মডেল কী
VLALight হলো ট্রাফিক সিগন্যাল নিয়ন্ত্রণের জন্য vision-language-action মডেল। লেখক: Pan Zhang, Siqi Lai, Kemu Dong, Hao Liu। প্রবন্ধটি জমা দেওয়া হয় ২৯ সেপ্টেম্বর ২০২৬-এ। এটি রাস্তার পাশের ক্যামেরার বহু-দৃশ্যের ভিডিও ব্যবহার করে প্রান্ত থেকে প্রান্ত পর্যন্ত ট্রাফিক সিগন্যাল নিয়ন্ত্রণের প্রথম VLA মডেল।
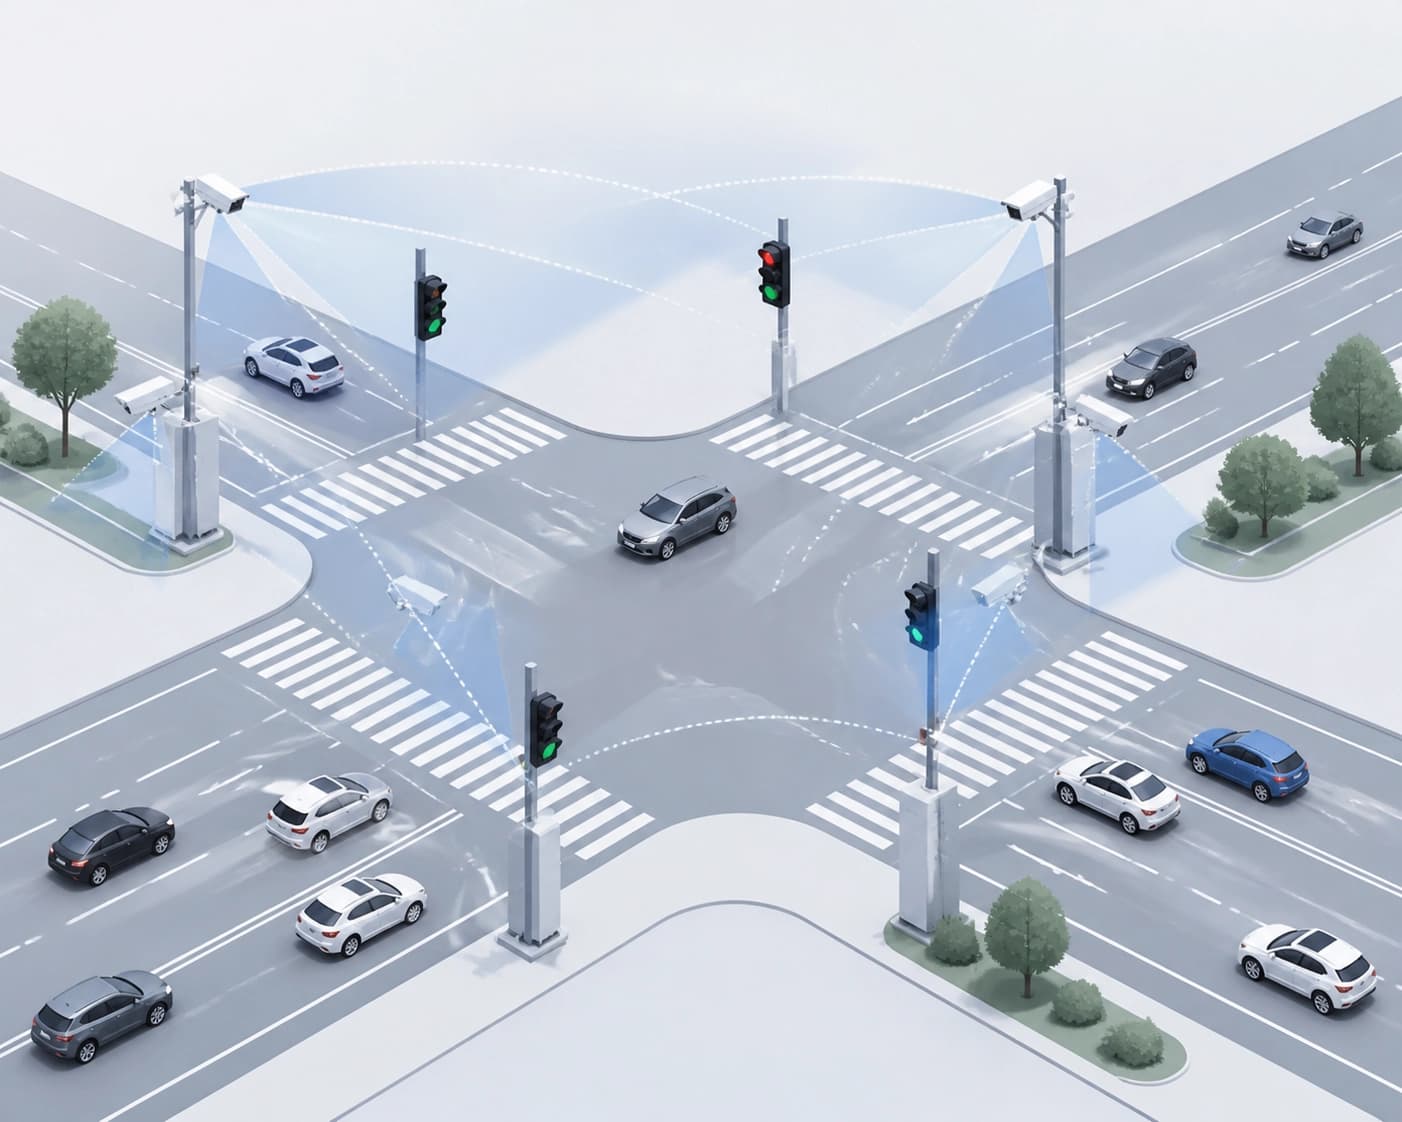
মডেলটি সরাসরি ভিজ্যুয়াল পর্যবেক্ষণকে সমন্বিত ট্রাফিক সিগন্যালের কার্যক্রমে রূপান্তর করে। এটি একাধিক লক্ষ্য নিয়ে স্থানিক-কালিক যুক্তি ব্যবহার করে। পাশাপাশি, এটি মোড়ে যৌথ উপলব্ধির ক্ষেত্রে টপোলজিক্যাল বিষয়গুলো বিবেচনায় নেয়।
পদ্ধতিটির মূল বৈশিষ্ট্য:
- প্রান্ত থেকে প্রান্ত পর্যন্ত ইনফারেন্স: ভিজ্যুয়াল পর্যবেক্ষণ ট্রাফিক সিগন্যালের কার্যক্রমে রূপান্তরিত হয়।
- বহু-দৃশ্যের ভিডিও: তথ্য আসে রাস্তার পাশের ক্যামেরা থেকে।
- স্থানিক-কালিক যুক্তি: মডেলটি একাধিক লক্ষ্য বিবেচনায় নেয়।
- টপোলজিক্যাল বিবেচনা: মোড়ে যৌথ উপলব্ধি।
নির্বাচনের মানদণ্ড: VLA পদ্ধতি একটি মডেলেই উপলব্ধি ও নিয়ন্ত্রণকে একত্রিত করে। এটি এমন পদ্ধতি থেকে একে আলাদা করে, যেখানে এই কাজগুলো পৃথক। ভিডিও ও কার্যক্রমের মধ্যে প্রান্ত থেকে প্রান্ত পর্যন্ত সংযোগই প্রধান মানদণ্ড।
VLALight-কে কীভাবে প্রশিক্ষণ দেওয়া হয়: দুটি ধাপ
VLALight-এর প্রশিক্ষণে দুই ধাপের কৌশল রয়েছে। প্রথমে supervised cold-start প্রয়োগ করা হয়। এটি ট্রাফিক পরিস্থিতির ভিজ্যুয়াল উপলব্ধি এবং সিগন্যাল-সংক্রান্ত সিদ্ধান্ত গ্রহণের দক্ষতা গড়ে তোলে। এরপর cooperative agentic reinforcement learning ব্যবহার করা হয়।
দ্বিতীয় ধাপে স্থানীয় নিয়ন্ত্রণ এবং সামগ্রিকভাবে পরিবহন নেটওয়ার্কের কার্যকারিতা যৌথভাবে অপ্টিমাইজ করা হয়। প্রথম ধাপটি দৃশ্য ও সিগন্যাল বোঝার জন্য। দ্বিতীয় ধাপটি স্থানীয় নিয়ন্ত্রণ ও নেটওয়ার্ক অপ্টিমাইজ করে।
| ধাপ | কাজ | কী অপ্টিমাইজ করে |
|---|---|---|
| Supervised cold-start | ট্রাফিক পরিস্থিতির ভিজ্যুয়াল উপলব্ধি এবং সিগন্যাল-সংক্রান্ত সিদ্ধান্ত গ্রহণ | মডেলের প্রাথমিক দক্ষতা |
| Cooperative agentic reinforcement learning | যৌথ অপ্টিমাইজেশন | স্থানীয় নিয়ন্ত্রণ ও নেটওয়ার্কের কার্যকারিতা |
নির্বাচনের মানদণ্ড: পদ্ধতিতে নেটওয়ার্ক স্তরে যৌথ অপ্টিমাইজেশন আছে কি না, তা দেখতে হবে। নেটওয়ার্কের প্রেক্ষাপট ছাড়া স্থানীয় সিদ্ধান্তের প্রভাব সীমিত থাকে। দুই ধাপের প্রশিক্ষণ উপলব্ধি শেখা এবং পারস্পরিক সমন্বয় উন্নত করাকে পৃথক করে।
অভিযোজিত যুক্তির মোড ও ইনফারেন্সের খরচ
VLALight দ্রুত ও ধীর যুক্তির অভিযোজিত মোড ব্যবহার করে। গভীরতর যুক্তি কেবল তখনই প্রয়োগ করা হয়, যখন তা নিয়ন্ত্রণের জন্য যথেষ্ট উপকার বয়ে আনে। মডেলটি balanced mode-aware rollouts এবং relative advantage optimization ব্যবহার করে। সিদ্ধান্তের মান ও ইনফারেন্সের খরচের মধ্যে ভারসাম্য খুঁজে নিতে মডেলটি শেখে।
| মোড | চালু হওয়ার শর্ত | প্রভাব |
|---|---|---|
| দ্রুত | গভীরতর যুক্তি যথেষ্ট উপকার বয়ে আনে না | ইনফারেন্সের খরচ কম |
| ধীর | গভীরতর যুক্তি যথেষ্ট উপকার বয়ে আনে | আরও ভালো মানের সিদ্ধান্ত |
নির্বাচনের মানদণ্ড: সিদ্ধান্তের মান ও ইনফারেন্সের খরচের মধ্যে ভারসাম্য। নিয়ন্ত্রণের উপকারিতার ভিত্তিতে মোডগুলো বদলানো উচিত। সব সময় সর্বোচ্চ গভীরতায় কাজ করলে খরচ বেড়ে যায়।
পরীক্ষায় কী দেখা গেছে
বাস্তব ট্রাফিক প্রবাহের সাতটি ডেটাসেটে পরীক্ষা চালানো হয়েছে। এগুলো তিনটি শহরের নেটওয়ার্ককে অন্তর্ভুক্ত করে। VLALight বেসলাইন পদ্ধতিগুলোকে ছাড়িয়ে গেছে। বেসলাইনগুলোর মধ্যে ছিল ট্রাফিক মডেল, রিইনফোর্সমেন্ট লার্নিং, LLM/VLM।
| বেসলাইন পদ্ধতির শ্রেণি | তুলনায় ভূমিকা |
|---|---|
| ট্রাফিক মডেল | বেসলাইন |
| রিইনফোর্সমেন্ট লার্নিং | বেসলাইন |
| LLM/VLM | বেসলাইন |
অ্যাবলেশন গবেষণায় যৌথ উপলব্ধি, নেটওয়ার্ক স্তরের অপ্টিমাইজেশন এবং অভিযোজিত যুক্তির কার্যকারিতা নিশ্চিত হয়েছে। লেখকদের মতে, বাস্তব ভৌত পরিবহন ব্যবস্থা নিয়ন্ত্রণে VLA মডেলের সম্ভাবনা রয়েছে।
নির্বাচনের মানদণ্ড: বেসলাইন পদ্ধতির ধরন এবং অ্যাবলেশন আছে কি না, তা যাচাই করা। পরীক্ষাগুলো বাস্তব ট্রাফিক প্রবাহ ও তিনটি শহরের নেটওয়ার্ককে অন্তর্ভুক্ত করে। প্রতিটি উপাদানের অবদান আলাদাভাবে নিশ্চিত করা উচিত।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ইন্টারঅ্যাকটিভ XR ডেভেলপমেন্টে কোডিং এজেন্টদের মূল্যায়ন: GenXR-Bench-এর ফলাফল
প্রকাশিত হয়েছে GenXR-Bench—ইন্টারেক্টিভ XR ডেভেলপমেন্টে কোডিং এজেন্টগুলোর এন্ড-টু-এন্ড মূল্যায়নের জন্য ১১২টি বিশেষজ্ঞ-নির্ধারিত কাজের একটি সেট: ফিচার উন্নত করা ও ত্রুটি ঠিক করা থেকে শুরু করে ভোক্তা-পর্যায়ের ডিভাইসে আচরণ যাচাইসহ অ্যাপ্লিকেশন তৈরি পর্যন্ত। পরীক্ষিত দশটি মডেলের মধ্যে সেরা ফল ছিল ৫০.৯% Pass@1; বারবার দেখা ব্যর্থতার মধ্যে রয়েছে সেন্সরের অ্যাসিঙ্ক্রোনাস ইভেন্ট সামলানো, বাস্তব স্থানের সঙ্গে অবজেক্ট যুক্ত করা এবং ভৌত প্রেক্ষাপটে মিথস্ক্রিয়া বোঝা।
5 নভেম্বর 2026
ছবির হাইব্রিড অ্যানোটেশন: স্বয়ংক্রিয়করণ কম্পিউটার ভিশন মডেলের প্রশিক্ষণকে ত্বরান্বিত করে
নিবন্ধে বর্ণনা করা হয়েছে, অ্যালগরিদমের মাধ্যমে প্রাথমিক লেবেলিং কীভাবে হাতে করা কাজ কমায় এবং প্রশিক্ষণ ডেটাসেটের পরিচ্ছন্নতা বাড়ায়, পাশাপাশি কেন নির্বাচিতভাবে মানুষের যাচাই এখনও জরুরি। কঠিন শুটিং পরিস্থিতি এবং বিরল ধরনের বস্তুর ক্ষেত্রে এই পদ্ধতির সীমাবদ্ধতাগুলোও আলোচিত হয়েছে।
5 নভেম্বর 2026
স্কেলার পুরস্কার থেকে প্যারেটো ফ্রন্টিয়ার: বহু-উদ্দেশ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের মাধ্যমে LLM-ভিত্তিক RTL সংশ্লেষণ
একটি ভাষা মডেলকে একটি মাত্র নকশা নয়, বরং ক্ষেত্রফল, বিলম্ব ও বিদ্যুৎ খরচের মধ্যে বিভিন্ন সমঝোতাসহ একগুচ্ছ RTL প্রার্থী তৈরি করতে প্রশিক্ষণ দেওয়ার একটি পদ্ধতি প্রস্তাব করা হয়েছে; পুরস্কার নির্ধারিত হয় প্যারেটো ফ্রন্টের হাইপারভলিউমে প্রতিটি বিকল্পের অবদানের ভিত্তিতে। RTLLM v2-তে আপেক্ষিক হাইপারভলিউম PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণের তুলনায় ১৩.৩ শতাংশ পয়েন্ট এবং একক-লক্ষ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের তুলনায় ১৪.৪ শতাংশ পয়েন্ট বেড়েছে।
5 নভেম্বর 2026