
স্কেলার পুরস্কার থেকে প্যারেটো ফ্রন্টিয়ার: বহু-উদ্দেশ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের মাধ্যমে LLM-ভিত্তিক RTL সংশ্লেষণ
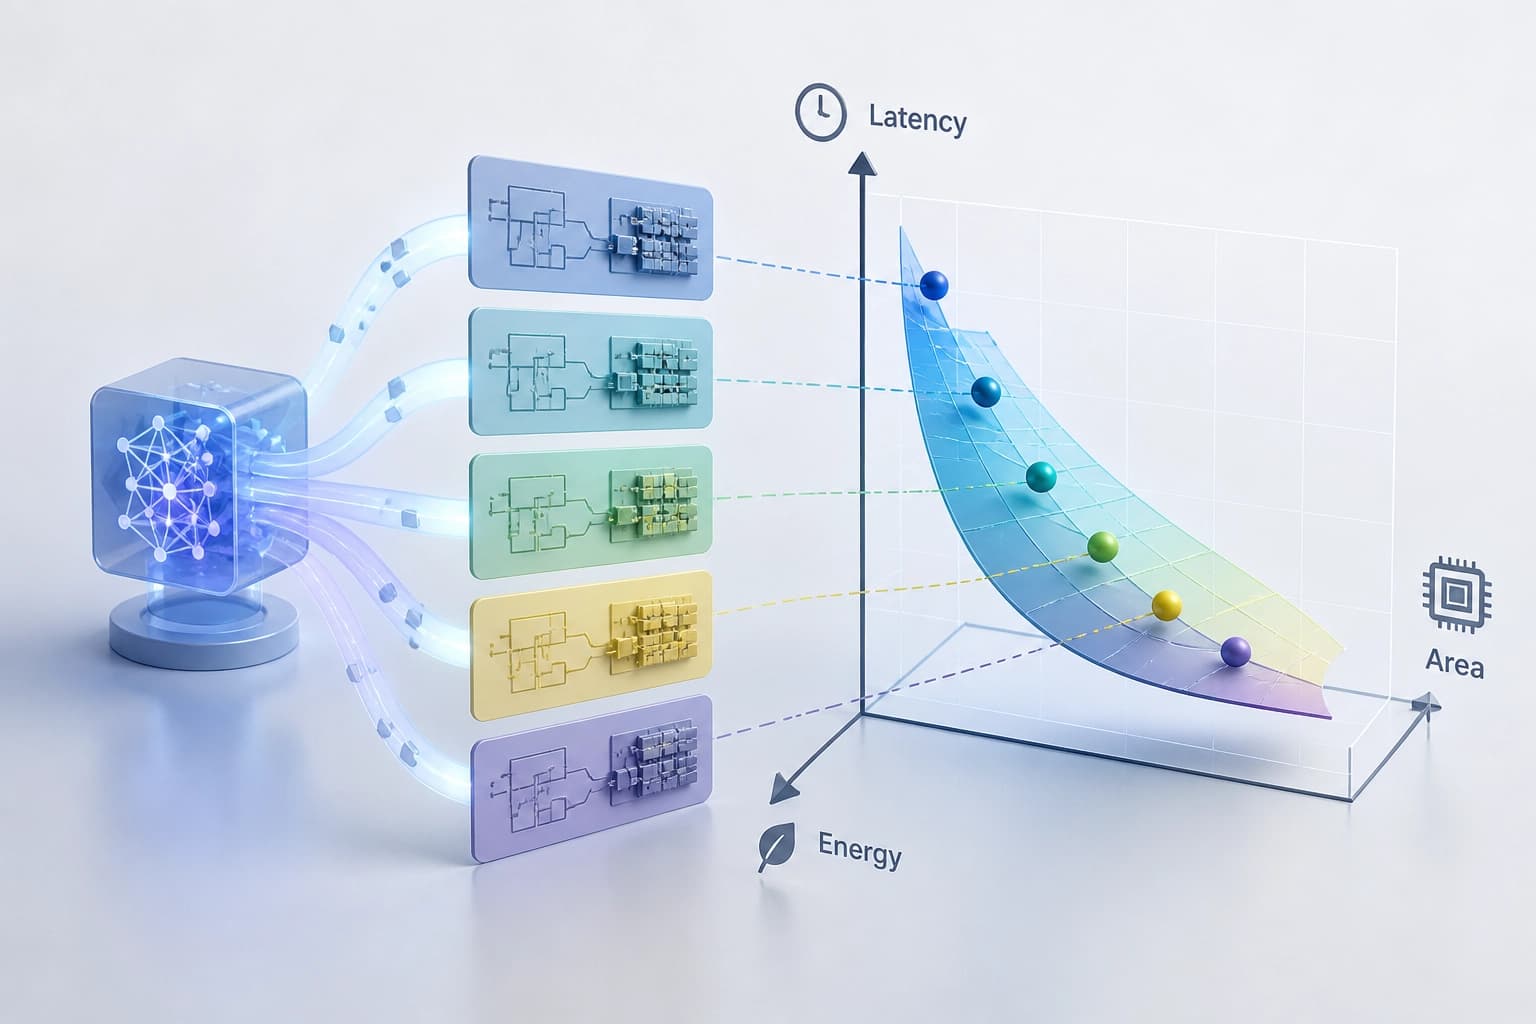
একটি ভাষা মডেলকে একটি মাত্র নকশা নয়, বরং ক্ষেত্রফল, বিলম্ব ও বিদ্যুৎ খরচের মধ্যে বিভিন্ন সমঝোতাসহ একগুচ্ছ RTL প্রার্থী তৈরি করতে প্রশিক্ষণ দেওয়ার একটি পদ্ধতি প্রস্তাব করা হয়েছে; পুরস্কার নির্ধারিত হয় প্যারেটো ফ্রন্টের হাইপারভলিউমে প্রতিটি বিকল্পের অবদানের ভিত্তিতে। RTLLM v2-তে আপেক্ষিক হাইপারভলিউম PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণের তুলনায় ১৩.৩ শতাংশ পয়েন্ট এবং একক-লক্ষ্যভিত্তিক রিইনফোর্সমেন্ট লার্নিংয়ের তুলনায় ১৪.৪ শতাংশ পয়েন্ট বেড়েছে।
কাজ ও অবস্থা
- শিরোনাম: Pareto-Optimal RTL Code Generation via Multi-Objective Reinforcement Learning with Large Language Models।
- লেখক: Koki Takeshita, Kenji Uebayashi, Hikaru Tomonari, Masaya Tsunokake, Koichiro Yawata, Tatsuya Sasaki, Yusuke Ohtsubo, Kota Dohi, Yasuhiro Sogawa।
- জমা দেওয়ার তারিখ: ১৬ অক্টোবর ২০২৬।
- অবস্থা: মন্তব্যে বলা হয়েছে, কাজটি COLM 2026-এ গৃহীত হয়েছে।
প্রিপ্রিন্টটি arXiv:2610.26904-এ পাওয়া যায়। কাজটি বৃহৎ ভাষা মডেলের সাহায্যে RTL তৈরির সঙ্গে সম্পর্কিত। পদ্ধতিটি মডেলকে একটি মাত্র সার্কিটের বদলে একগুচ্ছ প্রার্থী তৈরি করতে প্রশিক্ষণ দেয়। এই গুচ্ছকে PPA স্পেসে মূল্যায়ন করা হয়।
উপসংহার: কাজটি COLM 2026-এ গৃহীত হয়েছে এবং LLM-ভিত্তিক RTL সংশ্লেষণের জন্য একটি বহু-উদ্দেশ্য পদ্ধতির প্রস্তাব দেয়। পদ্ধতিটি বেছে নেওয়ার ক্ষেত্রে লক্ষ্য পরিবর্তনটাই গুরুত্বপূর্ণ—একটি সার্কিট থেকে একগুচ্ছ সার্কিটে।
স্কেলার পুরস্কারের সমস্যা
প্রচলিত পদ্ধতিগুলো একাধিক লক্ষ্যকে একটি স্কেলার পুরস্কারে একত্র করে। এর ফলে একই সঙ্গে বৈচিত্র্যময়, প্যারেটো-সর্বোত্তম সমাধান পাওয়া কঠিন হয়। কম শক্তি খরচ, কম বিলম্ব এবং কম ক্ষেত্রফলের মধ্যে বিভিন্ন সমঝোতায় পৌঁছানোও কঠিন হয়ে পড়ে। স্কেলার পুরস্কার তৈরির আগেই লক্ষ্যগুলোর গুরুত্ব নির্ধারণ করে দেয়।
লক্ষ্যগুলোর আপেক্ষিক গুরুত্ব পণ্যের চাহিদা এবং প্রকল্পের সীমাবদ্ধতার ওপর নির্ভর করে। আগেই নির্ধারিত পুরস্কার এসব চাহিদার সঙ্গে পরিবর্তিত হয় না। তাই বিভিন্ন সমঝোতাসহ একগুচ্ছ প্রার্থী প্রয়োজন।
| পদ্ধতি | কী অপ্টিমাইজ করে | কখন সমঝোতা বেছে নেওয়া হয় |
|---|---|---|
| স্কেলার পুরস্কার | লক্ষ্যগুলোর যোগফল অনুযায়ী একটি সার্কিট | তৈরির আগে |
| বহু-উদ্দেশ্য পদ্ধতি | প্যারেটো ফ্রন্টে সার্কিটের একটি গুচ্ছ | তৈরির পরে |
উপসংহার: স্কেলার পুরস্কার তৈরির আগেই সমঝোতা নির্ধারণ করে। বহু-উদ্দেশ্য বিন্যাসে নির্বাচন তৈরির পরের ধাপে চলে যায়।
পদ্ধতিটি কী অপ্টিমাইজ করে
পদ্ধতিটি সার্কিটের পুরো গুচ্ছের গুণমান ও বৈচিত্র্য অপ্টিমাইজ করে। একাধিকবার তৈরি করার মাধ্যমে এই গুচ্ছ পাওয়া যায়। PPA লক্ষ্য-স্পেসে মূল্যায়ন করা হয়: শক্তি, কর্মক্ষমতা, ক্ষেত্রফল। পদ্ধতিটির লক্ষ্য একটি সার্কিটের গুণমান নয়।
PPA লক্ষ্যগুলোর মধ্যে সমঝোতা রয়েছে। বিভিন্ন সার্কিটে কম শক্তি খরচ, কম বিলম্ব এবং কম ক্ষেত্রফলের ভিন্ন ভিন্ন সমন্বয় পাওয়া যায়। তাই পদ্ধতিটি মডেলকে প্যারেটো ফ্রন্টের বিভিন্ন বিন্দু কভার করতে প্রশিক্ষণ দেয়। ডিজাইনার একাধিক প্রার্থী পান।
উপসংহার: পদ্ধতিটির লক্ষ্য একটি সেরা উত্তর নয়, বরং ফ্রন্ট কভার করা।
পদ্ধতির দুটি উপাদান
জেনারেশন-ভিত্তিক প্রশিক্ষণ পাইপলাইন
এই পাইপলাইন প্যারেটো সমাধানের পুরো সেটের কভারেজ উন্নত করার কাজটিকে ধারাবাহিক সার্কিট-জেনারেশনের সমস্যায় রূপান্তরিত করে। প্রশিক্ষণ ধাপে ধাপে চলে। ফলে জেনারেশনের কাজটি একটি ধারাবাহিক কাঠামো পায়।
Hypervolume Contribution-ভিত্তিক পুরস্কার
HVC পুরস্কার ফাংশনটি প্যারেটো ফ্রন্টে তৈরি করা সার্কিটের অবদান পরিমাপ করে। পুরস্কারটি একটি সার্কিটের পরম গুণমান নয়, বরং কভারেজের বৃদ্ধিকে প্রতিফলিত করে। HVC প্রশিক্ষণকে ফ্রন্ট কভার করার সঙ্গে যুক্ত করে।
উপসংহার: পাইপলাইনটি ধারাবাহিকতা নির্ধারণ করে, HVC কভারেজে অবদানের জন্য সংকেত দেয়।
RTLLM v2-এ ফলাফল
RTLLM v2 বেঞ্চমার্কে মূল্যায়নে আপেক্ষিক Hypervolume বৃদ্ধি পেয়েছে। PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণের তুলনায় বৃদ্ধি ছিল +১৩.৩ শতাংশ পয়েন্ট। একক-উদ্দেশ্যের RL পদ্ধতির তুলনায় বৃদ্ধি ছিল +১৪.৪ শতাংশ পয়েন্ট। লেখকেরা সার্কিটের বৈচিত্র্যেও শ্রেষ্ঠত্বের কথা জানিয়েছেন।
| তুলনা | আপেক্ষিক Hypervolume বৃদ্ধি |
|---|---|
| PPA অপ্টিমাইজেশনবিহীন বেসলাইন সংস্করণ | +১৩.৩ শতাংশ পয়েন্ট |
| একক-উদ্দেশ্যের RL পদ্ধতি | +১৪.৪ শতাংশ পয়েন্ট |
উপসংহার: RTLLM v2-এ পদ্ধতিটি ফ্রন্টের কভারেজ ও বৈচিত্র্য উন্নত করে। সংখ্যাগুলো আপেক্ষিক Hypervolume-এর, প্রতিটি সার্কিটের পরম গুণমানের নয়।
পদ্ধতি বেছে নেওয়ার ব্যবহারিক মানদণ্ড
সমঝোতা কখন নির্ধারণ করা হয়, তার ওপর পদ্ধতি বেছে নেওয়া হয়। স্কেলার পুরস্কারে তৈরির আগেই PPA-র গুরুত্ব নির্ধারণ করতে হয়। বহু-উদ্দেশ্য পদ্ধতিতে নির্বাচন তৈরির পরের ধাপে চলে যায়। এতে বিভিন্ন সমঝোতাসহ একগুচ্ছ প্রার্থী পাওয়া যায়।
পদ্ধতিটির মূল্যায়ন RTLLM v2 বেঞ্চমার্কে সীমাবদ্ধ। অন্য ডিজাইন ফ্লোর জন্য নিজস্ব যাচাই দরকার। যাচাই ছাড়া অন্যান্য পরিস্থিতিতে উন্নতির সংখ্যাগুলো প্রয়োগ করা যায় না।
উপসংহার: পণ্যভেদে প্রকল্পের PPA-সংক্রান্ত চাহিদা পরিবর্তিত হলে, তৈরির পরে নির্বাচন করার কাজের সঙ্গে বহু-উদ্দেশ্য পদ্ধতি সামঞ্জস্যপূর্ণ। লক্ষ্যগুলোর গুরুত্ব জানা ও স্থির থাকলে, আগে থেকে নির্ধারিত সমঝোতার ক্ষেত্রে স্কেলার পুরস্কার উপযুক্ত।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
ইন্টারঅ্যাকটিভ XR ডেভেলপমেন্টে কোডিং এজেন্টদের মূল্যায়ন: GenXR-Bench-এর ফলাফল
প্রকাশিত হয়েছে GenXR-Bench—ইন্টারেক্টিভ XR ডেভেলপমেন্টে কোডিং এজেন্টগুলোর এন্ড-টু-এন্ড মূল্যায়নের জন্য ১১২টি বিশেষজ্ঞ-নির্ধারিত কাজের একটি সেট: ফিচার উন্নত করা ও ত্রুটি ঠিক করা থেকে শুরু করে ভোক্তা-পর্যায়ের ডিভাইসে আচরণ যাচাইসহ অ্যাপ্লিকেশন তৈরি পর্যন্ত। পরীক্ষিত দশটি মডেলের মধ্যে সেরা ফল ছিল ৫০.৯% Pass@1; বারবার দেখা ব্যর্থতার মধ্যে রয়েছে সেন্সরের অ্যাসিঙ্ক্রোনাস ইভেন্ট সামলানো, বাস্তব স্থানের সঙ্গে অবজেক্ট যুক্ত করা এবং ভৌত প্রেক্ষাপটে মিথস্ক্রিয়া বোঝা।
5 নভেম্বর 2026
চিকিৎসাবিষয়ক LLM-গুলো নির্দেশিকা সংশোধনের কথা জানে, কিন্তু প্রায়ই পুরোনো নিয়ম অনুযায়ী উত্তর দেয়
1709টি ক্লিনিক্যাল নির্দেশিকার পরিবর্তন নিয়ে ChronoEvo-এর গবেষণায় দেখা গেছে: মূল মডেলে 90,8% উত্তর নতুনত্বটি শনাক্ত করেছিল, তবে মাত্র 58,5% তা সম্পূর্ণভাবে প্রয়োগ করেছিল; 32,3 শতাংশ পয়েন্টের এই ব্যবধান 14টি মডেলেই বজায় ছিল। আপডেটগুলোর দৃশ্যমানতা বাড়িয়েও নতুন নিয়মগুলো ক্লিনিক্যাল নির্দেশিকায় সম্পূর্ণভাবে অন্তর্ভুক্ত করার ক্ষেত্রে উল্লেখযোগ্য উন্নতি হয়নি।
4 নভেম্বর 2026
সীমাবদ্ধ LLM-এ এজেন্টদের জন্য বিশ্ব মডেল: ঝুঁকির মুহূর্তে সংশোধন
PAWM প্রস্তাব করা হয়েছে—একটি বাহ্যিক পূর্বাভাসদাতা, যা ধাপে ধাপে পর্যবেক্ষণের পুনরাবৃত্তি না করে সম্ভাব্য ব্যর্থতার সময় সক্রিয় হয় এবং এজেন্টকে ভুল পদক্ষেপ থেকে সরিয়ে দেয়। সিন্থেটিক পরিস্থিতিতে SFT এবং GRPO-সহ-প্রশিক্ষণের পর, Claude Sonnet 4.5-এর জন্য পদ্ধতিটি ScienceWorld-এ 24,3% এবং WebArena-Lite-এ 7,7% উন্নতি এনেছে।
4 নভেম্বর 2026