কেন ট্র্যাজেক্টরি একটি খারাপ পরিমাপের একক
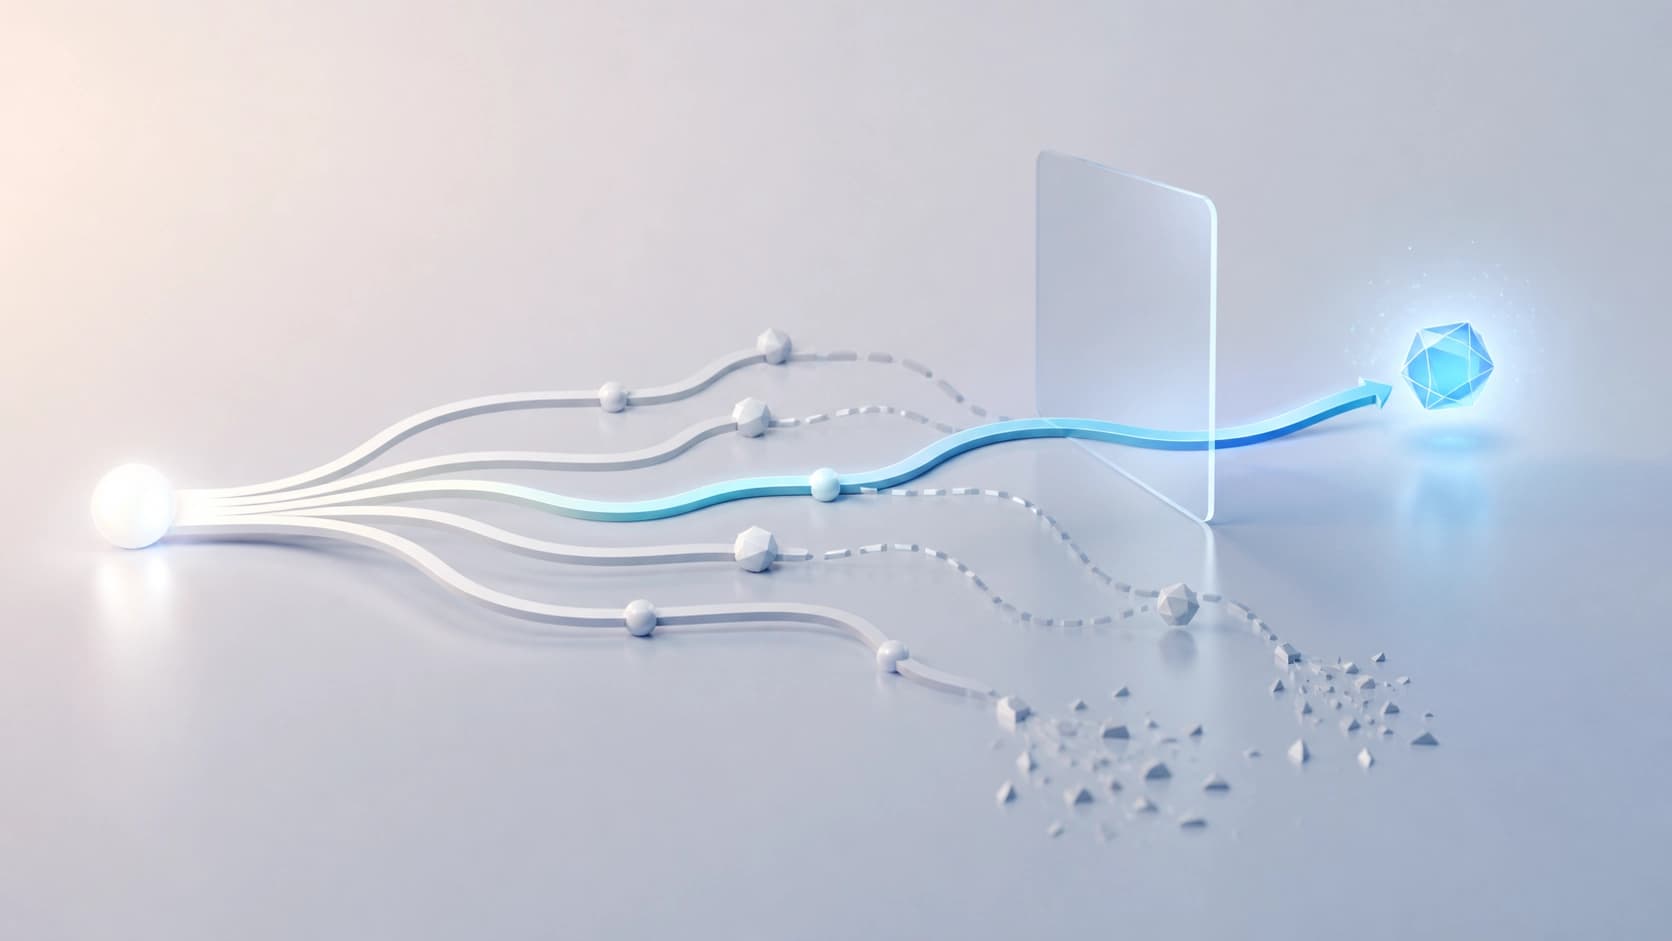
ইনফারেন্সের সময় আধুনিক রিজনিং পদ্ধতিগুলো একই ধরনের কৌশলে কাজ করে: মডেল একটি মাত্র উত্তর নয়, বরং সম্ভাব্য চেইনের একটি পুল তৈরি করে, এরপর একটি বাহ্যিক reward-মডেল সেরাটি বেছে নেয়। যুক্তিটি সহজ — যত বেশি বিকল্প, তত বেশি সম্ভাবনা যে তাদের মধ্যে একটি ভালোটি থাকবে।
দুর্বলতা এখানে অন্য জায়গায়। প্রতিটি প্রার্থীকে একটি অবিভাজ্য একক হিসেবে বিবেচনা করা হয়: হয় তাকে সম্পূর্ণভাবে গ্রহণ করা হয়, নয়তো সম্পূর্ণভাবে বাতিল করা হয়। কিন্তু দীর্ঘ রিজনিং খুব কমই সমসত্বপূর্ণ হয়। সাধারণ চিত্রটি হলো — আত্মবিশ্বাসী, সঠিক সূচনা, সমস্যার সুচারু উপস্থাপন, সঠিকভাবে নির্বাচিত পদ্ধতি, এবং তারপর বিপর্যয়: গাণিতিক ভুল, লুপে আটকে যাওয়া, শর্তের বিকৃতি। আনুষ্ঠানিকভাবে পুরো চেইনটিকে ব্যর্থ হিসেবে চিহ্নিত করা হয়, যদিও তার প্রথম অর্ধেকটি সম্পূর্ণ কার্যকর ছিল।
ফলাফল — বৃথা ব্যয়িত গণনা। আমরা এমন টোকেন তৈরির জন্য অর্থ দিই যেগুলো সঠিক ছিল, তারপর নষ্ট হওয়া লেজের সাথে সেগুলোও ফেলে দিই। Selective Regenerative Decoding শীর্ষক গবেষণাপত্রের লেখকেরা ঠিক এই অদক্ষতার দিকেই ইঙ্গিত করেছেন, যা arXiv:2608.24338 (cs.AI) হিসেবে ২৫ আগস্ট ২০২৬-এ প্রকাশিত হয়েছে।
SRD: দুইয়ের বদলে তিনটি শাখা
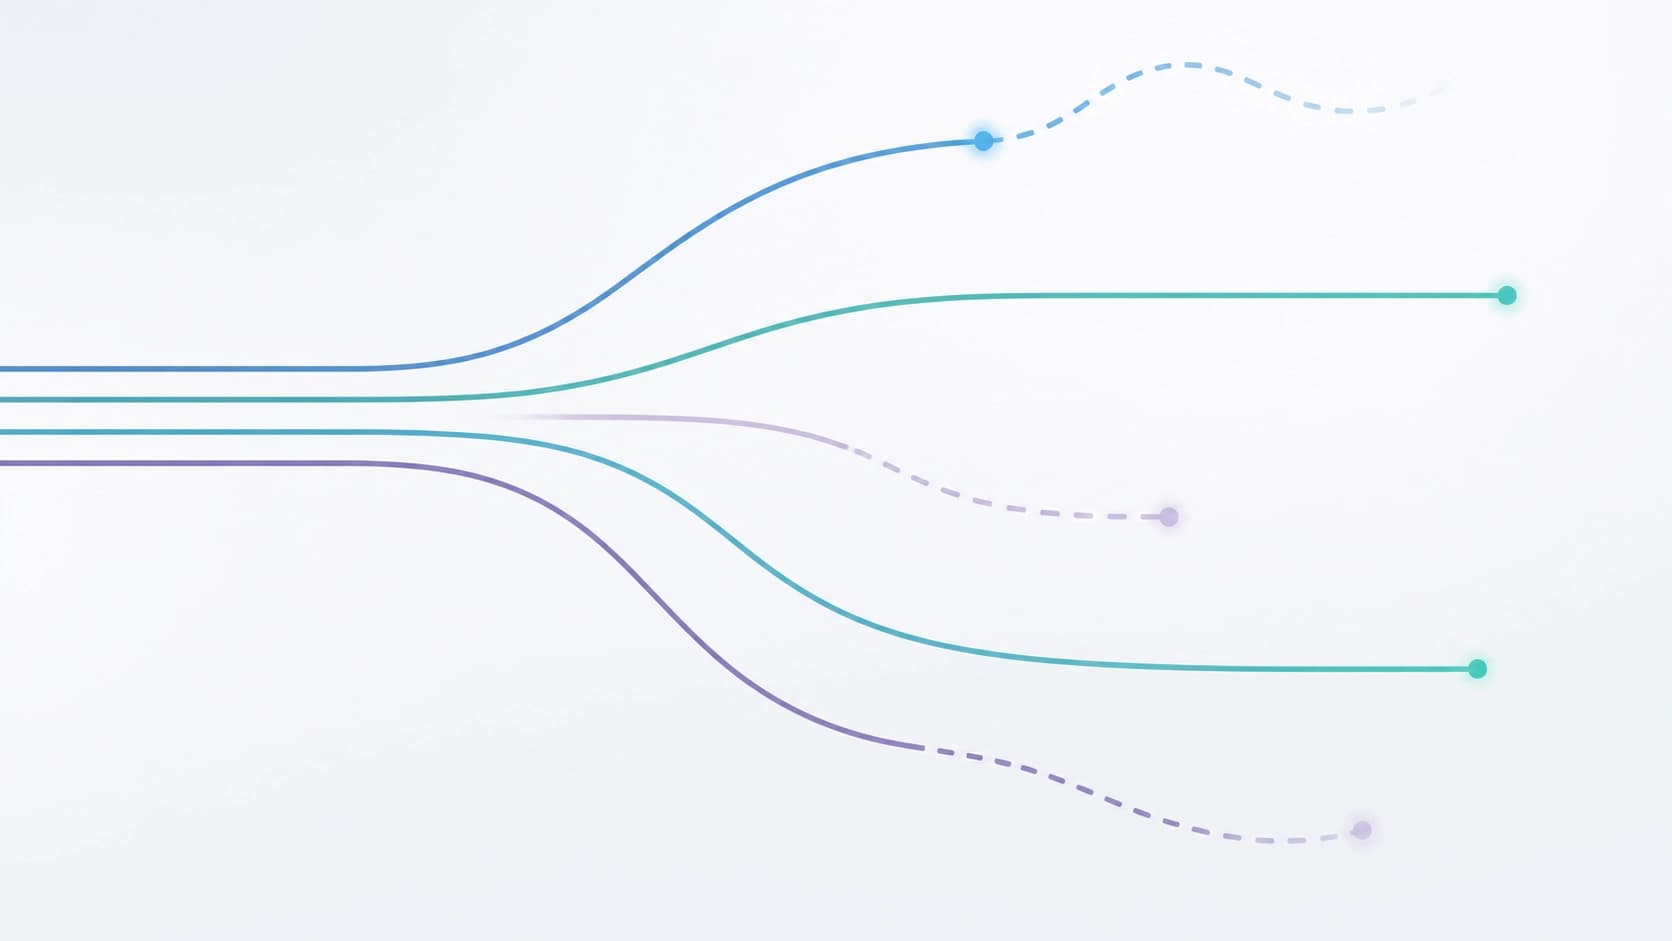
Selective Regenerative Decoding (SRD) বাইনারি পছন্দ পরিত্যাগের প্রস্তাব দেয়। "গ্রহণ বা বাতিল"-এর বদলে প্রতিটি প্রার্থীকে তিনটি শাখার একটিতে পাঠানো হয়:
- বাতিল — যদি চেইনটি শুরু থেকে শেষ পর্যন্ত অকেজো হয়;
- সংরক্ষণ — যদি এটি সম্পূর্ণভাবে যাচাইয়ে উত্তীর্ণ হয়;
- পুনর্গঠন — যদি কার্যকর অংশ থাকে, কিন্তু সাফিক্স স্পষ্টভাবে অবনত হয়েছে।
তৃতীয় ক্ষেত্রে সিস্টেম রিজনিংটি শূন্য থেকে পুনর্লিখন করে না, বরং মানসম্পন্ন প্রিফিক্স সংরক্ষণ করে এবং কেবল নষ্ট হওয়া অংশটি পুনরুৎপাদন করে। এটি নতুন লেখা রচনার চেয়ে খসড়া সম্পাদনার কাছাকাছি: ব্যর্থ সমাপ্তির কারণে আপনি ভালো ভূমিকাটি ফেলে দেন না, বরং যা ভেঙে গেছে তা ঠিক করেন।
লেখকেরা আলাদাভাবে জোর দিয়ে বলেন, এই ধরনের হস্তক্ষেপের জন্য বড় কোনো দাতা-মডেলের প্রয়োজন নেই। কোনো "বুদ্ধিমান শিক্ষক" নয়, যে দুর্বল শিক্ষার্থীকে টেনে তুলবে — পুরো কাজটি বিদ্যমান গণনাসম্পদের মধ্যেই সম্পন্ন হয়। ঠিক এটিই পদ্ধতিটিকে প্রয়োগযোগ্য করে তোলে, তাত্ত্বিক অনুশীলনে পরিণত করে না।
লাভ কোথা থেকে আসে
গবেষণাপত্রে সবচেয়ে আকর্ষণীয় বিষয়টি হিউরিস্টিক নয়, বরং তার যৌক্তিক ভিত্তি। নমনীয় অনুমানের অধীনে SRD ক্লাসিক্যাল rejection sampling-এর তুলনায় নমুনা দক্ষতায় ১.২৮–১.৩৬ গুণ প্রমাণযোগ্য বৃদ্ধি দেয়, এবং চূড়ান্ত ট্র্যাজেক্টরির প্রত্যাশিত গুণমান কেবল "খারাপ নয়" নয়, বরং কঠোরভাবে উচ্চতর হয়।
সূত্র ছাড়াই এখানে অন্তর্দৃষ্টিটি স্পষ্ট। সাফিক্স পুনরুৎপাদনের মধ্য দিয়ে যাওয়া একটি প্রার্থীর মধ্যে ইতিমধ্যেই পরিশোধিত গণনা রয়েছে — প্রিফিক্সের সেই টোকেনগুলো, যেগুলো নতুন করে তৈরি করতে হয় না। যত বেশি এমন সীমান্তবর্তী প্রার্থী রক্ষা করা যায়, তত কম অনুপাতে উৎপন্ন টেক্সট ঝুড়িতে যায়। আর যেহেতু প্রার্থী-পুল বাড়ার সাথে সাথে "প্রায়-সফল" চেইনের সংখ্যাও বাড়ে, লাভটি স্থির থাকে না — এটি উৎপাদনের বাজেটের সাথে স্কেল করে।
এটি কোথায় পরীক্ষা করা হয়েছে
পরীক্ষামূলক অংশটি চার ধরনের ভিন্ন কাজের চাপ কভার করে: MATH500 (গাণিতিক সমস্যা), GPQA Diamond (বৈজ্ঞানিক পর্যায়ের প্রশ্ন), HotpotQA (নথিভিত্তিক বহু-ধাপীয় প্রশ্ন) এবং AlpacaEval (নির্দেশনা অনুসরণ ও পছন্দ মূল্যায়ন)। পরীক্ষাটি "জেনারেটর + reward-মডেল"-এর একাধিক সমন্বয়ে চালানো হয়েছিল, যাতে ফলাফল একটি সফল জোড়ার উপর নির্ভরশীল না হয়।
ঘোষিত ফলাফল: SRD এমন নির্ভুলতায় পৌঁছায় যা সাধারণত Best-of-N মোডে পাওয়া যায়, কিন্তু লক্ষণীয়ভাবে কম উৎপন্ন টোকেন ব্যয় করে। আর সীমিত গণনার পরিস্থিতিতে পদ্ধতিটি speculative rejection-কে ছাড়িয়ে যায় — অর্থাৎ ঠিক সেখানেই জেতে, যেখানে প্রতিটি অতিরিক্ত টোকেন ব্যয়বহুল।
এটি মূলত কী পরিবর্তন করে
লেখকেরা যে প্রধান পরিবর্তনটি চিহ্নিত করেন, তা পদ্ধতিগত। আগে নির্বাচন ঘটত সম্পূর্ণ ট্র্যাজেক্টরির স্তরে: reward-মডেল একটি মূল্যায়ন দিত এবং পুরো রিজনিংয়ের ভাগ্য নির্ধারণ করত। SRD হস্তক্ষেপকে ট্র্যাজেক্টরির অভ্যন্তরে, সেগমেন্টের স্তরে নিয়ে যায়, এবং এর ফলে নির্ভুলতা ও গণনার মধ্যে সমঝোতার এমন একটি ক্ষেত্র উন্মোচন করে, যা এখন পর্যন্ত প্রায় অনাবিষ্কৃত ছিল।
যারা ইনফারেন্স-পাইপলাইন তৈরি করেন তাদের জন্য ব্যবহারিক উপসংহার: রিজনিংয়ের গুণমান এবং তা পাওয়ার খরচ অপরিহার্যভাবে কঠোরভাবে সম্পর্কিত রাশি নয়। মডেলের খসড়াকে একক অখণ্ড বস্তু হিসেবে দেখা বন্ধ করলে "অতিরিক্ত" গণনার একটি অংশ ফিরে পাওয়া সম্ভব।
যা পর্দার আড়ালে থেকে যায়
খোলা প্রশ্নের অভাব নেই। মূলটি হলো — সুস্থ প্রিফিক্স এবং অবনত সাফিক্সের মধ্যে সীমানা ঠিক কীভাবে নির্ধারিত হয়: এই মানদণ্ডের উপর নির্ভর করে কতজন প্রার্থী আদৌ তৃতীয় শাখায় পড়বে। এরপর — পুনরুৎপাদনের নিজস্ব খরচ (এটি বিনামূল্যে নয়), reward-মডেল নির্বাচনের প্রতি সংবেদনশীলতা এবং ব্যবহৃত চারটি বেঞ্চমার্কের বাইরে সিদ্ধান্তগুলোর স্থানান্তরযোগ্যতা।
গবেষণাপত্রটি ২০ পৃষ্ঠার এবং ARR-এ জমা দেওয়া হয়েছে, অর্থাৎ এটি এখনো প্রথম সংস্করণের প্রিপ্রিন্ট, পুনঃপর্যালোচিত ফলাফল নয়। তবে দিকটি সম্ভাবনাময় মনে হচ্ছে: আরও বেশি উৎপাদন করে কঠোরভাবে বাছাই করার বদলে, মডেল যা ইতিমধ্যে ভেবেছে তা আরও সুচারুভাবে কাজে লাগানো যেতে পারে।