
পাইপলাইনের ত্রুটিগুলো কেন আলাদা করে ভাগ করা দরকার
একটি RAG সিস্টেমকে একটি সংখ্যায় মূল্যায়ন করা সুবিধাজনক, কিন্তু প্রায় অকেজো। এন্ড-টু-এন্ড মেট্রিক এই প্রশ্নের উত্তর দেয় "উত্তরটি প্রত্যাশার সাথে মিলেছে কি না", কিন্তু এই প্রশ্নের উত্তর দেয় না "কেন তা মিলেছে বা মেলেনি"। অথচ RAG কোনো একক ব্লক নয়, বরং একটি শৃঙ্খল: প্রথমে বেস থেকে কিছু খুঁজে পাওয়া যায়, তারপর সিস্টেম সিদ্ধান্ত নেয় পাওয়া জিনিস যথেষ্ট কি না, এবং কেবল তারপর জেনারেটর টেক্সট লেখে। যেকোনো স্তরে ব্যর্থতা আউটপুটে সমানভাবে "ভুল" উত্তর দেয়, যদিও এই ধরনের দুটি ব্যর্থতার কারণ সম্পূর্ণ বিপরীত হতে পারে।
ঠিক এই সমস্যাটিই নিজের কাঁধে নিয়েছে The RAT: A Unified Bayesian Model for RAG Evaluation (arXiv:2608.24753, cs.CL বিভাগ, ২৫ আগস্ট ২০২৬-এ জমা দেওয়া)। লেখকরা — Pius von Däniken, Felix Matthias Saaro, Mark Cieliebak এবং Jan Deriu — প্রস্তাব করেন পুরো পাইপলাইনকে একসাথে মাপার বদলে এটিকে একটি সম্ভাব্যতা মডেল হিসেবে বর্ণনা করতে, যেখানে প্রতিটি ধাপ নিজস্ব সংযোগসহ একটি আলাদা র্যান্ডম চলক। এরপর সিস্টেমের মূল্যায়ন একটি ইনফারেন্স সমস্যায় পরিণত হয়: কোন লুকানো চলকগুলোর মান observed-উত্তর ও লেবেলগুলোকে সবচেয়ে বিশ্বাসযোগ্যভাবে ব্যাখ্যা করে।
বায়েসিয়ান ফ্রেমওয়ার্কটি ঠিক কী মডেল করে
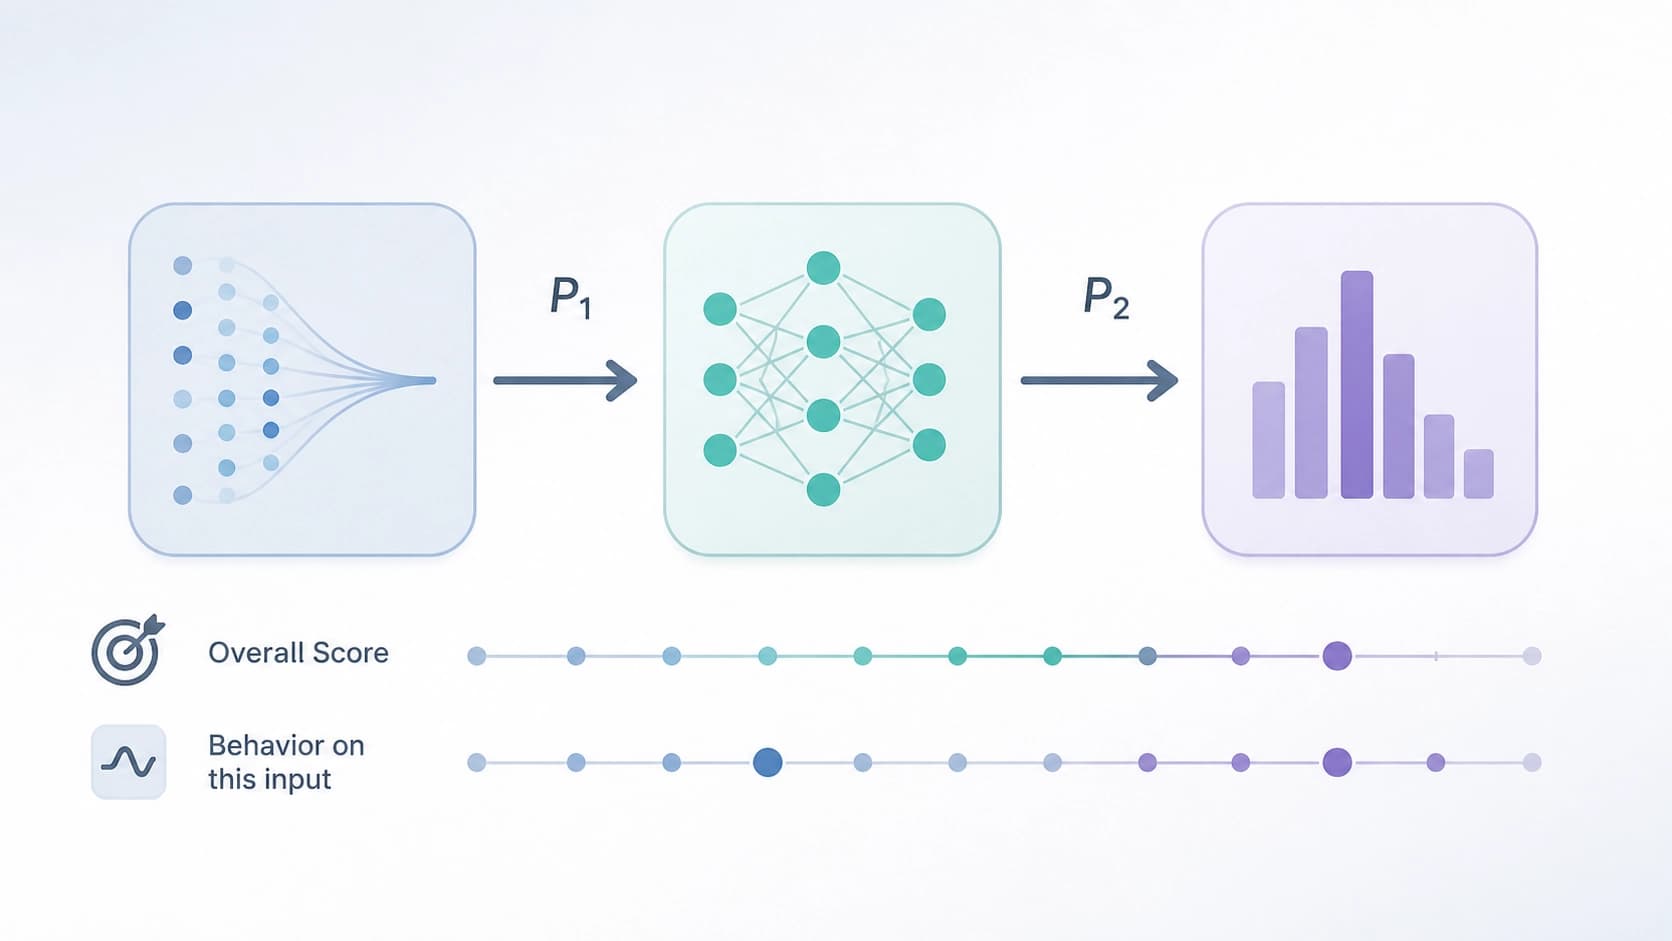
মূল ধারণা — তথ্যপ্রবাহ অনুযায়ী ফ্যাক্টরাইজেশন। চলকগুলো যন্ত্রের মতো "পাইপলাইনের উপাদান অনুযায়ী" প্রবর্তিত হয় না, বরং যে ক্রমে তথ্য সত্যিই সিস্টেমের মধ্য দিয়ে চলে সেই ক্রমে: অনুসন্ধানের সাফল্য প্রভাব ফেলে জেনারেটরের কেমন আচরণ করা উচিত তার উপর, আর জেনারেটরের আচরণ অনুসন্ধানের ফলাফলের সাথে মিলে উত্তরের চূড়ান্ত সঠিকতা নির্ধারণ করে। এমন কাঠামো নির্ভরতাগুলোকে স্পষ্ট করে তোলে, সমষ্টিগত স্কোরের ভেতরে লুকিয়ে রাখে না।
এভাবে The RAT মডেল তিনটি অর্থবহ স্তর পায়, যেগুলো সাধারণত একটি সূচকে মিলিয়ে ফেলা হয়।
Task success এবং generator success — এরা ভিন্ন প্রশ্ন
প্রথম স্তর — task success: ব্যবহারকারী শেষ পর্যন্ত সঠিক উত্তর পেয়েছে কি না। দ্বিতীয়টি — generator success: ইনপুটে যা পেয়েছে তার প্রেক্ষিতে জেনারেটর যথাযথ আচরণ করেছে কি না। আনুষ্ঠানিকভাবে দ্বিতীয়টি একটি শর্তসাপেক্ষ গুণ: প্রদত্ত অনুসন্ধান-ফলাফলের প্রেক্ষিতে মডেলের আচরণ কতটা উপযুক্ত, সাধারণভাবে নয়।
পার্থক্যটি মৌলিক। খারাপ অনুসন্ধন সত্ত্বেও সিস্টেম সঠিক উত্তর দিতে পারে — জেনারেটর প্যারামেট্রিক মেমোরি থেকে অনুমান করে ফেলেছে। আনুষ্ঠানিকভাবে এটি কার্যসাফল, কিন্তু আচরণটি ছিল অনুপযুক্ত: সিস্টেম উৎসের উপর নির্ভর না করেই উত্তর দিয়েছিল, আর অন্য কোনো প্রশ্নে এই অভ্যাস হ্যালুসিনেশনে পরিণত হবে। আবার উল্টোটাও: অনুসন্ধান প্রয়োজনীয় সবকিছু খুঁজে পেয়েছে, জেনারেটর সযত্নে উত্তর দিয়েছে — তবুও ফলাফল ভুল, কারণ প্রশ্নটি ভুলভাবে বোঝা হয়েছিল। এন্ড-টু-এন্ড মেট্রিক এই দুটি ক্ষেত্র আলাদা করে না, শর্তসাপেক্ষ মেট্রিক করে।
বিরত থাকা — ব্যর্থতা নয়, একটি সিদ্ধান্ত
মডেলের তৃতীয় উপাদান — abstention behavior, বিরত থাকার আচরণ। RAG প্রসঙ্গে উত্তর দিতে অস্বীকৃতি কখনো কখনো একমাত্র সঠিক প্রতিক্রিয়া: বেসে প্রাসঙ্গিক কিছু না থাকলে সৎ "জানি না" আত্মবিশ্বাসী বানানো গল্পের চেয়ে ভালো। কিন্তু সেই একই অস্বীকৃতি ভুল হয়ে দাঁড়ায় যখন প্রয়োজনীয় নথি খুঁজে পাওয়া গিয়েছিল, অথচ সিস্টেম তা ব্যবহার করেনি।
তাই অনুসন্ধান-ফলাফল থেকে বিচ্ছিন্নভাবে বিরত থাকা মূল্যায়ন করা যায় না — কেবল শর্তসাপেক্ষভাবে। The RAT মডেল এটি সরাসরি বিবেচনা করে: এটি দেখে অস্বীকৃতি বা উত্তরের ঘটনাটি প্রসঙ্গে সত্যিই যা ছিল তার সাথে মেলে কি না। এই দৃষ্টিভঙ্গি পণ্য-সিদ্ধান্তের জন্যও উপকারী: সিস্টেম যদি সফল অনুসন্ধনের পরেও ব্যাপকভাবে বিরত থাকে, সমস্যাটি জেনারেটরে নয়, বরং তার কাছে প্রসঙ্গ পৌঁছে দেওয়ার পদ্ধতিতে।
প্রান্তিক মেট্রিকগুলো কেন বিভ্রান্ত করে
লেখকরা ফ্রেমওয়ার্কটি ২৭টি কনফিগারেশনে প্রয়োগ করেছেন — এটি তিনটি ডেটাসেট, তিনটি রিট্রিভার এবং তিনটি জেনারেটর, সব সম্ভাব্য সমন্বয়ে মিলিয়ে দেখা। এখানে সম্পূর্ণ সমন্বয় নিজেই লক্ষ্য নয়: এটি দেখায় ডিকম্পোজিশন কেমন আচরণ করে যখন ঠিক একটি স্তর বদলায় আর বাকিগুলো অপরিবর্তিত থাকে।
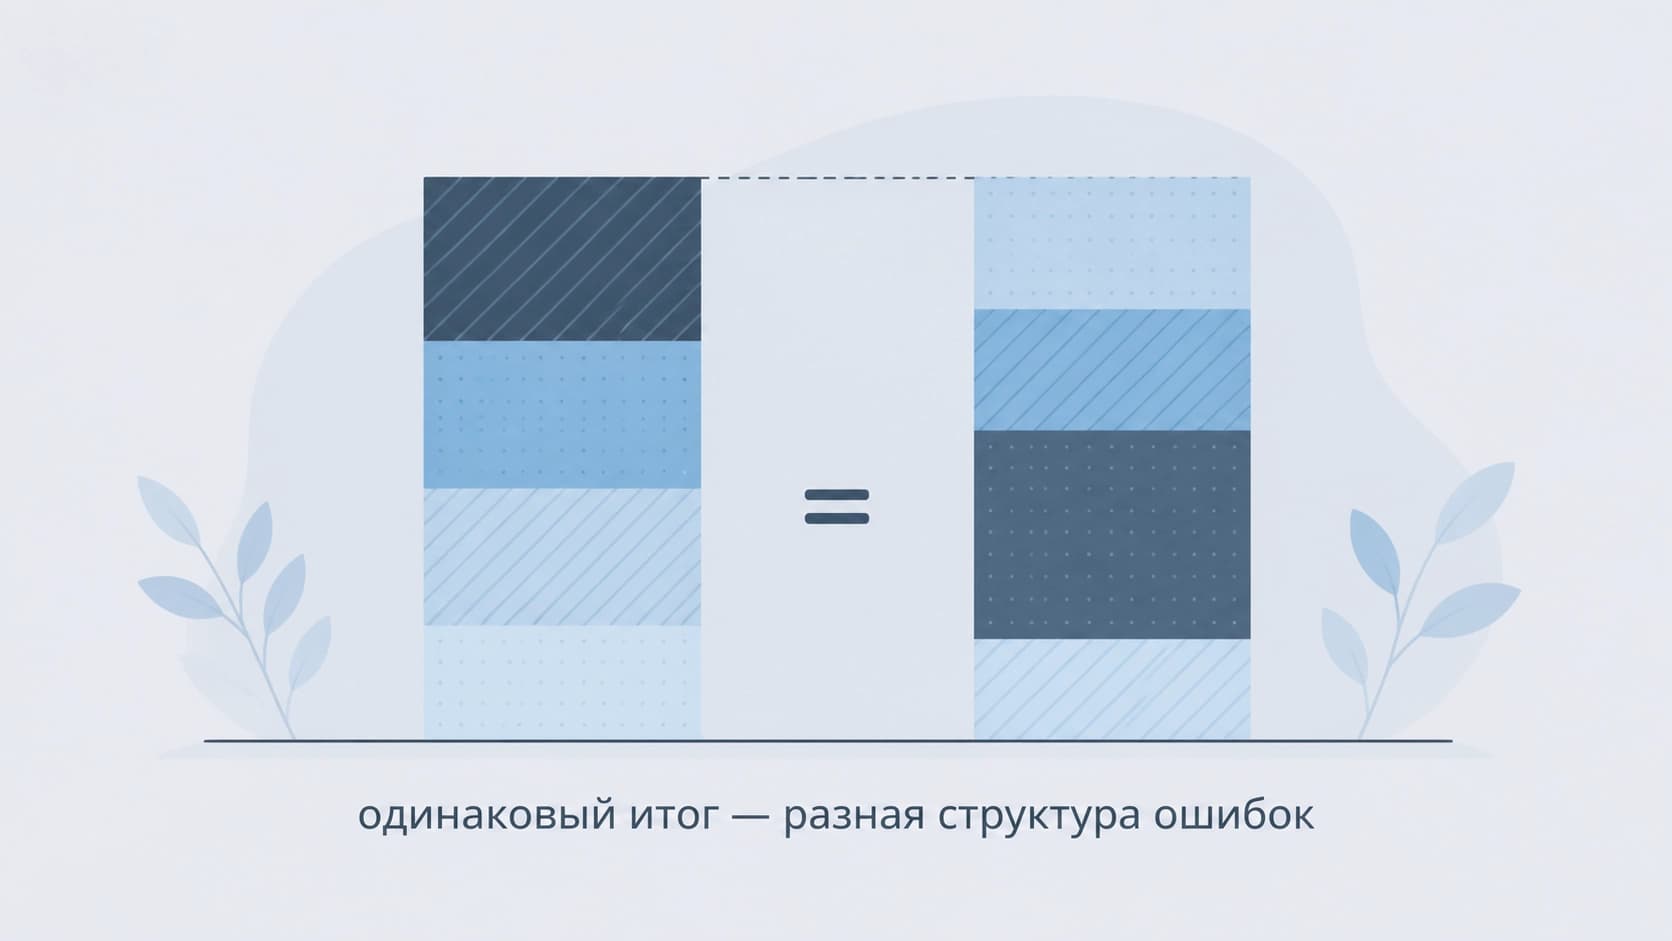
যে ফলাফলের জন্য সবকিছু শুরু করা হয়েছিল: শর্তসাপেক্ষ ডিকম্পোজিশন এমন সিস্টেমগুলোর মধ্যে লক্ষণীয় আচরণগত পার্থক্য উন্মোচন করে, যেগুলো প্রান্তিক মেট্রিকে সমতুল্য দেখায়। দুটি পাইপলাইন একই অনুপাতে সঠিক উত্তর দেখাতে পারে, অথচ ঠিক কোথায় তারা ভুল করছে — অনুসন্ধানে, অস্বীকৃতির নীতিতে নাকি জেনারেশনে — সেই দিক থেকে কয়েক ডজন শতাংশ ক্ষেত্রে ভিন্ন হতে পারে। যে পণ্যের জন্য কনফিগারেশন বাছাই করে, তার কাছে এরা ভিন্ন সিস্টেম; যে টেবিলে একটি সংখ্যার দিকে তাকায়, তার কাছে এরা একই।
লেবেলিং বাজেট কোথায় লাগাবেন
কাজের একটি আলাদা অংশ অ্যানোটেশনের বণ্টনে উৎসর্গ করা। লেবেলিং ব্যয়বহুল, তাই প্রশ্ন করা স্বাভাবিক: প্রতিটি উদাহরণ সম্পর্কে মানুষকে যদি কেবল একটি প্রশ্ন করা যায়, কোন প্রশ্নটি বাছাই করবেন?
লেখকদের উত্তর: অনুসন্ধানের সাফল্য সম্পর্কিত অ্যানোটেশন কার্যসাফল সম্পর্কিত অ্যানোটেশনের চেয়ে বেশি তথ্যবহ, যদি লক্ষ্য হয় সিস্টেমের নীতি-পালন (policy adherence) বিচার করা। কারণটি সুবিধার নয়, বরং মডেলের কাঠামোর: অনুসন্ধানের লেবেল কার্যকারণ-শৃঙ্খলের শুরুতে থাকা চলকের উপর পড়ে, তাই তা থেকে নিচের স্তরগুলোও "আলোকিত" হয়। চূড়ান্ত সাফল্যের লেবেল আউটপুটের চলক সম্পর্কে, আর তা ভেতরে কী ঘটছিল সে সম্পর্কে অনেক কম বলে। লেখকরা এই অসমতুল্য প্রভাবের একটি তথ্য-তাত্ত্বিক ব্যাখ্যা দেন।
ব্যবহারিক উপসংহারটি সহজ: বাজেট সীমিত হলে লেবেলারদের জিজ্ঞাসা করা উচিত "উত্তরটি সঠিক কি না" নয়, বরং "প্রয়োজনীয়টি খুঁজে পাওয়া গেছে কি না"। প্রথমটি রিপোর্টে বেশি সুন্দর শোনায়, দ্বিতীয়টি ডায়াগনোসিসের জন্য বেশি উপকারী।
LLM বিচারক — একটি শব্দযুক্ত পর্যবেক্ষণ হিসেবে
তৃতীয় অংশ — স্বয়ংক্রিয় মূল্যায়নে মডেলের সম্প্রসারণ। The RAT স্কিমা LLM-as-a-judge-এর রায়গুলোকে মানুষের বিকল্প হিসেবে নয়, বরং ক্যালিব্রেটেড শব্দযুক্ত পর্যবেক্ষণ হিসেবে যুক্ত করার সুযোগ দেয়: বিচারকের ভুল করার নিজস্ব সম্ভাবনা আছে, আর তা একই সম্ভাব্যতা মডেলের কাঠামোর মধ্যেই অনুমান করা হয়।
এটি "ব্যয়বহুল মানব-লেবেলিং বনাম সস্তা স্বয়ংক্রিয়" এই কৃত্রিম বিরোধ দূর করে। একটি মডেলে রাখা যায় ছোট একটি বিশেষজ্ঞ-রায়ের কর্পাস, যা মাপকাঠি ও ক্যালিব্রেশন নির্ধারণ করে, আর বড় একটি স্বয়ংক্রিয় মূল্যায়নের প্রবাহ, যা প্যারামিটারগুলো সূক্ষ্ম করে। বিচারক আর ওরাকল থাকে না, বরং আরেকটি সংকেত-উৎসে পরিণত হয় — পরিচিত এবং গুরুত্বপূর্ণভাবে, পরিমাপযোগ্য ত্রুটিসহ।
নিজের চর্চায় কী নেবেন
- পাইপলাইনকে একটি একক নোড হিসেবে গুনবেন না। রিপোর্টে অনুসন্ধানের জন্য আলাদা মেট্রিক, জেনারেটরের আচরণের জন্য আলাদা এবং অস্বীকৃতির জন্য আলাদা মেট্রিক আসার সাথে সাথে "কী ভেঙেছে" নিয়ে বিতর্ক অনুমান-পরীক্ষা নয়, ডায়াগনোসিসে পরিণত হয়।
- শর্তসাপেক্ষভাবে আচরণ মূল্যায়ন করুন। উত্তরের সঠিকতা এবং প্রদত্ত প্রসঙ্গে আচরণের উপযুক্ততা — ভিন্ন প্রশ্ন, আর ভালো ফলাফল খারাপ প্রক্রিয়াকে ন্যায্যতা দেয় না।
- গড় নয়, স্লাইস অনুযায়ী রিপোর্ট তৈরি করুন। একই এন্ড-টু-এন্ড গুণমানের দুটি সিস্টেমের সম্পূর্ণ ভিন্ন উন্নয়ন প্রয়োজন হতে পারে।
- কী লেবেল করবেন তা বাছাই করুন। মানব-সম্পদ সীমিত হলে প্রাথমিক ধাপের লেবেলিং সামগ্রিকভাবে সিস্টেম সম্পর্কে বেশি তথ্য দেয়।
- স্বয়ংক্রিয় মূল্যায়নকে শিকল দিয়ে রাখুন। LLM বিচারক একটি ত্রুটি-মডেলসহ পর্যবেক্ষণ হিসেবে উপকারী, চূড়ান্ত সত্য হিসেবে নয়।
এখানে বায়েসিয়ান দৃষ্টিভঙ্গি মূল্যবান গণিত হিসেবে নয়, বরং চিন্তার শৃঙ্খলা হিসেবে: এটি আগে থেকেই নাম বলতে বাধ্য করে কোন রাশিগুলো লুকানো, কোনগুলো পর্যবেক্ষণযোগ্য এবং একটির সাথে অন্যটির সম্পর্ক কী। এরপর ফলাফলের যেকোনো টেবিল আর সংখ্যার সমষ্টি থাকে না, বরং সিস্টেম কীভাবে সিদ্ধান্ত নেয় তার বর্ণনায় পরিণত হয়।


