
সংক্ষেপে: ঠিক কী প্রকাশ করা হয়েছে
২০২৬ সালের আগস্টের শেষে LAION দল LAION-BVD প্রকাশ করেছে — একটি উন্মুক্ত ভিডিও কর্পাস, যা প্রিপ্রিন্টে মাল্টিমোডাল প্রশিক্ষণের জন্য অভূতপূর্ব পরিসরের ডেটাসেট হিসেবে বর্ণিত হয়েছে। কাজটি arXiv-তে প্রকাশিত হয় ২০২৬ সালের ২৫ আগস্ট, বিভাগগুলো — কম্পিউটার ভিশন, কৃত্রিম বুদ্ধিমত্তা এবং মেশিন লার্নিং।
শুকনো সংখ্যাগুলো দেখতে এমন:
- ১.৩ বিলিয়ন ভিডিও লিংক — সংগ্রহের সূচনা বিন্দু, লিংকগুলো CommonCrawl ওয়েব-ক্রল থেকে বের করা এবং নির্দিষ্ট প্ল্যাটফর্মের সাথে যুক্ত;
- ৮০ মিলিয়ন ক্লিপ আসলে এই লিংকগুলো থেকে ডাউনলোড করা হয়েছে — ইনডেক্সে যা পাওয়া গেছে সবই ডাউনলোড পর্যন্ত টিকেনি;
- ১০ মিলিয়ন ঘণ্টা মোট দৈর্ঘ্য।
শেষ সংখ্যাটা মাথায় ধরে রাখা কঠিন: এটি এক হাজার বছরেরও বেশি নিরবচ্ছিন্ন দেখার সমান। ঠিক এ কারণেই রিলিজটিকে এমন একটি পরিবর্তন বলা হচ্ছে যা কর্পোরেট বাজেট ছাড়াই গবেষকদের জন্য এখন доступно — আগে সমপরিমাণ ভিডিও কর্পাস বন্ধ ল্যাবরেটরির ভেতরেই থেকে যেত।
এটি কীভাবে সংগ্রহ করা হয়েছে
লিংক থেকে প্রস্তুত ক্লিপ পর্যন্ত
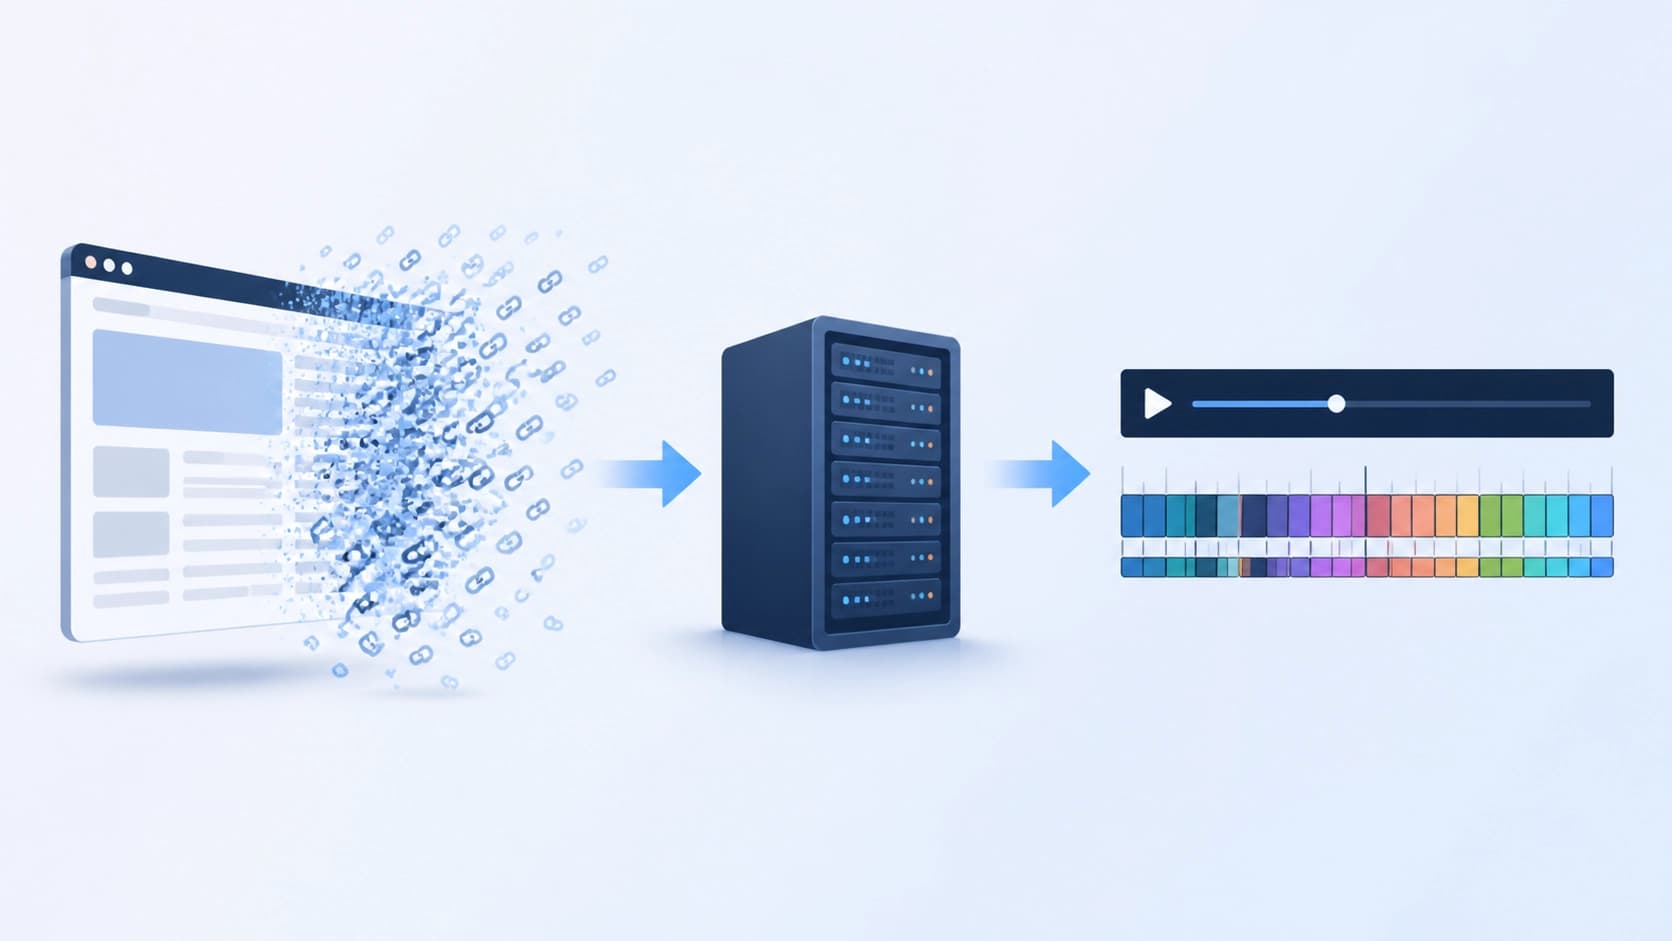
পাইপলাইনে কয়েকটি ধাপ আছে, এবং প্রতিটি নিজস্বভাবে গুরুত্বপূর্ণ। প্রথমে লিংকগুলো বাছাই করে একক রূপে আনা হয়। তারপর শুরু হয় ব্যাপক ডাউনলোড। এরপর আসে দৃশ্য শনাক্তকরণ, যা ফ্রেমের বিষয়বস্তুর প্রতি সংবেদনশীল: দীর্ঘ ভিডিও নির্দিষ্ট টাইমকোড অনুযায়ী নয়, বরং প্রকৃত এডিটিং জোড়ের জায়গায় কাটা হয়।
এরপরই সবচেয়ে মজার অংশ। প্রাপ্ত ক্লিপগুলোর জন্য ক্যাপশন সিন্থেটিকভাবে, স্বয়ংক্রিয়ভাবে এবং একসাথে দুটি মোডালিটিতে তৈরি হয়: ভিডিও ধারাবাহিকের জন্য একটি টেক্সট জোড়া এবং অডিও ট্র্যাকের জন্য আলাদা একটি। অর্থাৎ এখানে অডিও কোনো পার্শ্বপণ্য নয়, বরং একটি পূর্ণাঙ্গ প্রশিক্ষণ সংকেত।
চূড়ান্ত কাঠামোটি একসাথে তিন ধরনের ডেটার প্রি-ট্রেনিংয়ের জন্য তৈরি: ভিডিও, অডিও এবং ছবি।
ফ্রেম একটি আলাদা সম্পদ হিসেবে
লেখকরা ক্লিপেই সীমাবদ্ধ থাকেননি। দৃশ্যগুলো থেকে পরিবর্তনের মুহূর্তের সাথে সঙ্গতিপূর্ণ ফ্রেম বের করা হয় এবং সেগুলোকে "ছবি — টেক্সট" জোড়ার স্বতন্ত্র উৎস হিসেবে উপস্থাপন করা হয়। যুক্তিটি সরল: ভিডিও ধারাবাহিক সাধারণ ওয়েব-ছবির সংগ্রহ থেকে ভিজ্যুয়াল জগতের ভিন্ন একটি অংশ দেয় — ভিন্ন বিষয়বস্তু, দৃষ্টিকোণ এবং দৈনন্দিন বিবরণের বিন্যাসসহ। ছবি অনুসন্ধানের কাজে এই বিন্যাস-পরিবর্তন আগের মতো একই উৎস থেকে আরও দশ লাখ ছবির চেয়ে বেশি কাজে লাগতে পারে।
পরীক্ষাগুলো কী দেখিয়েছে
ভিডিও ও শব্দ
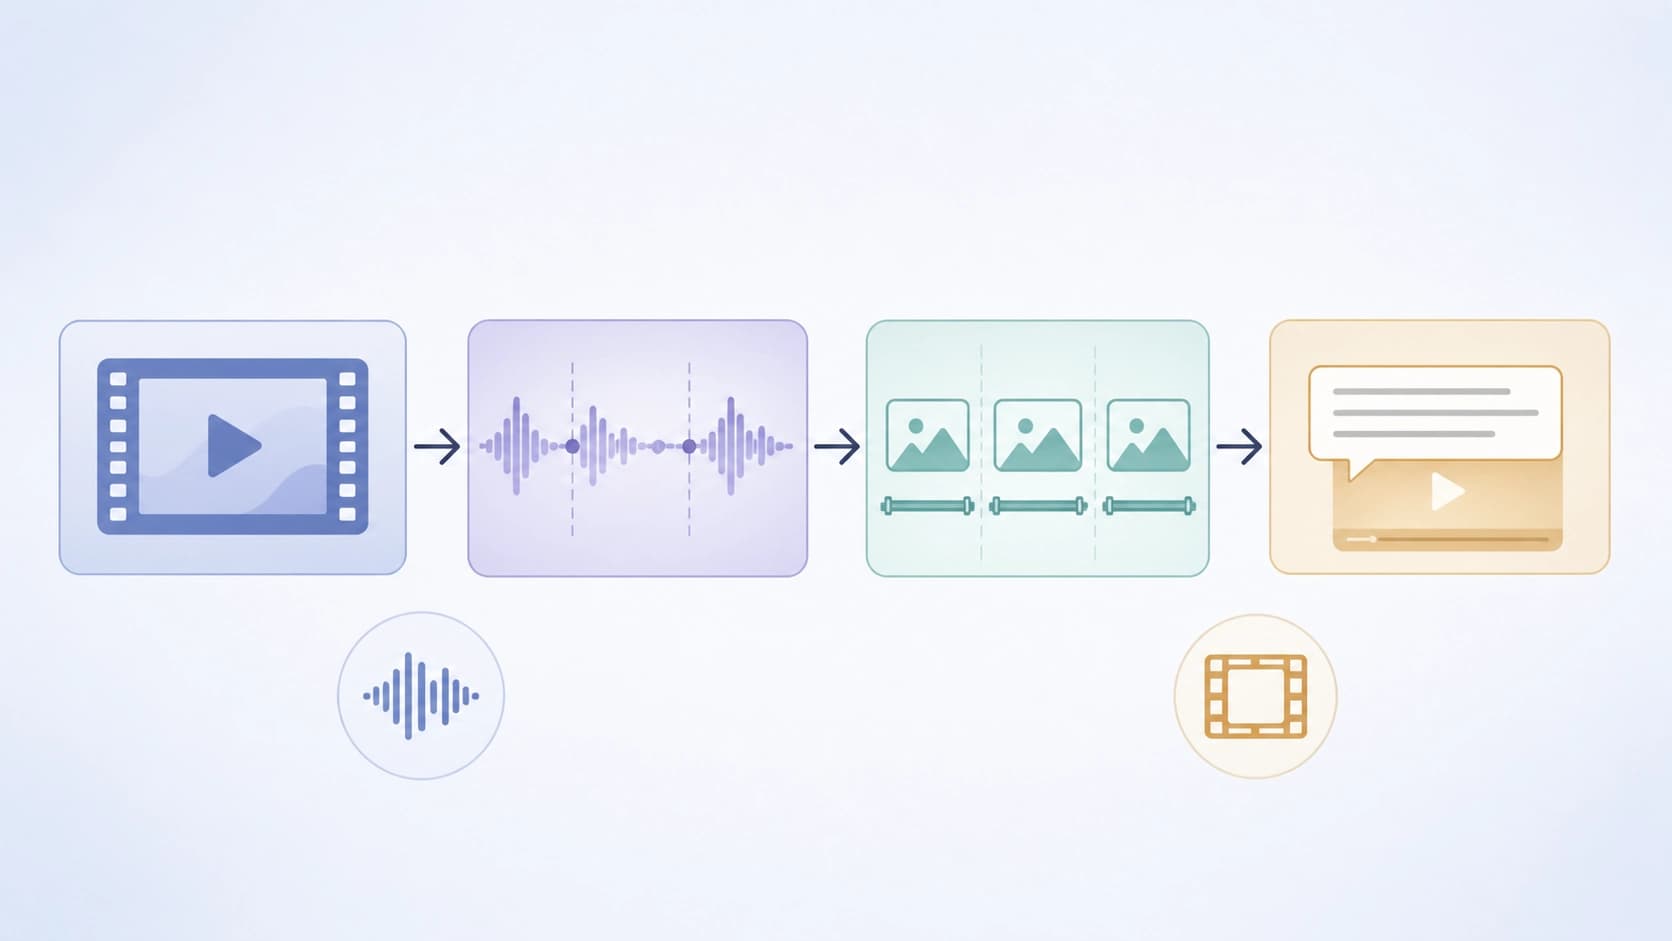
নতুন কর্পাসে প্রশিক্ষিত মডেলগুলো "ভিডিও — টেক্সট" এবং "অডিও — টেক্সট" জোড়ার স্ট্যান্ডার্ড বেঞ্চমার্কে প্রতিযোগিতামূলক স্তরে পৌঁছায়। আরও গুরুত্বপূর্ণ হলো: ডেটার পরিমাণ বা মডেলের আকার বাড়ালে গুণমান স্থিরভাবে বাড়ে। এটিই সেই লক্ষণ যা "শুধু বড়" একটি ডেটাসেট এবং আরও স্কেল করার যোগ্য একটি ডেটাসেটের মধ্যে পার্থক্য করে।
ছবি
পরীক্ষার আলাদা একটি ধারা — বের করা ফ্রেমে প্রশিক্ষণ। এখানেও ফলাফল ইতিবাচক: ছবি অনুসন্ধানে শক্তিশালী ফলাফল। আর তা সত্ত্বেও যে ফ্রেমগুলোর বিন্যাস প্রচলিত ওয়েব-কর্পাস থেকে স্পষ্টভাবে আলাদা — অর্থাৎ লাভ আসে পরিমাণ থেকে নয়, বরং ভিজ্যুয়াল ডেটার ভিন্ন প্রকৃতি থেকে।
যা মনে রাখা উচিত
- ক্যাপশনগুলো সিন্থেটিক: এগুলো হাজার হাজার মানব-ঘণ্টা বাঁচায়, কিন্তু শব্দ এবং পদ্ধতিগত ত্রুটি নিয়ে আসে। এখানে ফিল্টারিংয়ের গুণমান কর্পাসের আকারের চেয়ে বেশি গুরুত্বপূর্ণ।
- সংগ্রহ ওয়েব-লিংক থেকে শুরু হয়, তাই এই ধরনের প্রকল্পের স্বাভাবিক প্রশ্নগুলো ওঠে: লিংকের দীর্ঘস্থায়িত্ব, উৎসের ব্যবহারের শর্তাবলি, অ্যাট্রিবিউশন। ডেটাসেটের উন্মুক্ত লাইসেন্স মূল উৎস সম্পর্কিত প্রশ্নগুলো দূর করে না।
- কর্পাসটি গবেষণা রিলিজ হিসেবে ঘোষিত — বাস্তবে এর অর্থ হলো প্রবেশের সীমা অভ্যন্তরীণ কর্পোরেট সেটের চেয়ে কম, তবে অন্যের ফলাফলের পুনরুৎপাদনযোগ্যতা তবুও নিজ হাতে যাচাই করতে হবে।
এটি কেন গুরুত্বপূর্ণ
এত পরিমাণে উন্মুক্ত মাল্টিমোডাল ভিডিও এখন পর্যন্ত প্রতিশ্রুতির চেয়ে বাস্তবতা ছিল কম: একাডেমিক সেটগুলো হাজার ঘণ্টায় মাপা হতো, আর যা মিলিয়নে মাপা হতো তা কোম্পানিগুলোর ছিল এবং বাইরে আসত না। LAION-BVD এই হিসাব বদলে দেয় — এবং তার সাথে নিজেদের মডেল তৈরি করা সবার জন্য মানদণ্ডও।
ব্যবহারিক পরিণতি কয়েকটি। প্রথমত, সৎ তুলনার একটি ভিত্তি তৈরি হয়: সবাই যদি একই উন্মুক্ত কর্পাসে প্রশিক্ষণ নেয়, তবে কার ফলাফল ভালো তা নিয়ে বিতর্ক আরও অর্থবহ হয়। দ্বিতীয়ত, ছোট দল এবং বিশ্ববিদ্যালয়গুলোর জন্য অন্যের এমবেডিং ভাড়া নেওয়ার একটি বিকল্প তৈরি হয় — নিজেরটা প্রশিক্ষণ দেওয়া যায়। তৃতীয়ত, অডিও আর ভিডিওর পরিশিষ্ট থাকে না এবং নিজস্ব প্রশিক্ষণ ধারা পায়।
মূল প্রশ্ন এখন আর ডেটা যথেষ্ট আছে কি না তা নয়, বরং কে প্রথম সেগুলো পরিষ্কার করতে শিখবে। সিন্থেটিক ক্যাপশন, কয়েক কোটি ক্লিপ এবং নমুনায় অনিবার্য আবর্জনা ফিল্টারিং ও গুণমান মূল্যায়নকে পুরো উদ্যোগের সংকীর্ণ বিন্দুতে পরিণত করে। ডেটাসেট উন্মুক্ত — এরপর সবকিছু নির্ভর করে কমিউনিটির উপর।


