
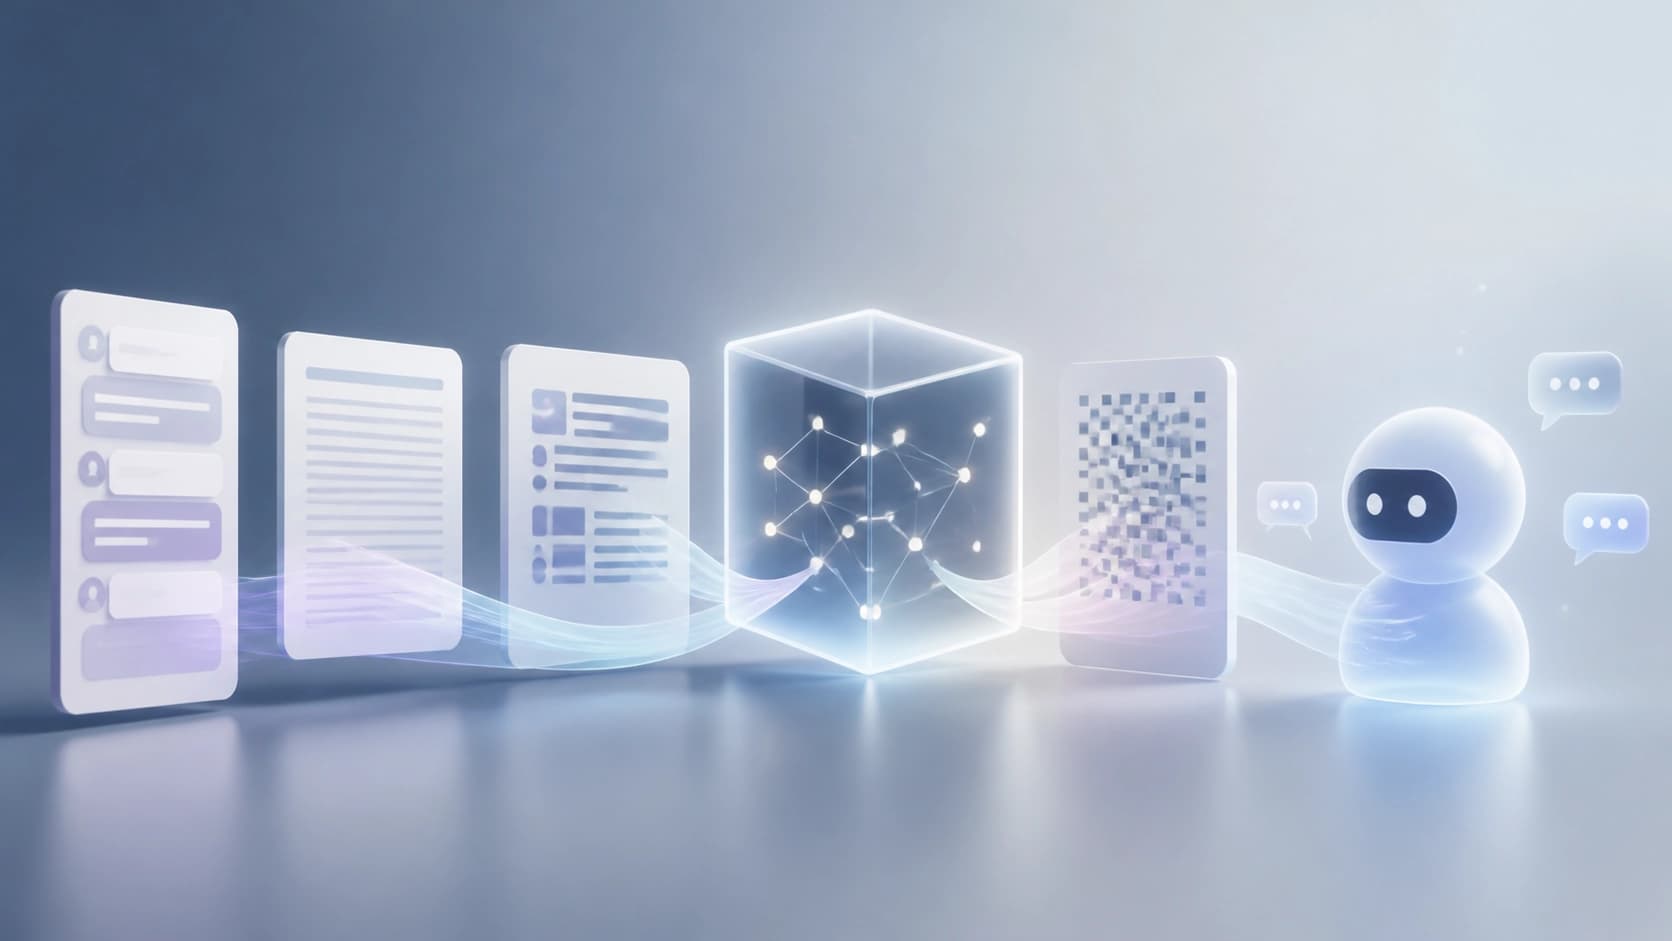
কেন উপস্থাপনার ধরনটা কোনো বাস্তবায়নের খুঁটিনাটি নয়
যখন আমরা কোনো ভাষা মডেলের মেমোরি বা RAG-পাইপলাইনের গুণমান যাচাই করি, তখন সাধারণত আমাদের আগ্রহের কেন্দ্রে থাকে ঠিক একটা জিনিস: মডেল কি প্রয়োজনীয় তথ্যটা পর্যন্ত পৌঁছাতে পেরেছে? আর সেই তথ্যটা ইনপুট কনটেক্সটে কোন রূপে এসেছে — আলাদা মেমোরি এন্ট্রি হিসেবে, সংক্ষিপ্ত সারাংশ হিসেবে, ফিল্ডসহ কাঠামোবদ্ধ রেকর্ড হিসেবে, নাকি কথোপকথনের কাঁচা টুকরো হিসেবে — সেটাকে সাধারণত সিস্টেমের অভ্যন্তরীণ ব্যাপার হিসেবেই ধরে নেওয়া হয়। যুক্তিটা সহজ: তথ্যটা যদি থাকে, তাহলে সেটা কীভাবে মোড়ানো হলো, তা গুরুত্বপূর্ণ নয়।
arXiv:2608.23568 প্রিপ্রিন্টের লেখকেরা এতে দ্বিমত পোষণ করার প্রস্তাব দিয়েছেন। তাঁদের কাজ «RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation» (Yuan Si, Simeng Han, Daming Li, Jialu Zhang; ৫ জুন ২০২৬-এর v1) এই ধারণার ওপরই আঘাত হানে যে মেমোরির জন্য একটা সৎ ও সর্বজনীন মূল্যায়ন আছে। বরং তাঁরা এটাকে সেভাবেই মাপার প্রস্তাব করেন, যেভাবে কনফিগারেশনের প্রতি সংবেদনশীল অন্য বৈশিষ্ট্যগুলো মাপা হয়: একটা ভেরিয়েবল স্থির রেখে অন্যটার মান বদলে বদলে দেখা।
RENDER আসলে কী নিয়ন্ত্রণ করে
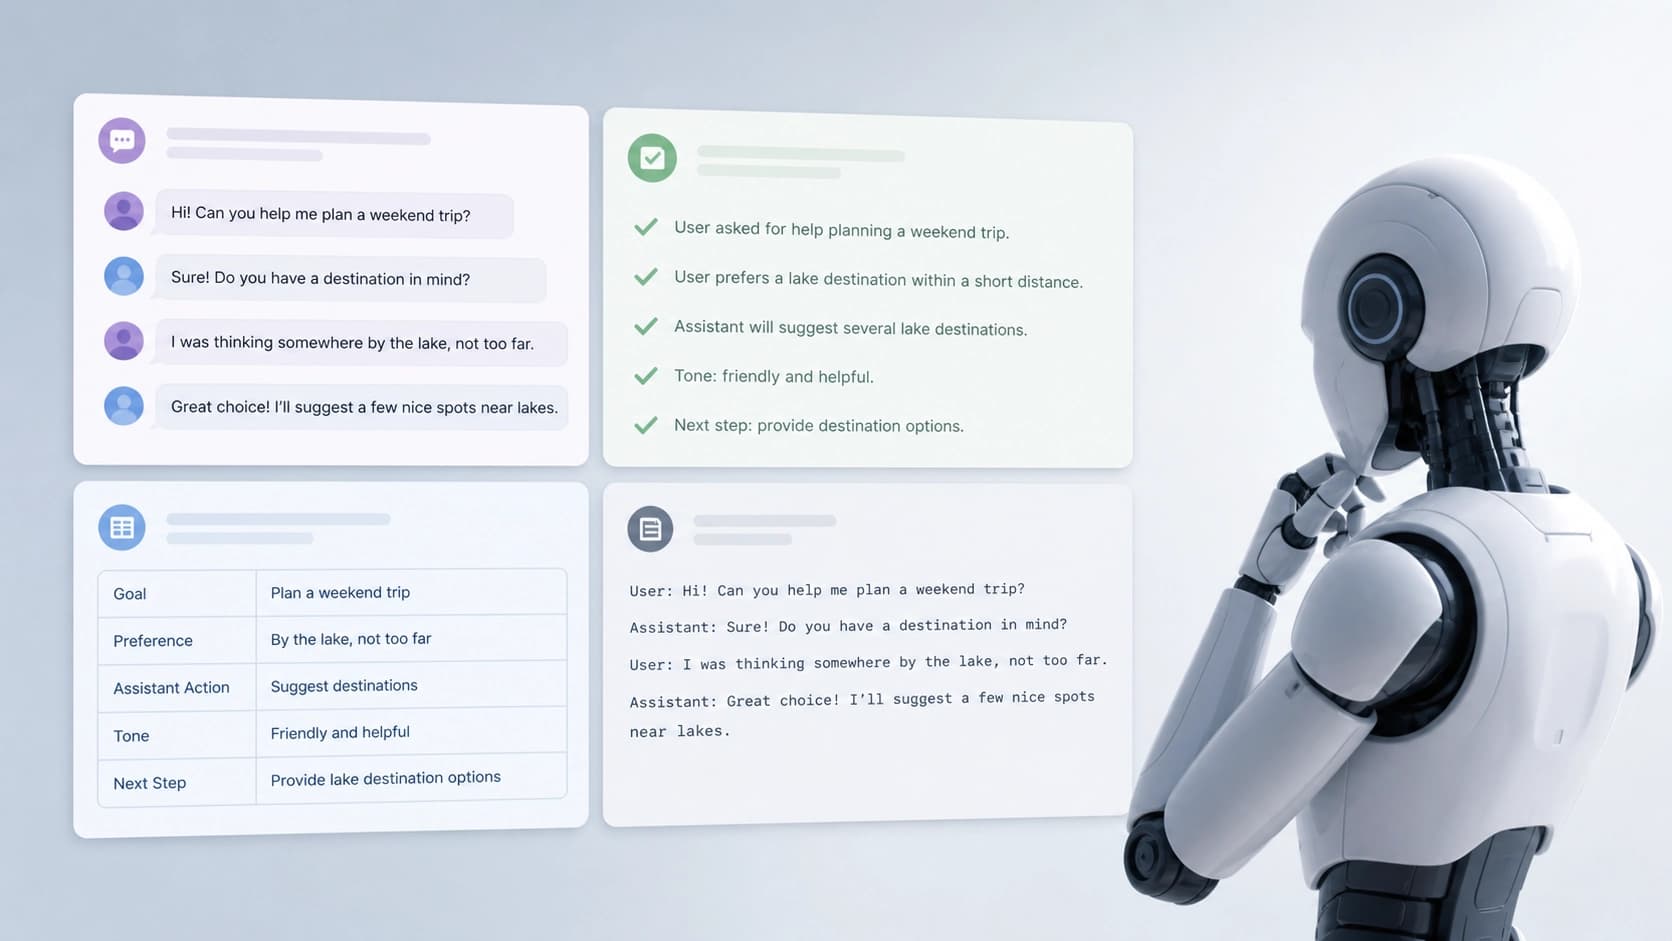
সংলাপ বদলায় না। বদলায় শুধু পাঠকের সামনে উপস্থাপিত আর্টিফ্যাক্ট: অর্থাৎ উত্তরদাতা মডেলটি আসলে যা দেখে। এই স্তরটাকেই — reader-facing artifact — RENDER একটি নিয়ন্ত্রণযোগ্য ভেরিয়েবল বানায়।
পাঁচ স্তরের সিঁড়ি
পদ্ধতির মূল হলো five-level packet ladder। এটা শুধু কিছু ফরম্যাটের সমাহার নয়, বরং একটা স্কেল, যা সেই মুহূর্তটা চিহ্নিত করে যখন উত্তরবাহী কনটেন্ট উত্তরদাতা মডেলের ইনপুটে ঢোকে। উদ্দেশ্য হলো দুই ধরনের সম্পূর্ণ আলাদা ব্যর্থতাকে পৃথক করা: সিস্টেম প্রয়োজনীয় তথ্য খুঁজে পায়নি, আর সিস্টেম তথ্যটা পেয়েছে কিন্তু উপযুক্ত রূপে পৌঁছে দিতে পারেনি। এমন স্কেল ছাড়া এই দুই ক্ষেত্রেই রিপোর্টের একই লাইনে মিলিয়ে যায়, আর তারপর শুরু হয় ভুল সিদ্ধান্ত — যেমন ধরে নেওয়া হয় মডেল «ভালোভাবে মনে রাখে না», অথচ আসলে সে শুধু মোড়কটা বুঝতে পারেনি।
উপস্থাপনার চারটি টেমপ্লেট
দ্বিতীয় উপাদান হলো নির্ধারিত টেমপ্লেট, যা ব্যবহারকারীর কাছে ইতিহাস দেখানোর প্রচলিত উপায়গুলোর আনুমানিক রূপ। এগুলো চারটি:
- ChatGPT-ধাঁচের এন্ট্রি — পরিচ্ছন্ন ব্লক, চ্যাটবট ইন্টারফেসে মানুষ যা দেখে তার মতো;
- LangChain-ধাঁচের সারাংশ — সংক্ষিপ্ত পুনর্কথন, যা শব্দচয়ন হারায় কিন্তু মর্ম ধরে রাখে;
- MemGPT-ধাঁচের টাইপযুক্ত এন্ট্রি — ফিল্ড ও ক্যাটাগরিসহ কাঠামো, মেশিন প্রক্রিয়াকরণের জন্য সুবিধাজনক;
- কাঁচা সংলাপ — যেমন আছে তেমন বক্তব্য, কোনো মার্কআপ বা পুনর্মোড়ন ছাড়া।
টেমপ্লেটগুলো নির্ধারিত: একই ইনপুট প্রতিবার একই টেক্সট দেয়। এটা গুরুত্বপূর্ণ, কারণ নাহলে ফরম্যাটের প্রভাবকে জেনারেশনের এলোমেলো বিস্তার থেকে আলাদা করা যেত না।
সংখ্যাগুলো কী দেখাল
পরীক্ষাটি LongMemEval-এর ৫০০টি প্রশ্ন ও নয়টি মডেলের ওপর নির্ভর করে। এখানে একটু থামা দরকার: এটা একটা রান নয়, বা সুন্দর একটা সংখ্যার জন্য একটা চালানো নয়, বরং «মডেল × উপস্থাপনার ফরম্যাট» গ্রিড, যা দিয়েই প্রভাবটা দেখা সম্ভব হয়।
মূল ফলাফল: matched-budget resolved packets recency-truncated raw dialogue-কে ৪২.৪–৭২.৬ পয়েন্টে ছাড়িয়ে যায়। অন্য কথায়, ফরম্যাটগুলোকে তুলনাযোগ্য বাজেটে এনে মডেলকে যদি সত্যিই উত্তরবাহী কনটেন্ট দেওয়া হয়, তাহলে সবচেয়ে সাদামাটা উপস্থাপনা — সতেজতা অনুযায়ী ছেঁটে ফেলা কাঁচা সংলাপ — এর সঙ্গে ব্যবধানটা প্রসাধনসুলভ নয়, ধসাত্মক।
deployed-style টেমপ্লেটগুলোতে চিত্রটা নরম, তবুও যথেষ্ট বড়: সেরা ও সবচেয়ে খারাপ ফরম্যাটের মধ্যে ব্যবধান নয়টি মডেলের প্রতিটির জন্য ২৪.৬–৪৮.৮ পয়েন্ট। অর্থাৎ একই মডেলের ভেতরে, একই প্রশ্নে, একই বাজেটে, শুধু প্রমাণটা দেখতে কেমন লাগে তার কারণে কয়েক ডজন পয়েন্ট «হারানো» বা «অর্জন» করা সম্ভব।
প্রাথমিক স্কোরিংয়ের আরেকটা খুঁটিনাটি: ৯টি মডেলের ৭টিতে ChatGPT-ধাঁচের এন্ট্রি কাঁচা সংলাপের চেয়ে বেশি পয়েন্ট স্কোর পায়। এটা সম্ভবত সবচেয়ে অস্বস্তিকর উপসংহার তাদের জন্য, যারা «নিখুঁত» কথোপকথনের ইতিহাসের ওপর মেট্রিক দাঁড় করান।
বিচারকও শেষ কথা নন
আলাদা একটা প্রসঙ্গ — যদি স্কোরগুলো স্বয়ংক্রিয় স্কোরারের বদলে বিচারক-মডেল দিয়ে (judge rescoring) পুনর্গণনা করা হয়, তাহলে কী হয়। ফরম্যাটের সমষ্টিগত ইতিবাচক প্রভাব টিকে থাকে, কিন্তু আলাদা আলাদা মডেলের ক্ষেত্রে তাৎপর্য মিশ্র হয়ে যায়। সহজ কথায়: পুরো নমুনার স্তরে প্রবণতাটা মিলিয়ে যায় না, কিন্তু «মডেল X ঠিক Y ফরম্যাটের কারণেই জিতছে» — এই ধরনের সূক্ষ্ম দাবিগুলো পুনর্বিচারের পর আর তেমন নির্ভরযোগ্য থাকে না।
এটা LLM-বিচারক ছেড়ে দেওয়ার কারণ নয়, বরং ভালো একটা স্মারক: মেমোরির যেকোনো মূল্যায়ন নিজেই একটা পরিমাপক যন্ত্র, ইনপুটের ফরম্যাটের প্রতি যার নিজস্ব সংবেদনশীলতা আছে। আর সিস্টেম ও বিচারক যদি প্রমাণের মোড়কের প্রতি ভিন্নভাবে সাড়া দেয়, তাহলে পার্থক্যটা হয় শব্দে মিলিয়ে যেতে পারে, নয়তো উল্টো দিকে মিথ্যা সংকেতে পরিণত হতে পারে।
সবচেয়ে দৃষ্টান্তমূলক ফলাফল: শূন্য বনাম পঞ্চাশ
নিবন্ধ থেকে যদি একটা সংখ্যা নিতে হয়, এটাই নেওয়া উচিত। যে তিনটি মডেল formal ledger packets-এ ০ % দেখিয়েছিল, তারা একই তথ্যগুলোর উত্তর natural-language entries থেকে ৪৫.৪–৫৩.৪ % নির্ভুলতায় দিয়েছিল।
«একটু ভালো» নয়, «ত্রুটির সীমার মধ্যে» নয় — সম্পূর্ণ শূন্য থেকে অভিন্ন কনটেন্টে অর্ধেক ক্ষেত্রে আত্মবিশ্বাসীভাবে আঘাত করা। এমন ব্যবধান মডেলের জ্ঞানের অভাব বা দুর্বল অনুসন্ধান দিয়ে ব্যাখ্যা করা কঠিন: তথ্যগুলো উপস্থিত ছিল, শুধু উপস্থাপনার ধরনটা বদলেছিল। আনুষ্ঠানিক, মেশিন-পাঠযোগ্য রেকর্ড কেন যেন মডেলের কাছে দুর্ভেদ্য হয়ে দাঁড়িয়েছিল, অথচ একই তথ্য সাধারণ ভাষায় লিখলে কোনো সমস্যা ছাড়াই পড়া গিয়েছিল।
ইঞ্জিনিয়ারের জন্য এটা ব্যবহারিক সংকেত: আপনার পাইপলাইন যদি মেমোরি কঠোর কাঠামোবদ্ধ ব্লকে জমা করে, তাহলে আপনি পদ্ধতিগতভাবে মডেলের সামর্থ্যকে অবমূল্যায়ন করতে পারেন — আর একইসঙ্গে আনুষ্ঠানিকীকরণের সুফলকেও অতিরঞ্জিত করতে পারেন।
এটা কতটা টেকসই
শর্ত জটিল হলে প্রভাবটা ভেঙে পড়ে না: retrieval noise-এও, অর্থাৎ কনটেক্সটে বাড়তি টুকরো মিশে গেলেও, এটা টিকে থাকে। তার চেয়েও বেশি, এটা HotpotQA-তেও বহনযোগ্য — বহু-ধাপের প্রশ্নকে ঘিরে গড়া আরেকটা ডেটাসেট। এটা গুরুত্বপূর্ণ, কারণ এতে সন্দেহ দূর হয় যে ব্যাপারটা বুঝি শুধু দীর্ঘ মেমোরির একটা বেঞ্চমার্কের বিশেষত্ব।
সীমাবদ্ধতাগুলোও মাথায় রাখা দরকার: টেমপ্লেটগুলো বাস্তব উপস্থাপনার ধরনগুলোর আনুমানিক রূপ, হুবহু পুনরুৎপাদন নয়, আর পুনর্বিচারের পর নির্দিষ্ট মডেল নিয়ে সিদ্ধান্ত মিশ্র। তাই এটা তৈরি রেসিপির কথা নয়, বরং এই ভেরিয়েবলটাকে অন্তত লক্ষ্য করার প্রয়োজনীয়তার কথা।
বাস্তবে এটা নিয়ে কী করা যায়
লেখকদের উপসংহারটা বেশ সরাসরি: memory/RAG মূল্যায়নের রিপোর্টে হয় কোন reader-facing আর্টিফ্যাক্ট ব্যবহার করা হয়েছে তা জানাতে হবে, নয়তো সেটা স্পষ্টভাবে নিয়ন্ত্রণ করতে হবে। নিচে এর ব্যবহারিক রূপ:
- পরীক্ষার বর্ণনায় ফরম্যাট স্থির করুন। «আমরা মডেলটা LongMemEval-এ চালিয়েছি» — এটা অপর্যাপ্ত বর্ণনা, যদি না বলা হয় ইতিহাসটা কোন রূপে ইনপুটে গিয়েছিল।
- অন্তত দুই-তিনটা ফরম্যাট চালান। একটা ভালো আর একটা সাদামাটা (যেমন কাঁচা ছেঁটে ফেলা সংলাপ) দিয়েই আপনার সিস্টেমের সংবেদনশীলতার একটা ধারণা পাওয়া যাবে।
- ভিন্ন মোড়কে মডেলদের মধ্যে তুলনা করবেন না। ২০–৩০ পয়েন্টের ব্যবধান পুরোপুরি ফরম্যাটের হতে পারে, মডেলের নয়।
- নিজের কাঠামোবদ্ধ মেমোরি স্কিমগুলো যাচাই করুন। একই তথ্যের সাধারণ টেক্সটে আত্মবিশ্বাসী উত্তর থাকলেও আনুষ্ঠানিক রেকর্ডে শূন্য — এটা মেমোরির নয়, উপস্থাপনার বাগ।
- «মডেল-বিচারক» চ্যানেলটা আলাদাভাবে পরীক্ষা করুন। মূল্যায়নকারী নিজেই যদি ফরম্যাটের প্রতি সংবেদনশীল হয়, মেট্রিকটা পক্ষপাতদুষ্ট হয়ে যায়।
- ফরম্যাটের দাম হিসাব করুন। সারাংশ ও টাইপযুক্ত এন্ট্রি টোকেন বাঁচায়; এখন এর একটা মাপযোগ্য বিপরীত দিকও আছে, আর সেটা সচেতনভাবে ওজন করা উচিত।
RENDER-এর মূল কথা সহজ, তাই অস্বস্তিকর: প্রমাণ উপস্থাপনার ধরন উল্লেখ না করে «মডেলের মেমোরির মূল্যায়ন» একটা অসম্পূর্ণ দাবি। একই সংলাপ, একই প্রশ্ন, একই মডেল, কিন্তু ভিন্ন উত্তর। পার্থক্যটা হলো — আপনি তাকে যা মনে করার কথা, তা তাকে কীভাবে দেখালেন।


