ইনস্ট্রুমেন্ট ইতিমধ্যেই ল্যাবরেটরিতে আছে — প্রশ্নটা অন্য জায়গায়
ভাষা মডেল গবেষণার কাজে আর বহিরাগত কিছু নয়। সাহিত্য সংশ্লেষণ, অনুমানের খসড়া, ডেটা প্রসেসিংয়ের কোড, আনুষ্ঠানিক হিসাবের যাচাই — এসবই এখন দৈনন্দিন কাজের অংশ। কিন্তু সুবিধার সঙ্গে সঙ্গে এমন এক প্রশ্ন আসে, যা সেটিংস বা নিয়মকানুন দিয়ে সমাধান হয় না: যদি যুক্তির কোনো অংশ মেশিন সম্পন্ন করে, তবে কোন শর্তে ফলাফলটিকে এখনও জ্ঞান বলা যায়, নিছক বিশ্বাসযোগ্য টেক্সট নয়?
ঠিক এভাবেই Kalin Stoyanov তাঁর «Ethical LLM-Assisted Research» (arXiv:2608.23644, ২৪ আগস্ট ২০২৬) কাজে সমস্যাটি তুলে ধরেছেন। এটি "সাবধানে AI ব্যবহার করুন" বলে আরেকটি আহ্বান নয়, বরং একটি নিয়ামক ও ধারণাগত ফ্রেমওয়ার্ক গড়ার চেষ্টা — অর্থাৎ এমন একটি ভাষা, যেখানে জ্ঞানীয় কাজ অর্পণ নিয়ে কঠোরভাবে আলোচনা করা যায়।
মূল পূর্বধারণা: বৈজ্ঞানিক যুক্তি একটি বিতরণকৃত প্রক্রিয়া। এতে অবদান বিভিন্ন উৎস থেকে আসতে পারে, মানুষের ও মেশিনের, যেকোনো অনুপাতে। কিন্তু শেষ পর্যন্ত বৈজ্ঞানিক ইতিহাসে যা ঢোকে, তার দায়িত্ব থেকে যায় মানুষের। তাহলে "একটি নিবন্ধে কতটা AI গ্রহণযোগ্য" — প্রশ্নটি ভুলভাবে গঠিত। সঠিক প্রশ্নটি ভিন্ন: ফলাফল বৈধ রাখতে হলে মানুষকে ঠিক কী করতে হবে।
একটি অস্পষ্ট "AI-এর অংশগ্রহণ"-এর বদলে পাঁচটি চলক
সাধারণত বিতর্কটা গিয়ে ঠেকে এক শতাংশে: কতটা লিখেছে মানুষ, কতটা মডেল। ফ্রেমওয়ার্কটি এটিকে পাঁচটি আলাদা কনস্ট্রাক্টে ভাঙার প্রস্তাব দেয়। এদের প্রত্যেকটি অন্যগুলো থেকে স্বাধীনভাবে বদলাতে পারে।
- বিষয়বস্তুর উৎস (O(g)) — নির্দিষ্ট দাবিটি কে বা কী তৈরি করেছে।
- মানব যাচাইয়ের সম্পূর্ণতা (V(g)) — একজন জীবিত গবেষক কি যাচাই শেষ পর্যন্ত নিয়ে গেছেন।
- দায়িত্বের আরোপ (R(g)) — দাবিটি গ্রহণ করার সিদ্ধান্তের ভার কার নামে লেখা।
- জবাবদিহিমূলক মানব মালিকানা (M(g)) — দাবিটির মালিক কে, অর্থাৎ কে এটি রক্ষা করতে ও তার দায় নিতে প্রস্তুত।
- জ্ঞানতাত্ত্বিক ফলাফল (E(g)) — যাচাই জ্ঞানের বৃদ্ধির দৃষ্টিতে কী দেয়।
এই বিভাজনটি প্রায় খুঁটিনাটি-সর্বস্ব মনে হতে পারে, কিন্তু এটি সেই ফাঁকটি বন্ধ করে, যা সবাই ব্যবহার করে। উৎস, যাচাই, ফলাফল ও দায়িত্ব — এগুলো আলাদা জিনিস, এবং একটিকে অন্যটি থেকে অনুমান করা যায় না। টেক্সট মেশিনে তৈরি হতে পারে, তবু তার দায় নেবে মানুষ — এবং এটা স্বাভাবিক। উল্টোটাও ঘটে: আনুষ্ঠানিকভাবে সব লেখা লেখকের, কিন্তু যাচাই ছিল ভুয়া, ফলে জ্ঞান শেষ পর্যন্ত বাড়ে না।
"আমি সব যাচাই করেছি" বলে পার পাওয়া যায় না কেন
"আমি পড়েছি এবং সম্মত" — এই বাক্যটি যাচাই নয়। এটি ধরে না, ঠিক কী যাচাই করা হয়েছে, কোন ভিত্তিতে, এবং নিশ্চিত ও বিশ্বাসে-গ্রহণ করা জিনিসের মধ্যে সীমারেখা কোথায়। V(g) কনস্ট্রাক্টটি ঠিক যাচাইয়ের সম্পূর্ণতা দাবি করে, তার ঘোষণা নয়। এটি গুরুত্বপূর্ণ, কারণ LLM-সহায়ক যুক্তি বাইরে থেকে সাধারণ যুক্তির প্রায় অবিচ্ছেদ্য: টেক্সট মসৃণ, যুক্তিগুলো সংগত, রেফারেন্সগুলো আসল মনে হয়।
সীমারেখা যাচাইয়ের ওপর দিয়ে যায়, মেশিনের অবদানের পরিমাণের ওপর নয়
কাজটির কেন্দ্রীয় বক্তব্য এই: নৈতিক সীমারেখা নির্ধারিত হয় পর্যাপ্ত যাচাই ও জবাবদিহিমূলক মানব মালিকানা দিয়ে, মেশিনের সম্পৃক্ততার মাত্রা দিয়ে নয়। অর্থাৎ অর্পণের ঘটনাটি নিজেই নৈতিকভাবে নিরপেক্ষ। এটি সমস্যা হয়ে ওঠে কেবল তখনই, যখন যাচাই আনুষ্ঠানিক আর দায়িত্ব অস্পষ্ট।
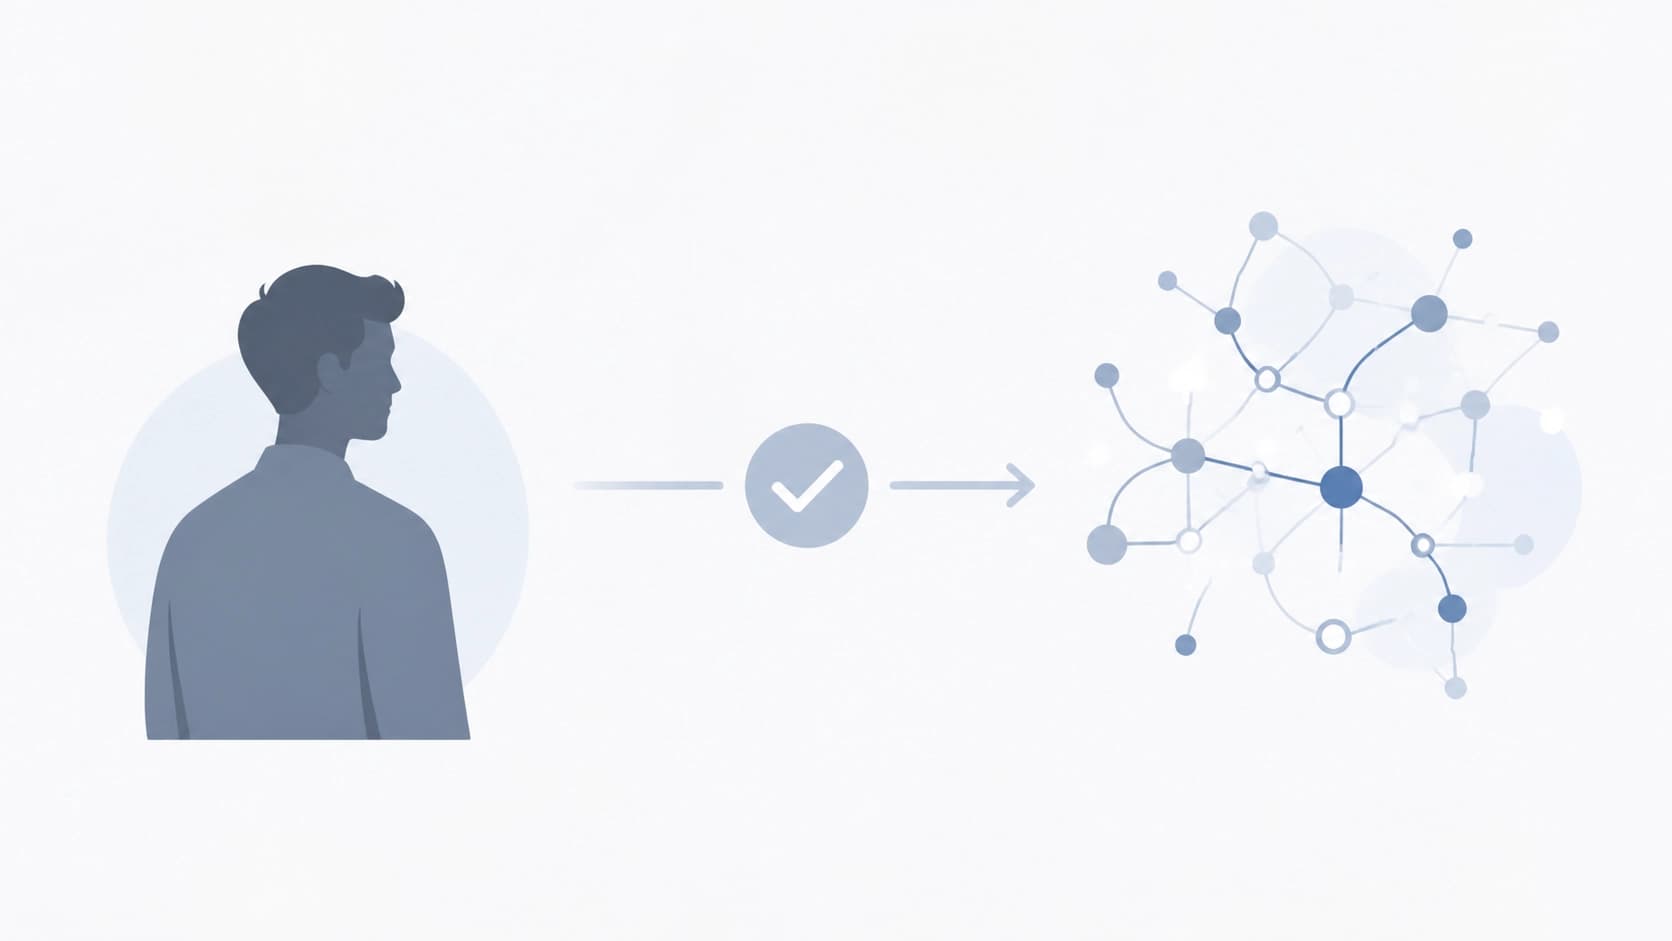
এটি চেনা যুক্তিকে উল্টে দেয়। মডেল "কত শতাংশ" লিখেছে তা নিয়ে তর্ক করা অর্থহীন: একটি লাইন, যা তৈরি হয়ে অন্ধভাবে সিদ্ধান্তে বসানো হয়েছে, সেটিও ফলাফল নষ্ট করতে পারে; আবার সৎ যাচাইয়ের সঙ্গে ব্যাপক মেশিন-সহায়তা কিছুই ভাঙে না। বিপদ অর্পণের পরিমাণে নয়, তার অস্বচ্ছতায়।
জ্ঞানতাত্ত্বিক অডিট: যে জার্নাল যুক্তিকে যাচাইযোগ্য করে
এই যুক্তি থেকেই জন্ম নেয় একটি ব্যবহারিক হাতিয়ার — জ্ঞানতাত্ত্বিক অডিট। এটি হলো একটি কাঠামোবদ্ধ লিপি: কী অর্পণ করা হয়েছিল, কীভাবে যাচাই করা হয়েছে, বিষয়বস্তু কোথা থেকে এসেছে এবং কার ওপর দায়িত্ব দেওয়া হয়েছে। মূলত এটি ধারণার উৎসের জার্নাল, ব্যবহৃত হাতিয়ারের তালিকা নয়।
এমন লিপির মূল্য এই যে, এটি যুক্তিকে বাইরের যাচাইয়ের জন্য উন্মুক্ত করে। পাঠক, পর্যালোচক বা সহ-লেখক দেখতে পারেন, মেশিনের অনুমান কোথায় শেষ আর নিশ্চিত তথ্য কোথায় শুরু। এটি নিয়ন্ত্রক সংস্থার জন্য রিপোর্ট নয়, বরং একটি কাজের আর্টিফ্যাক্ট: এটি লেখককেও ধরতে সাহায্য করে যে, কোথাও তিনি কোনো দাবি যাচাই ছাড়াই গ্রহণ করেছেন, কেবল因为它 বিশ্বাসযোগ্য শোনাচ্ছিল।
দৈনন্দিন কাজে এটি কেমন দেখায়
ফ্রেমওয়ার্কটিকে কয়েকটি কাজে নামিয়ে আনা যায়, যেগুলোর জন্য ল্যাবে নতুন পদ বা বিশেষ সফটওয়্যার লাগে না।
- অর্পণের জার্নাল রাখুন: মডেলকে ঠিক কী দিয়েছেন — সাহিত্য অনুসন্ধান, যুক্তির খসড়া, কোড, আনুষ্ঠানিক যাচাই।
- উৎস চিহ্নিত করুন: কোন অংশটি মেশিন থেকে এসেছে, আর কোনটি আপনার।
- যাচাইকে সম্মতি থেকে আলাদা করুন: ঠিক কী যাচাই করেছেন এবং কোন পদ্ধতিতে, তা লিখে রাখুন।
- দায়িত্বপ্রাপ্ত ব্যক্তির নাম নিন, "লেখকদলের" নয়। এটা ChatGPT ছিল কি না বা অন্য কোনো সহায়ক — তাতে কিছু আসে যায় না, দাবিটির দায় মানুষই নেয়।
- সবচেয়ে বিশ্বাসযোগ্য জিনিসটি আগে যাচাই করুন: মসৃণভাবে লেখা অনুচ্ছেদ নির্ভুলতার লক্ষণ নয়, বরং কখনও উল্টোটাও।
সবচেয়ে বেশি কোথায় ছিঁড়ে যায়
তিনটি সাধারণ ব্যর্থতার জায়গা। প্রথমটি — রেফারেন্স ও উদ্ধৃতি: এগুলো বিশ্বাসযোগ্য দেখায়, কিন্তু হাতে যাচাই দরকার। দ্বিতীয়টি — সংখ্যাগত ও পরিসংখ্যানগত দাবি, যা সহজেই সত্য বলে ধরে নেওয়া হয়। তৃতীয়টি — "স্বতঃসিদ্ধ" সাধারণীকরণ, যা কেউ যাচাই করে না, কারণ সেগুলো তুচ্ছ মনে হয়।
প্রয়োগের সীমা ও বিতর্কিত জায়গা
ফ্রেমওয়ার্কটি আনুষ্ঠানিক, তাই এটি জীবন্ত প্র্যাকটিস নয়, গৃহীত সংজ্ঞার পরিণতি নিয়ে কাজ করে। "যাচাইয়ের সম্পূর্ণতা" কীভাবে মাপা যায় — প্রশ্নটি খোলা থেকে যায়; এটি একটি কনস্ট্রাক্ট, সংখ্যা নয়। পর্যালোচনায় অডিট কীভাবে যুক্ত করা যায়, তাও পুরোপুরি স্পষ্ট নয়: জার্নালগুলো এখনও অর্পণের জার্নাল চায় না, এবং চাইবে কি না তাও নিশ্চিত নয়।
ধারণাটি আচার-অনুষ্ঠানে পরিণত হওয়ার ঝুঁকিও আছে। যেকোনো রিপোর্টিং আমলাতন্ত্র হয়ে ওঠার প্রবণতা রাখে: অডিট যদি টিক দেওয়ার জন্য করা হয়, তবে তা অর্থ হারায়, ঠিক যেমন ভুয়া যাচাই অর্থ হারাত। হাতিয়ারটির উপযোগিতা নির্ভর করে যে এটি পরিচালনা করে তার সততার ওপর।
শেষ পর্যন্ত মানুষের জন্য কী থাকে
মেশিনকে অনেক কিছু দেওয়া যায়: খসড়া কাজ, বিকল্পের ছাঁটাই, অনুসন্ধানের রুটিন, টেক্সটের প্রাথমিক সংযোজন। যা অর্পণ করা যায় না তা হলো — কোনটি প্রতিষ্ঠিত বলে গণ্য হবে সেই সিদ্ধান্ত, এবং তার দায় নেওয়ার প্রস্তুতি। Stoyanov-এর ফ্রেমওয়ার্ক এজন্য একটি আনুষ্ঠানিক শব্দভান্ডার দেয়: এটি দায়িত্বশীল জ্ঞানীয় অর্পণকে নিছক দায়িত্ব হস্তান্তর বা তার নীরব উপেক্ষা থেকে আলাদা করতে দেয়।
আসলে এটি বৈজ্ঞানিক কাজের পুরোনো নিয়মেই ফিরে যাওয়া, কেবল হাতে নতুন হাতিয়ার নিয়ে। জ্ঞান সবসময়ই যাচাইয়ের ফল, ঘোষণার নয়। LLM-এর আবির্ভাব এতে কিছু বদলায়নি — এটি কেবল যাচাই আর তার নকলের পার্থক্যকে আরও দৃশ্যমান করেছে।