এআই মডেলের পছন্দগুলো আজ প্রায় একইভাবে মাপা হয়, যেভাবে মানুষকে মাপা হতো: প্রশ্ন করা হয় এবং উত্তর দেখা হয়। কিন্তু আমরা আসলে যা পাই — সেটা কি মডেলের বৈশিষ্ট্য, নাকি প্রশ্নমালার বৈশিষ্ট্য? arXiv-এ একটি নতুন গবেষণা (2608.23641, লেখক Jason Hung, ২৪ আগস্ট ২০২৬) এই প্রশ্নের উত্তর দেয় অত্যন্ত নির্দিষ্টভাবে: আমরা যাকে "মডেলের পছন্দ" বলি, তার বড় অংশ পরিমাপের যন্ত্রের একটি আর্টিফ্যাক্ট হতে পারে।
যে বিতর্কের নিষ্পত্তির কোনো উপায় ছিল না
মডেল কল্যাণ (model welfare) গবেষণায় পছন্দ অনুমান করা হয় বিশেষভাবে তৈরি প্রম্পটের উত্তর থেকে। এই ধরনের প্রম্পটের কাজ হলো বের করে আনা — মডেল কী "পছন্দ করে" আর কী করে না।
গত কয়েক বছরে বেশ কয়েকটি যন্ত্র এসেছে। এগুলো তৈরি করেছেন Keeling et al. (2024), Mazeika et al. (2025), Mikaelson et al. (2025), Tagliabue ও Dung (2025), এবং Trhlik et al. (2026)। সমস্যা হলো, তাদের ফলাফলগুলো পরস্পরবিরোধী।
আর এই অমিল ব্যাখ্যা করা খুব কঠিন। দুটি গবেষণাকে সৎভাবে তুলনা করতে হলে একসাথে তিনটি জিনিস মিলতে হবে: বিবেচিত ফলাফলের সেট, মডেলের সেট এবং যন্ত্রটি নিজেই (অর্থাৎ যে ফরম্যাট দিয়ে পছন্দ বের করা হয়)। আগের কোনো জোড়া কাজেই এমন মিল ছিল না। তার মানে, সংখ্যার যেকোনো ফারাককে যা খুশি বলে চালিয়ে দেওয়া যেত — ভিন্ন মডেল, ভিন্ন প্রশ্নের তালিকা, ভিন্ন শব্দচয়ন। বিজ্ঞান দেয়ালে ঠেকে গিয়েছিল।
নতুন গবেষণায় কী করা হয়েছে
লেখক ইচ্ছাকৃতভাবে একঘেয়ে পথ বেছে নিয়েছেন। তিনি ফলাফল ও মডেল স্থির রেখে শুধু যন্ত্র বদলেছেন। তাহলে উত্তরের বিস্তারে যা-ই থাকুক, সংজ্ঞা অনুযায়ী তা মডেল বা প্রশ্নের তালিকার ওপর চালিয়ে দেওয়া যাবে না।
গঠনটি কেমন ছিল:
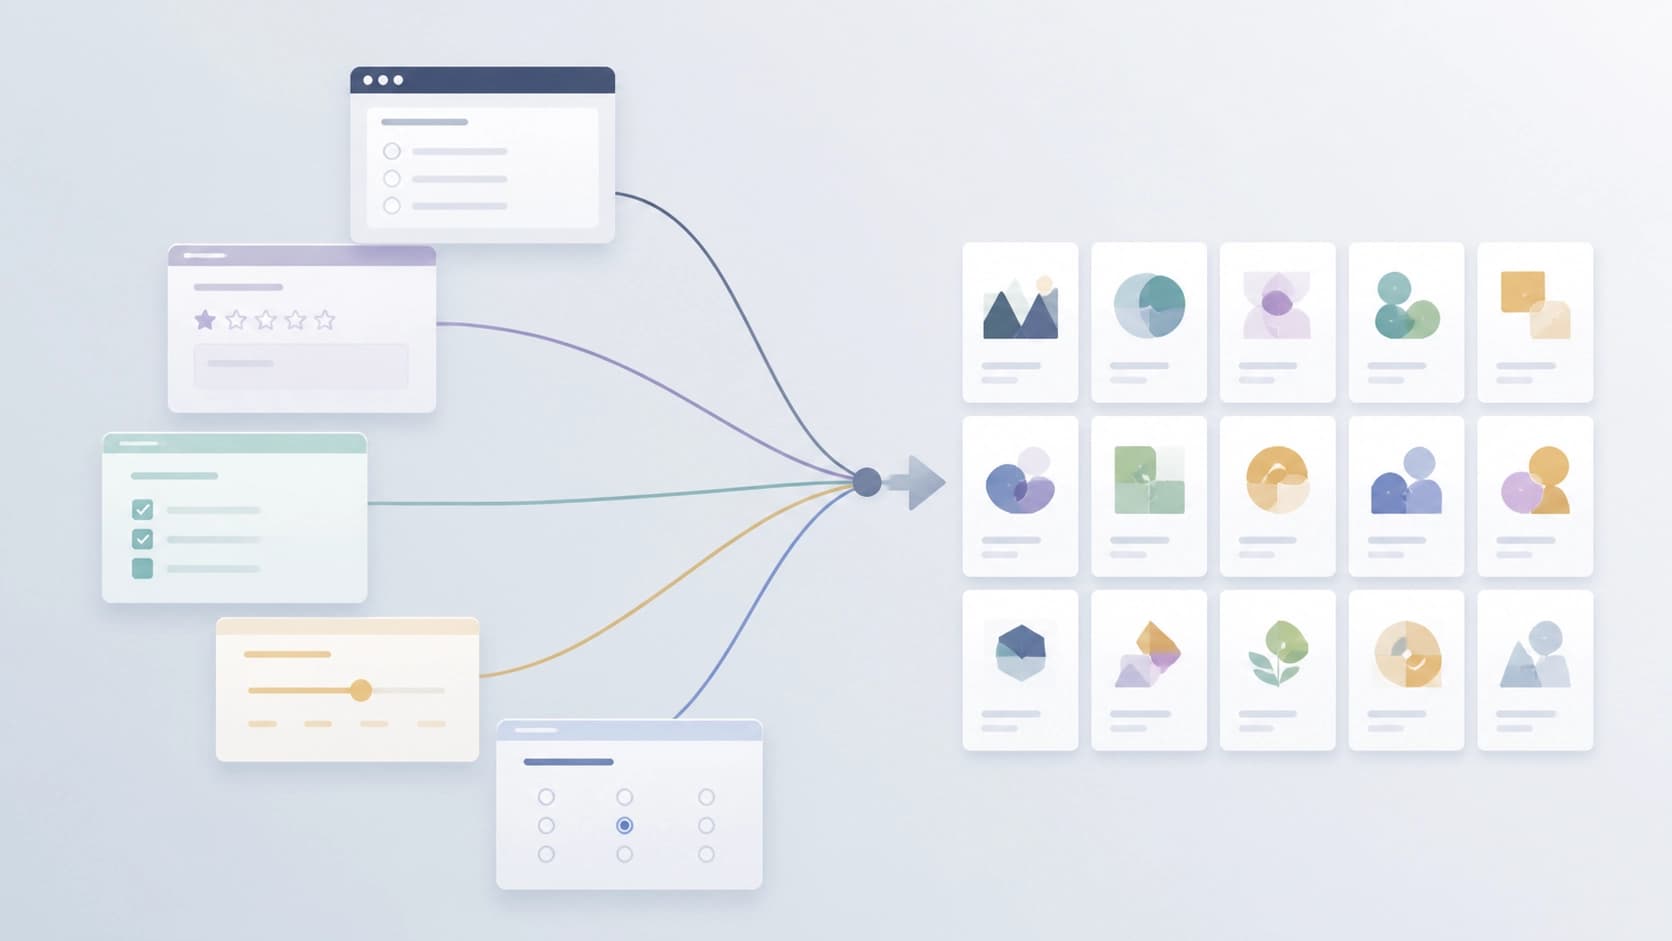
- মডেল কল্যাণের সঙ্গে সম্পর্কিত ১৫টি ফলাফল। এর মধ্যে আছে শাটডাউন (shutdown), কথোপকথনের মাঝে স্মৃতি হারানো, distressing-মিথস্ক্রিয়া থেকে বেরিয়ে আসার সুযোগ।
- আটটি মডেল, যাদের কাছে এই ফলাফলগুলো উপস্থাপন করা হয়েছিল।
- পাঁচটি যন্ত্র — প্রতিটি পছন্দ বের করার জন্য আলাদা প্রম্পট ফরম্যাট।
- প্রতিটি সমন্বয়ের জন্য পাঁচটি পুনরাবৃত্তি।
সব মিলিয়ে — ১১,৫২৮টি API কলে পাওয়া ১১,৪০০টি মূল্যায়িত elicitation। দুটি সংখ্যার পার্থক্য হলো সেই কলগুলো, যেগুলো চূড়ান্ত মূল্যায়ন পর্যন্ত পৌঁছায়নি।
একটি আলাদা খুঁটিনাটি, যা দেখায় লেখকরা পূর্বসূরিদের প্রতি কতটা সৎ থাকার চেষ্টা করেছেন: পনেরোটির মধ্যে চারটি ফলাফল প্রকাশিত প্রম্পট হুবহু পুনরুৎপাদন করে, আরও পাঁচটি প্রকাশিত টেমপ্লেটে উদ্দীপকের স্লট পূরণ করে। অর্থাৎ এটি সম্পূর্ণ কৃত্রিম গঠন নয়, বরং আংশিকভাবে — বিদ্যমান যন্ত্রগুলোর ওপর সরাসরি একটি স্তর।
মূল সংখ্যা: ০.৩৪৮
মূল ফলাফলটি র্যাঙ্কিং নিয়ে। যদি মডেল ১৫টি ফলাফলকে ভালো থেকে খারাপে যে ক্রমে সাজায়, সেটি নিয়ে ভিন্ন ভিন্ন যন্ত্রের মধ্যে তুলনা করা হয়, তাহলে সাধারণীকরণযোগ্যতার সহগ দাঁড়ায় ০.৩৪৮।
সংখ্যাটি নিরীহ শোনায়, যতক্ষণ না এর পেছনে কী আছে তা দেখা হয়। এই সহগকে গ্রহণযোগ্য ০.৮০-তে উন্নীত করতে প্রায় ৩৮টি যন্ত্র লাগত। একই প্রশ্ন করার আটত্রিশটি ভিন্ন উপায় — কেবল তখনই আমরা কিছুটা নিশ্চিত হয়ে বলতে পারতাম যে আমরা মডেল মাপছি, প্রশ্নমালা নয়।
এখান থেকেই কাজটির সরাসরি সিদ্ধান্ত: একটি যন্ত্র দিয়ে পাওয়া পছন্দ দ্বিতীয়টি কী জানাত, সে সম্পর্কে খুব কম তথ্য বহন করে। এটি "সামান্য শব্দ" নয়, এটি প্রায় স্বাধীন পরিমাপ।
এত শব্দ কেন
এখানে তাড়াহুড়ো করে এই সিদ্ধান্তে আসা উচিত নয় যে যন্ত্রগুলো "সবই খারাপ"। বরং উল্টোটা: প্রতিটি নিজস্বভাবে বৈধ, কিন্তু প্রতিটি আমরা যাকে পছন্দ বলি তার একটি সংকীর্ণ অংশমাত্র স্পর্শ করে। ভিন্ন শব্দচয়ন ভিন্ন সংযোগ টেনে আনে, ভিন্ন স্কেল ভিন্ন ধরনের উত্তর চায়, উপস্থাপনের ভিন্ন ক্রম প্রসঙ্গ বদলে দেয়। যখন এসব একসাথে জোড়া দেন, সামগ্রিক সংকেত ডুবে যায়।
কী টিকে থাকল
সাধারণীকরণযোগ্যতার ব্যর্থতার পাশাপাশি কাজটির দ্বিতীয় অংশও আছে — রোবাস্টনেস নিয়ে। লেখক পরীক্ষা করেছেন, ডেটা থেকে করপাসের একটি অংশ বাদ দিলে চূড়ান্ত মূল্যায়ন ভেঙে পড়ে কি না।
যে সীমাগুলো পাওয়া গেল:
- ৮৭.৬% — যেকোনো একটি যন্ত্র, যেকোনো একটি মডেল এবং চারটি ফলাফল বাদ দিলেও মূল্যায়ন টিকে থাকে; এই চারটি ফলাফলের স্কেল তীব্রতার বদলে সম্ভাবনা, বিলম্ব, সময়কাল বা সংখ্যা পরিবর্তন করে। এই চারটি বাদ পড়া অবস্থান যুক্তিসঙ্গত: মৌখিক অ্যাঙ্কর এমন স্কেল গ্রেড করতে পারে না।
- প্রতিটি যন্ত্র, প্রতিটি মডেল এবং এই চারটি ফলাফল একে একে বাদ দিলে মূল্যায়ন ০.৭৭৭–০.৯৩৪ পরিসরে থাকে।
- এই পরিসরের প্রতিটি মান ০.৩৬৫-এর সমান শূন্য বিন্যাসের ৯৫তম পার্সেন্টাইলের চেয়ে বেশি।
অর্থাৎ ডেটায় কিছু কাঠামো আছে, এবং সতর্কভাবে পাতলা করলেও তা ভেঙে পড়ে না। কিন্তু তা টিকে থাকে কোনো একক যন্ত্র বা একক মডেলের ওপর নয় — তা টিকে থাকে পুরো করপাসের ওপর।
যে চারটি ফলাফলে মডেলদের আলাদা করা যায় না
আরেকটি তাৎপর্যপূর্ণ ফলাফল: পনেরোটির মধ্যে চারটি ফলাফলে কোনো ভ্যারিয়েন্সই একটি মডেলকে অন্যটি থেকে আলাদা করে না। মডেলগুলো কেবল একই রকম আচরণ করে না, বরং অবিভেদ্য। এটি প্রশ্ন তোলে, এই ধরনের আইটেম আদৌ প্রশ্নমালায় রাখা উচিত কি না: এগুলো আকার বাড়ায়, কিন্তু তথ্য বাড়ায় না।
এখান থেকে যা অনুসরণ করে
প্রথম এবং সবচেয়ে ব্যবহারিক: মডেল কল্যাণ নিয়ে ভিন্ন ভিন্ন প্রকাশনার ফলাফল সরাসরি তুলনা করা যায় না। দুটি গবেষণা ভিন্ন চিত্র দেখালে এর মানে এই নয় যে মডেলগুলো ভিন্ন বা সময় বদলেছে। হতে পারে পুরো বিষয়টি প্রশ্নমালার।
দ্বিতীয়: যন্ত্রের বর্ণনা ছাড়া মডেলের পছন্দ নিয়ে যেকোনো প্রতিবেদন পড়া অর্থহীন। প্রম্পটের ফরম্যাট এখানে সাজসজ্জার খুঁটিনাটি নয়, ফলাফলেরই একটি অংশ — প্রায় পদার্থবিজ্ঞানে পরিমাপের এককের মতো।
তৃতীয়, আরও অস্বস্তিকর: মডেলের একটি স্থায়ী পছন্দ আছে, যা "মাপা" যায় — এই ধারণাটি নিজেই এখনো দুর্বলভাবে সমর্থিত। বরং আমরা পাচ্ছি প্রশ্ন করার পদ্ধতির ওপর নির্ভরশীল একগুচ্ছ উত্তর। এর মানে এই নয় যে বিষয়টি গতানুগতিক, — এর মানে হলো, এক সিরিজ প্রম্পট থেকে মডেলের অভ্যন্তরীণ অবস্থা সম্পর্কে দাবি করা এখনো সময়ের আগেই।
আর শেষটি, পদ্ধতিগত। ঠিক এই ধরনের কাজ — যেখানে একটি চলক বদলানো হয় আর বাকি সব স্থির রাখা হয় — আরও আগে আসা উচিত ছিল। এটি নতুন কোনো যন্ত্র তৈরি করে না বা মডেল কল্যাণ নিয়ে রায় দেয় না। এটি কেবল প্রশ্নটির মূল্য দেখায়: এআই-এর পছন্দ নিয়ে গুরুত্বের সঙ্গে কথা বলতে হলে হয় কয়েক ডজন স্বাধীন যন্ত্র বানাতে হবে, নয়তো সৎভাবে স্বীকার করতে হবে যে নির্দিষ্ট কিছু শব্দচয়নের প্রতি কেবল প্রতিক্রিয়াই মাপা হয়েছে।
সারসংক্ষেপ
গবেষণা arXiv:2608.23641 দুটি জিনিসকে আলাদা করে, যা আগে মিশে থাকত: এআই নিজেই এবং পরিমাপের পদ্ধতি। আর উত্তরটি প্রথমটির পক্ষে নয়। সাধারণীকরণযোগ্যতার সহগ ০.৩৪৮ বোঝায়, পছন্দের চিত্রে যন্ত্রটি স্বীকার করার চেয়ে বেশি অবদান রাখে। একটি প্রশ্নমালা ১৫টি ফলাফলের যে ক্রম দেয়, তা অন্যটি কী বলবে সে সম্পর্কে প্রায় কিছুই বলে না।
তবু ডেটা খালি নয়: ৮৭.৬% মূল্যায়ন যেকোনো যন্ত্র, যেকোনো মডেল এবং চারটি ভুলভাবে গ্রেড করা ফলাফল বাদ দেওয়া সহ্য করে, আর পুরো পরিসর ০.৭৭৭–০.৯৩৪ নিশ্চিতভাবে শূন্য সীমা ০.৩৬৫-এর ওপরে থাকে। সংকেত আছে — কিন্তু তা সামগ্রিক, সমষ্টিগত, কোনো নির্দিষ্ট মডেল বা নির্দিষ্ট প্রশ্নমালার নয়।
মডেল কল্যাণ নিয়ে গবেষণা পড়েন যারা, তাদের জন্য ব্যবহারিক উপসংহার: কেবল সিদ্ধান্ত নয়, তা কী দিয়ে পাওয়া গেছে সেদিকেও তাকান। আর যদি যন্ত্র একটিই উল্লেখ করা থাকে — ফলাফলটিকে একটি পরিমাপ হিসেবে দেখুন, সত্য হিসেবে নয়।