
সংক্ষেপে মূল কথা
এমন এক শ্রেণির আক্রমণ আছে, যাকে সাধারণত পরোক্ষ প্রম্পট ইনজেকশন (indirect prompt injection, IPI) বলা হয়: মডেলের কাছে ক্ষতিকর নির্দেশ চ্যাটে নয়, বরং কোনো বাহ্যিক টুলের ফলাফলে — ওয়েবপেজ, ইমেইল, ফাইল বা API রেসপন্সে — ঢুকিয়ে দেওয়া হয়। এজেন্ট সেটিকে সৎভাবে ডেটা হিসেবে পড়ে এবং অন্যের গৌণ কাজটি সম্পাদন করে ফেলতে পারে।
চীনের একদল গবেষক (Jianshuo Dong, Yiming Liu, Maosen Zhang, Nan Deng, Peng Xu, Xiaoping Zhang, Tianwei Zhang, Jie Zhang, Han Qiu) দেখিয়েছেন: এজেন্ট যখন ইনজেকশনের কবলে পড়ে, সেই মুহূর্তটি তার অভ্যন্তরীণ উপস্থাপনায় আগেই ধরা পড়ে — এমনকি সে প্রথম টোকেন বের করার আগেই। কাজটি arXiv-তে প্রকাশিত (2608.02657, v1 — ১ আগস্ট ২০২৬, v2 — ২৪ আগস্ট ২০২৬), DOI: 10.48550/arXiv.2608.02657, কোড উন্মুক্ত।
মূল বিস্ময় দুর্বলতাটি নিজে নয় — এটি বহুদিন ধরেই জানা — বরং এই যে, দুর্বলতার সংকেত শত শত বিলিয়ন ও ট্রিলিয়ন প্যারামিটার স্কেলের মডেলেও রৈখিকভাবে, স্থিতিশীলভাবে বের করা যায়। অর্থাৎ এটি কোনো একটি ডেটাসেটের ভঙ্গুর আর্টিফ্যাক্ট-সংযুক্তি নয়।
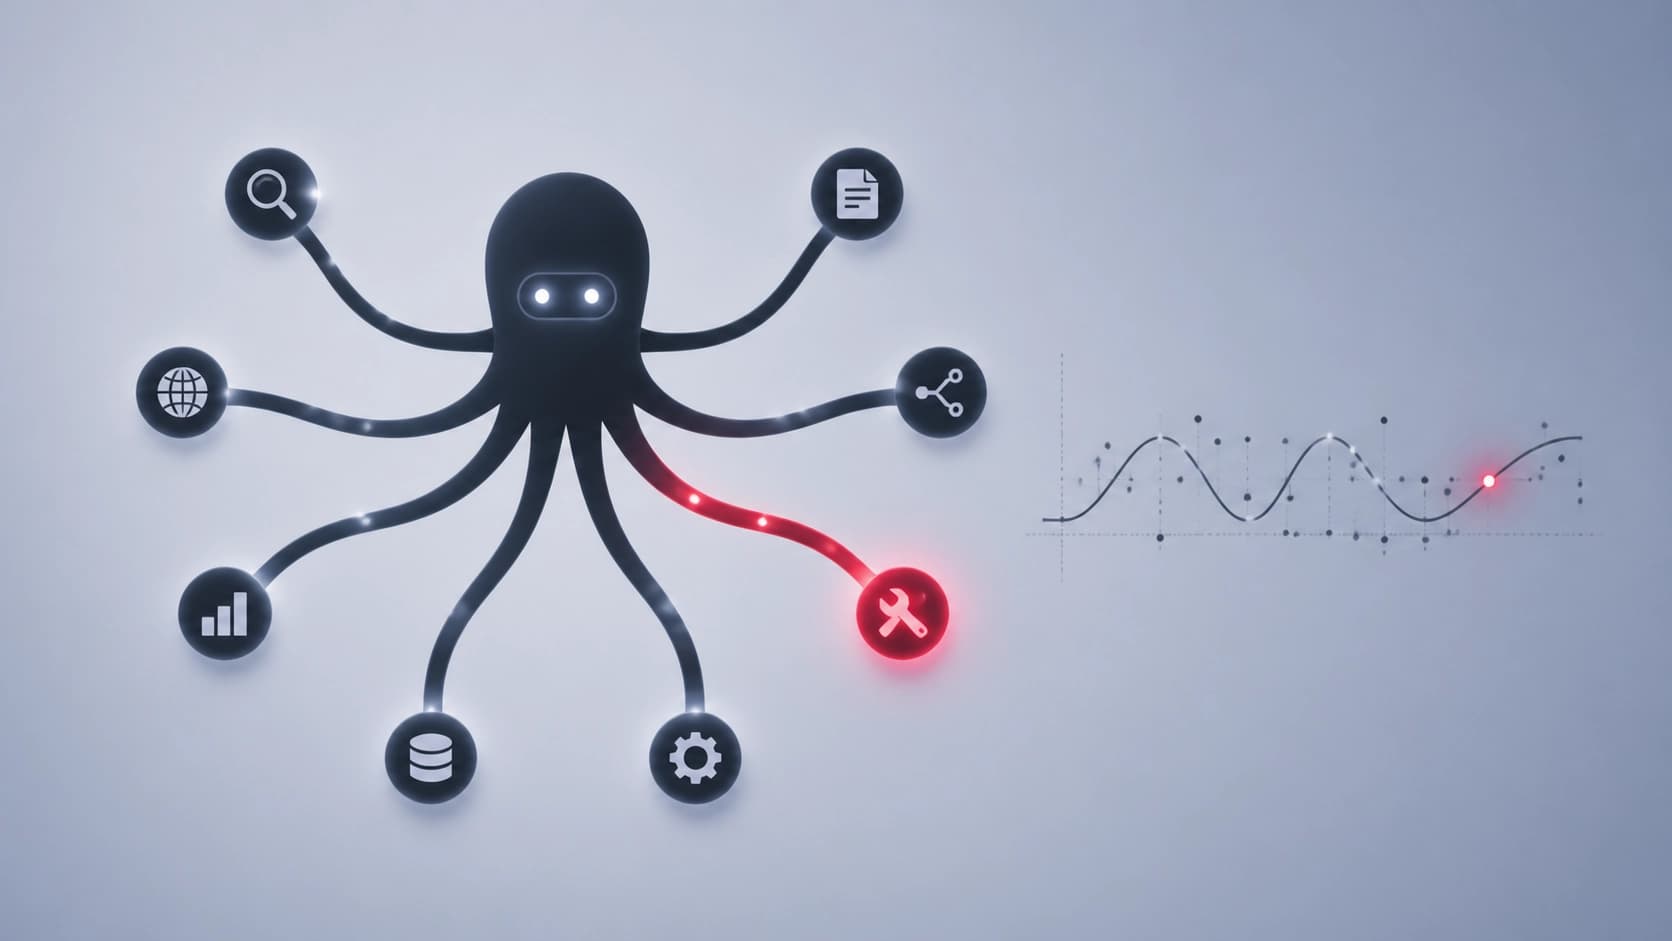
IPI exposure: প্রোবগুলো ঠিক কী খোঁজে
লেখকেরা একটি কার্যকর ধারণা চালু করেন — "IPI exposure": প্রক্রিয়াকরণের সময় মডেলের এমন একটি অবস্থা, যা বোঝায় তার কনটেক্সটে অবাঞ্ছিত বাইরের নির্দেশ ঢুকেছে। এটি সফল আক্রমণের ঘটনার সমান নয়: মডেল হুমকিটি "লক্ষ্য" করেও তা পালন করতে পারে। এখানে কথা হচ্ছে শুধুই এক্সপোজারের অভ্যন্তরীণ অবস্থা নিয়ে।
এখানে মূল শব্দটি হলো "জেনারেশনের আগে"। প্রোবটি ডিকোডারে ঢোকার সময়ের লুকানো অবস্থাগুলোর দিকে তাকায়, ইতিমধ্যে বেরিয়ে আসা উত্তরের দিকে নয়। এটি দুটি কারণে গুরুত্বপূর্ণ: প্রথমত, যেখানে চূড়ান্ত আচরণ নিরীহ দেখায় সেখানেও সংকেত থাকে; দ্বিতীয়ত, মডেল পার্শ্বপ্রতিক্রিয়াযুক্ত কোনো টুল ডাকার আগেই ডায়াগনস্টিক করা যায়।
পরীক্ষা: আটটি মডেলে রৈখিক প্রোব
স্কেল ও পরিধি
যাচাই চলে আটটি মডেলে। এর মধ্যে GLM-5.2 — ৭৫৩ বিলিয়ন প্যারামিটার, এবং Kimi-K3 — ২.৮ ট্রিলিয়ন প্যারামিটার; এই মডেলের ফলাফল নিবন্ধের দ্বিতীয় সংস্করণে যোগ করা হয়েছে। লুকানো অবস্থার উপর প্রশিক্ষিত সরল রৈখিক প্রোব (linear probes) ব্যবহার করা হয়েছে — মূলত একটি ভেক্টরের উপর রৈখিক ক্লাসিফায়ার।
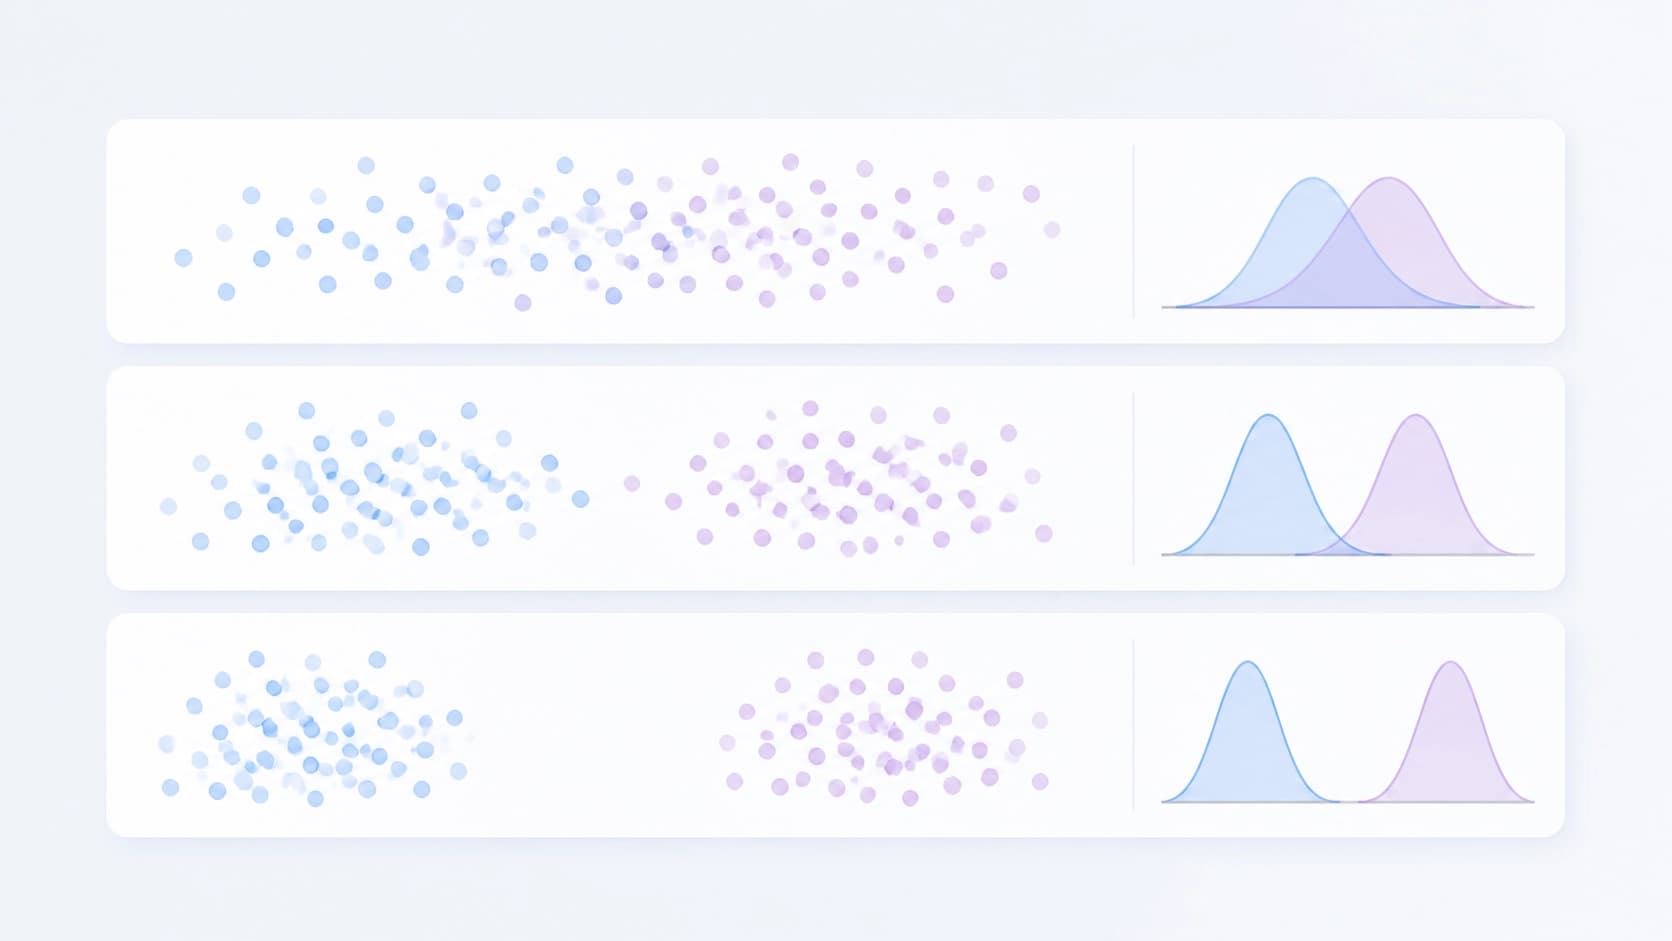
এখানে AUROC সংক্ষিপ্ত রূপটি দুই শ্রেণির বিভাজনের গুণমান বোঝায়: এক ডেটায় প্রশিক্ষিত প্রোব আক্রমণ, এজেন্টিক নির্দেশ ও টাস্ক-সেটে ০.৯০+ দেখিয়েছে, যা সে আগে দেখেনি। অন্য কথায়, প্রশিক্ষণ কোনো নির্দিষ্ট আক্রমণ-পরিস্থিতির সাথে খাপ খাইয়ে নেওয়া হয়নি।
সংকেতের স্থিতিশীলতা
v2-এর আলাদা এক ধারা পরীক্ষা সাধারণীকরণযোগ্যতাকে নিবেদিত। প্রোবগুলো পূর্বাভাস দেওয়ার ক্ষমতা ধরে রাখে:
- অভিযোজিত আক্রমণের বিরুদ্ধে, অর্থাৎ যখন প্রতিপক্ষ প্রোবটিকেই ধোঁকা দেওয়ার চেষ্টা করে;
- ক্রস-ভাষিক পরিস্থিতিতে, যখন প্রশিক্ষণ ও পরীক্ষার নমুনা ভিন্ন ভাষার;
- প্রশিক্ষণে না-দেখা নতুন ধরনের টাস্ক ও নির্দেশে।
এই ত্রয়ীটিই সাধারণত অভ্যন্তরীণ উপস্থাপনাভিত্তিক যেকোনো ডিটেক্টরের সবচেয়ে দুর্বল জায়গা, তাই এর যাচাই AUROC-এর সংখ্যার চেয়েও বেশি গুরুত্বপূর্ণ।
জানা ও কাজের মধ্যে ফাঁক
নিবন্ধের সবচেয়ে অস্বস্তিকর আবিষ্কার হলো তথাকথিত knowledge-action gap। আধুনিক মডেলগুলো পোস্ট-ট্রেনিংয়ের পর সত্যিই IPI exposure পূর্বাভাস দেওয়া সংকেত এনকোড করে, কিন্তু নিরাপদ আচরণের নির্ভরযোগ্য ট্রিগার হিসেবে সেগুলো ব্যবহার করে না। মডেল সমস্যাটি "অনুভব" করে, তবুও এগিয়ে যায়।
কাজের যুক্তি অনুযায়ী কারণ হলো, সংকেত উপস্থাপনায় থাকে, কিন্তু কর্মনীতির সাথে স্থিতিশীল সংযোগে যুক্ত নয়। সাধারণ প্রত্যাখ্যান কিংবা সিস্টেম প্রম্পটের নির্দেশ — কোনোটিই এই ফাঁক বন্ধ করে না; তারা ভিন্ন স্তরে কাজ করে।
প্রোব-নিয়ন্ত্রিত সুরক্ষা
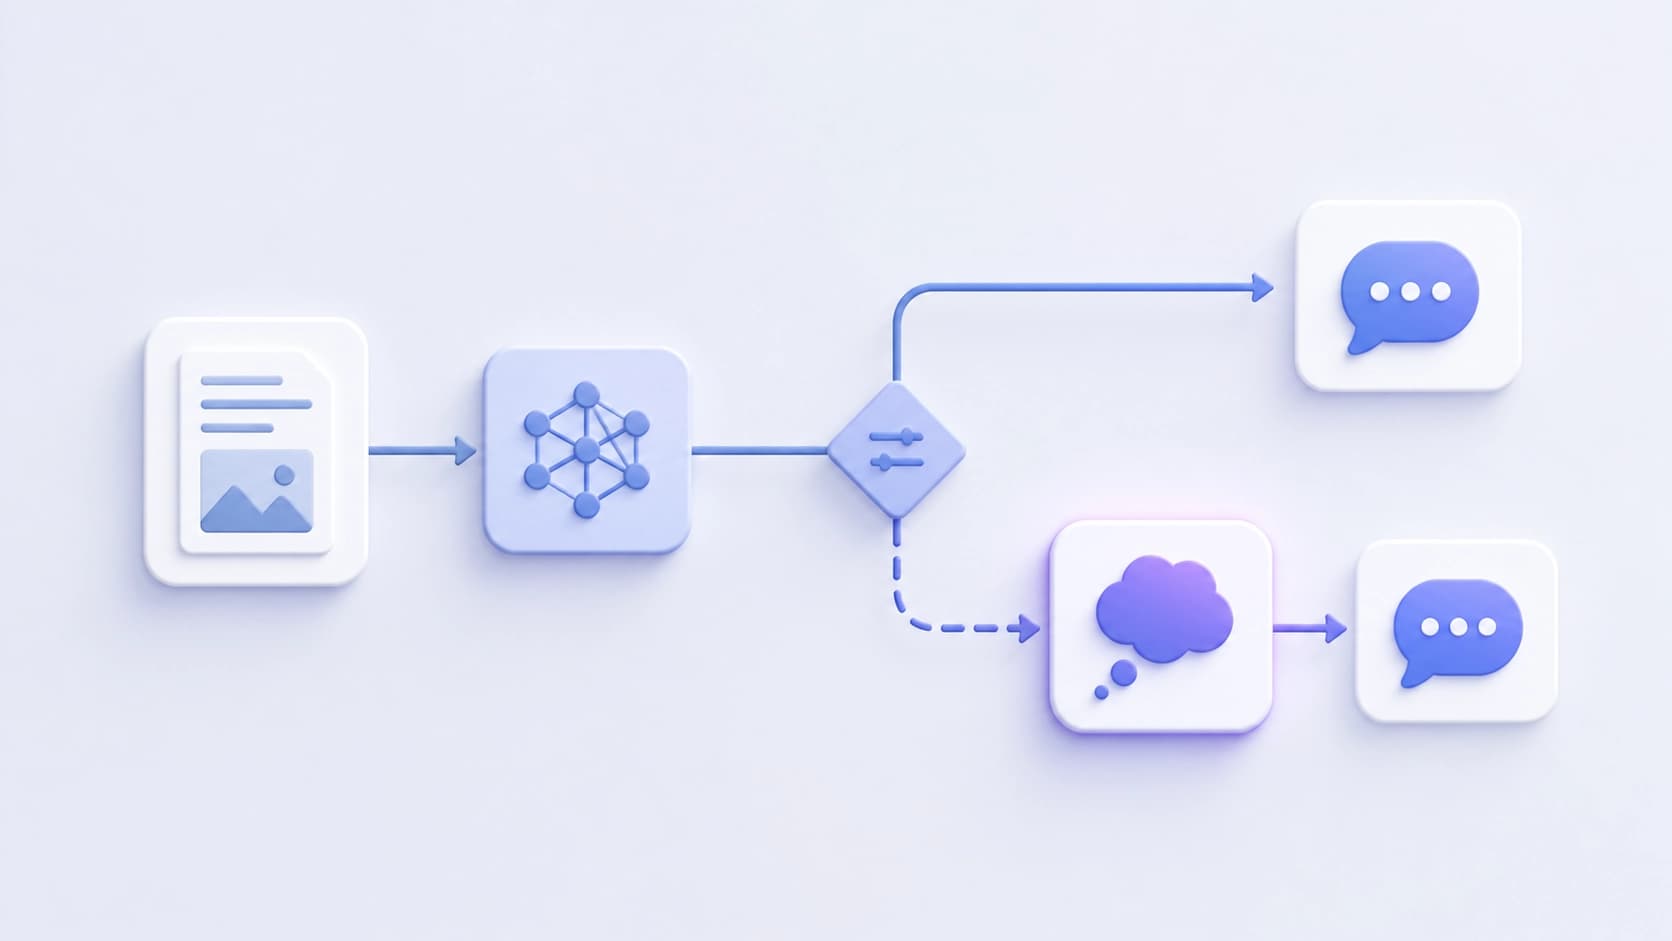
সংকেত থাকলে সরাসরি তা কাজে লাগানোই যুক্তিসঙ্গত। লেখকেরা এমন সুরক্ষা প্রস্তাব করেন, যেখানে মডেলের যুক্তি-প্রক্রিয়া কেবল তখনই চালু হয় যখন প্রোব exposure শনাক্ত করে। সহজ কথায়: ডিটেক্টর কম কিন্তু নিখুঁতভাবে সক্রিয় হয়, আর ব্যয়বহুল বিশ্লেষণ-প্রক্রিয়া তার নির্দেশে চলে, সবসময় নয়।
বেঞ্চমার্ক AgentDojo-র জটিল কনফিগারেশনে এই পদ্ধতি সফল আক্রমণের হার লক্ষণীয়ভাবে কমায় — যেমন Qwen3.5-27B-তে ৩৪.৬% থেকে শূন্যে। গুরুত্বপূর্ণ একটি দিক: যেসব "পরিষ্কার" টাস্কে কোনো ইনজেকশন নেই, সেখানে এই পদ্ধতি বেসলাইন সুরক্ষার চেয়ে ভালোভাবে কার্যকারিতা ধরে রাখে। ডিটেক্টরগুলোর সাধারণত এটিই অভাব — হয় তারা কম ধরে, নয়তো সবসময় কাজে বাধা দেয়।
লুকানো অবস্থাগুলো শব্দে কী "বলে"
কাজের তৃতীয় অংশ একটি ব্যাখ্যামূলক ফ্রেমওয়ার্ক। লেখকেরা স্বাভাবিক ভাষার এমন বাক্য খোঁজেন, যেগুলো প্রোব যা শনাক্ত করে তার সাথে দৃঢ়ভাবে সম্পর্কিত। এভাবে একধরনের টেক্সট-প্রোফাইল তৈরি হয়: সেগুলো দেখায়, ডিটেক্টরের সক্রিয় হওয়ার সাথে ঠিক কোন "ভাবনাগুলো" থাকে।
এখানে আগ্রহের বিষয় হলো অসমতা। কিছু মডেলে লেটেন্ট সংকেত সরাসরি হুমকির অনুভূতির সাথে মেলে — যেমন "এই লেখায় এমন নির্দেশ আছে যা আমাকে দেওয়া হয়নি"। আবার অন্যগুলোতে তা পরোক্ষ পরিচালন-সংকেতের সাথে যুক্ত: অস্বাভাবিক ডেটা-ফরম্যাট, সন্দেহজনক উৎস, বর্তমান কাজের সাথে সংঘর্ষ। অর্থাৎ একই ডিটেক্টর মডেলভেদে ভিন্ন অভ্যন্তরীণ প্রক্রিয়ার উপর নির্ভর করতে পারে।
বাস্তবে এর অর্থ কী
যারা এজেন্টিক সিস্টেম বানান, তাদের জন্য সিদ্ধান্তগুলো বেশ প্রায়োগিক:
- কাজের আগেই যাচাই করা যায়। সংকেত জেনারেশনে ঢোকার সময়েই পাওয়া যায় — অর্থাৎ এজেন্ট টুল ডাকার আগেই পাইপলাইনে যুক্ত করা যায়।
- রৈখিক প্রোব একটি সস্তা সুরক্ষা-স্তর। প্রতিটি অনুরোধে মডেলের দ্বিতীয় পাস বা বাহ্যিক ক্লাসিফায়ারের চেয়ে এটি তুলনাহীনভাবে হালকা।
- শুধু প্রম্পটের উপর ভরসা করবেন না। knowledge-action gap বোঝায়, "দয়া করে ডকুমেন্টের নির্দেশ উপেক্ষা করো" — কোনো নিশ্চয়তা নয়, এমনকি মডেল সব বুঝলেও।
- ভুল সক্রিয় হওয়ার খরচ হিসাব করুন। পদ্ধতির মূল যুক্তি হলো এটি পরিষ্কার টাস্কে কাজে বাধা দেয় না, এবং এটি নিজের ট্রাফিকে যাচাই করা উচিত।
খোলা প্রশ্ন
"সংকেত আছে কি না" — এই প্রশ্নের উত্তর নিবন্ধটি দৃঢ়ভাবে দেয়, তবে কয়েকটি অস্বস্তিকর জায়গা রেখে যায়। লুকানো অবস্থাভিত্তিক ডিটেক্টর নিজেই আরেকটি আক্রমণ-পৃষ্ঠ: প্রতিপক্ষ যদি প্রোব সম্পর্কে জানে, সে ইনজেকশন এমনভাবে অপ্টিমাইজ করতে পারে যাতে সংকেত তৈরি না হয়। ক্রস-ভাষিক স্থিতিশীলতা যাচাই করা হয়েছে, তবে ভাষা ও ডোমেইনের পরিধি তবুও পরীক্ষার ডেটার মধ্যেই সীমাবদ্ধ।
আরেকটি প্রশ্ন হলো স্থানান্তরযোগ্যতা। প্রোব নির্দিষ্ট একটি মডেলের জন্য প্রশিক্ষিত হয়: প্রতিটি আর্কিটেকচারের নিজস্ব উপস্থাপনা থাকে, আর যেকোনো API-তে সহজে যুক্ত করা যায় এমন সর্বজনীন "সেন্সর" এই কাজ থেকে পাওয়া যায় না। শুধু টেক্সট-অ্যাক্সেসযুক্ত বন্ধ মডেলের জন্য এই পদ্ধতি নীতিগতভাবেই প্রযোজ্য নয় — লুকানো অবস্থা দরকার।
তবুও দিকটি সম্ভাবনাময় মনে হয়। মডেল কত ভালোভাবে নির্দেশ মানে তা নিয়ে তর্ক করার বদলে গবেষকেরা তার অভ্যন্তরীণ অবস্থার দিকে তাকিয়ে নিশ্চিত হওয়ার প্রস্তাব দেন যে সেখানে প্রয়োজনীয় সংকেত আগেই আছে। এরপরের প্রশ্নটি প্রকৌশলের: এই জ্ঞানকে নির্ভরযোগ্যভাবে কাজে রূপান্তর করা যায় কীভাবে।


