
ওপেন সোর্সে কী প্রকাশ করা হয়েছে
"কোন মডেলটি সেরা" — এই আলোচনা প্রায় সবসময়ই একটি সমস্যায় আটকে যায়: সংখ্যাগুলো কেউ যাচাই করেনি। পরিমাপ করা হয় ভিন্ন মেশিনে, ভিন্ন কোয়ান্টাইজেশনে, রানটাইমের ভিন্ন বিল্ডে — আর সেগুলো পরস্পরের সাথে তুলনা করা অর্থহীন। Liquid AI কোম্পানি এই সমস্যার সমাধান চেয়েছে openness এবং reproducibility-র মাধ্যমে: তারা Pipette প্রকাশ করেছে, যা edge-ডিভাইসে ফাউন্ডেশনাল মডেল বেঞ্চমার্কিংয়ের একটি প্ল্যাটফর্ম। পদ্ধতিটি স্বতন্ত্রভাবে যাচাই করেছে Artificial Analysis।
পুরো কাঠামোটি যে মূল ধারণার উপর দাঁড়িয়ে আছে: ডিভাইসে আচরণ হলো ডিপ্লয় করা সিস্টেমের একটি বৈশিষ্ট্য, বিচ্ছিন্ন অবস্থায় মডেলের নয়। অর্থাৎ, পরিমাপের এককও "মডেল" হওয়া উচিত নয়, বরং সম্পূর্ণ কনফিগারেশন: ওয়েট প্লাস কোয়ান্টাইজেশন স্কিম প্লাস রানটাইম এনভায়রনমেন্ট প্লাস নির্দিষ্ট হার্ডওয়্যার। এই থিসিস থেকেই ডেটাসেটের গঠন এবং নিচের সব তুলনা কীভাবে পড়তে হবে তা উঠে আসে।
স্টার্টার ডেটাসেটে কী কী আছে
- ডিভাইসে পারফরম্যান্সের পাঁচটি মেট্রিক;
- মডেল × কোয়ান্টাইজেশন × রানটাইম × ডিভাইস × কনটেক্সট দৈর্ঘ্যের সমন্বয়ে এক হাজারেরও বেশি কনফিগারেশন;
- ৩০টিরও বেশি মডেল এবং কয়েকটি কোয়ান্টাইজেশন ফরম্যাট;
- macOS, iOS, Windows এবং Android-এর জন্য llama.cpp বিল্ড;
- ২৫৬ থেকে ৮,১৯২ টোকেন পর্যন্ত কনটেক্সট দৈর্ঘ্য।
প্রথম প্রকাশিত পরিমাপগুলো করা হয়েছে M5 Max সহ MacBook Pro, iPhone 17 Pro এবং Galaxy S26 Ultra-তে। AMD Ryzen AI Max+ 395 এবং Radeon 8060S-এর ফলাফল এখনও "coming soon" হিসেবে চিহ্নিত — অর্থাৎ প্ল্যাটফর্মটি শুরুতেই ক্রস-প্ল্যাটফর্ম হিসেবে ঘোষণা করা হয়েছে, তবে হার্ডওয়্যার কভারেজ এখনও বাড়ছে।
প্রথম রানের চারটি সিদ্ধান্ত
একই প্যারামিটার — দীর্ঘ কনটেক্সটে ভিন্ন আচরণ
এই ধরনের পরিমাপ কেন দরকার তার একটি ভালো উদাহরণ। ৩৫০M প্যারামিটারের দুটি মডেল একই ফোনে একই Q4_K_M-এ ইনপুট টোকেন বাড়ার সাথে সাথে ভিন্নভাবে আচরণ করে: Granite-4.0-H-350M ২৫৬ থেকে ৪,০৯৬ ইনপুট টোকেনে যাওয়ার সময় ডিকোডিং থ্রুপুটের ৭৮.৪% ধরে রাখে, আর Granite-4.0-350M — মাত্র ৩৩.৮%। এখানে প্যারামিটারের সংখ্যা কোনো ইঙ্গিত দেয় না: পার্থক্যটি আর্কিটেকচারে এবং সেটি নির্দিষ্ট রানটাইম ও চিপে কীভাবে খাপ খায় তার মধ্যে।
স্পার্স অ্যাক্টিভেশন গণনা বাঁচায়, কিন্তু মেমরি নয়
একই ফোনে LFM2.5-8B-A1B ২,০৪৮ ইনপুট টোকেনে Qwen3.5-4B-এর চেয়ে ২.৪ গুণ দ্রুত এবং Ministral-3-3B-Instruct-2512-এর চেয়ে ২.৬ গুণ দ্রুত ডিকোড করে। রহস্যটি স্পার্স অ্যাক্টিভেশনে: প্রতি টোকেনে ৮.৫B প্যারামিটারের মধ্যে প্রায় ১.৫B ব্যবহৃত হয়। কিন্তু এতে পিক মেমরি ব্যবহার ৫.২৯ GiB, কারণ সব এক্সপার্ট ওয়েট পুরোপুরি মেমরিতে থাকতেই হবে। ব্যবহারিক সিদ্ধান্ত: MoE-সদৃশ আর্কিটেকচার সময়ে জেতে, কিন্তু RAM বাজেট বাঁচায় না — আর ফোনে সীমাবদ্ধতা প্রায়ই ঠিক মেমরিতেই আটকে যায়।
দ্রুত মানেই ভালো নয়
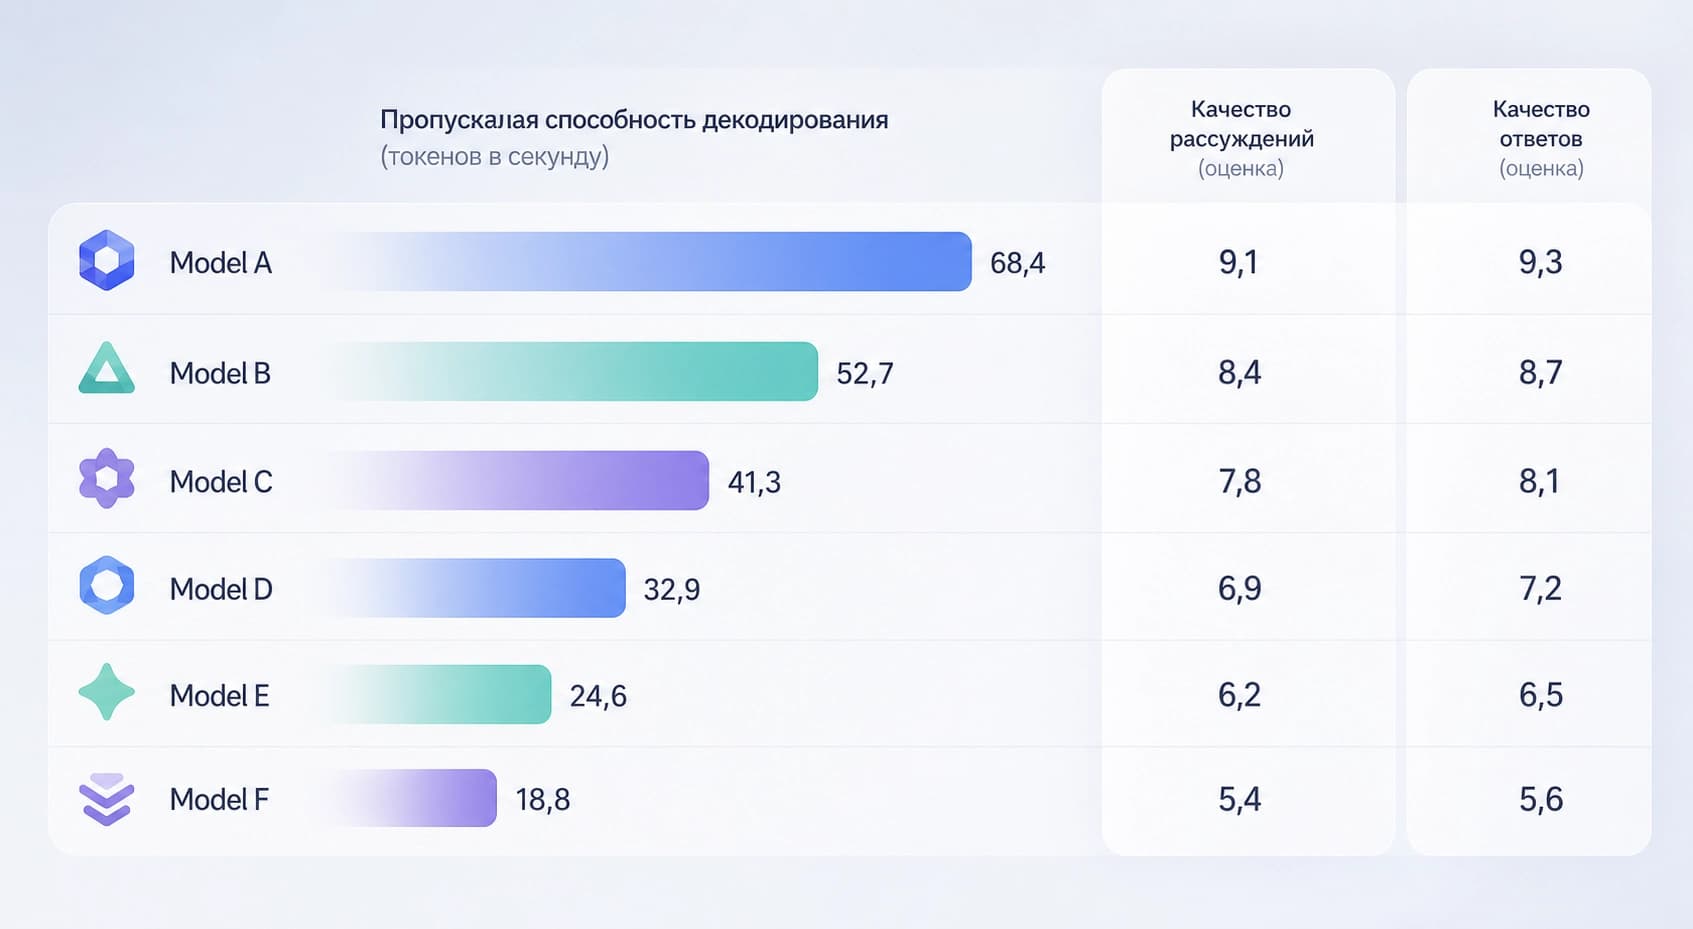
iPhone 17 Pro-তে Q4_K_M-এ MiniCPM5-1B ২,০৪৮ ইনপুট / ২৫৬ আউটপুট টোকেনের লোড ৩.৪৭ সেকেন্ডে সম্পন্ন করে, যেখানে LFM2.5-1.2B-Instruct — ৪.১২ সেকেন্ডে, অর্থাৎ প্রথমটি ১৫.৮% দ্রুত। তবে একই আর্টিফ্যাক্টে LFM MATH-500-এ ৯.০ পয়েন্ট বেশি পায়। থ্রুপুট এবং গুণমান — ভিন্ন অক্ষ, আর টেবিলের একটি সংখ্যা দেখে মডেল বাছাই করা অর্থহীন।
প্রায় অভিন্ন সিস্টেম প্রোফাইল টাস্কে উল্টো ফল লুকাতে পারে
M5 Max-এ Q4_K_M এবং ২,০৪৮ ইনপুট টোকেনে Granite-4.1-8B এবং Ministral-3-8B-Instruct-2512 ডিকোডিং থ্রুপুটে মাত্র ২.৪% এবং পিক RAM-এ ১.২% আলাদা। কিন্তু টাস্কে ছবি বদলে যায়: Granite IFBench-এ ৭.৩ পয়েন্ট জেতে, যেখানে Ministral GPQA Diamond-এ এটির চেয়ে ১৪.০ পয়েন্ট এগিয়ে। "হার্ডওয়্যার" প্রোফাইলের পার্থক্য শোরগোলের সীমার মধ্যে, আচরণের পার্থক্য — মৌলিক।
পরিমাপ কীভাবে সাজানো
পারফরম্যান্স রানগুলো নির্দিষ্ট টোকেন ফর্ম, গ্রিডি ডিকোডিং, বাদ দেওয়া ওয়ার্মআপ এবং পাঁচটি পরিমাপযোগ্য পুনরাবৃত্তির উপর নির্মিত। প্রতিটি পুনরাবৃত্তির আগে readiness gating চালু হয়: প্ল্যাটফর্ম-নির্দিষ্ট একটি চেক নিশ্চিত করে যে তাপীয় অবস্থা এবং ব্যাকগ্রাউন্ড লোড স্বাভাবিক। ব্যর্থ রানগুলো প্রকাশনায় যায় না — এটিই একটি reproducible বেঞ্চমার্ককে এককালীন স্ক্রিপ্ট থেকে আলাদা করে।
আলাদা একটি বিষয় — গুণমান। এটি একই রানে পরিমাপ করা হয় না: এর জন্য IFBench, GPQA Diamond এবং MATH-500 ব্যবহার করা হয়, আর স্কোরগুলো নেওয়া হয় NVIDIA H100 80GB সহ রেফারেন্স সিস্টেমে llama.cpp ইভালুয়েশন রান থেকে। এরপর সেগুলো একই মডেল ও একই কোয়ান্টাইজেশনের জন্য ডিভাইসে করা রানের সাথে মেলানো হয়। একটি গুরুত্বপূর্ণ পরিণতি: ফোনের থ্রুপুটের পাশে বসানো গুণমানের সংখ্যাটি ফোনে পাওয়া নয়। এটি মডেলগুলোর পারস্পরিক তুলনার জন্য সুবিধাজনক মেট্রিক, কিন্তু নির্দিষ্ট স্মার্টফোনে কী ঘটছে তার পরিমাপ নয়।
ঠিক কী ওপেন সোর্সে দেওয়া হচ্ছে
Pipette সম্পূর্ণভাবে সরবরাহ করা হয়, কোনো ওয়েটলিস্ট ছাড়াই:
- Apache 2.0-এর অধীনে ইনফ্রাস্ট্রাকচার — pipette-mgmt, pipette-clients এবং pipette-scores রিপোজিটরি;
- ফলাফলের পাবলিক ডেটাসেট;
- হোস্টেড ড্যাশবোর্ড;
- iOS এবং Android-এ বেঞ্চমার্কিংয়ের জন্য নেটিভ অ্যাপ।
একমাত্র অংশটি যা এখনও সাধারণ অ্যাক্সেসের জন্য প্রস্তুত নয় — কমিউনিটির পাঠানো ফলাফল প্রকাশ: এটি বেটায়। বাকি সবকিছু নিজে চালানো যায়, নিজের পেরিমিটারের ভিতরে পাইপলাইন ডিপ্লয় করা সহ।
কার জন্য এবং কেন এটি দরকার
লক্ষ্য দর্শকদের এভাবে বর্ণনা করা সবচেয়ে সহজ: এটি যেকোনো দল, যারা এমন হার্ডওয়্যারে মডেল প্রকাশ করে যা তাদের নিজের নয়। এরপর বিকল্পগুলো স্কেল অনুযায়ী ভিন্ন হয়।
- সোলো ডেভেলপার এবং সিড-স্টেজের স্টার্টআপের জন্য ড্যাশবোর্ড এবং মোবাইল অ্যাপই যথেষ্ট — নিজস্ব ইনফ্রাস্ট্রাকচার দরকার নেই।
- মাঝারি আকারের প্রোডাক্ট টিম অভ্যন্তরীণ ডিভাইস ফ্লিটে ক্লায়েন্ট ডিপ্লয় করতে পারে এবং নিজের কনফিগারেশনে পরিমাপ পেতে পারে।
- বড় OEM, চিপ প্রস্তুতকারক এবং এন্টারপ্রাইজ পুরো পাইপলাইন ফায়ারওয়ালের পিছনে রাখতে পারে — যা পরিমাপের ডেটা কোথায় যায় সেই প্রশ্ন দূর করে।
সাধারণ কাজগুলোও বাড়তি ব্যাখ্যা ছাড়াই স্পষ্ট: স্প্রিন্টের কাজ চূড়ান্ত হওয়ার আগেই মডেল ও কোয়ান্টাইজেশন ফরম্যাট বেছে নেওয়া; SoC বা সরঞ্জাম কেনা ন্যায্যতা দেওয়া; রানটাইম, OS বা ড্রাইভার আপডেটে রিগ্রেশন ধরা; কনটেক্সট দৈর্ঘ্য অনুযায়ী ক্যাপাসিটি পরিকল্পনা করা; ভেন্ডরদের বিজ্ঞাপনী প্রতিশ্রুতি স্বতন্ত্রভাবে যাচাই করা। শিল্পগুলো — কনজিউমার ইলেকট্রনিক্স এবং স্মার্টফোন OEM, অটোমোটিভ, শিল্প ও রোবোটিক্স, মেডিকেল ডিভাইস, ফাইন্যান্সিয়াল সার্ভিসেস, প্রতিরক্ষা: যেখানেই লেটেন্সি, প্রাইভেসি বা সংযোগের অভাব সরাসরি ডিভাইসে মডেল চালাতে বাধ্য করে।
সংখ্যায় ভরসা করার আগে কী দেখবেন
তিনটি বিষয়, যেগুলো যেকোনো পরিমাপের টেবিল পড়ার সময় সহজেই ভুলে যাওয়া যায়।
প্রথমত, গুণমানের সংখ্যা এবং পারফরম্যান্সের সংখ্যা ভিন্ন জায়গা থেকে আসে। থ্রুপুট ডিভাইসে পরিমাপ করা, গুণমান — H100 সহ রেফারেন্স সিস্টেমে এবং তারপর মেলানো। মডেল তুলনার জন্য এটি সঠিক, নির্দিষ্ট অ্যাপ্লিকেশনে আচরণের পূর্বাভাসের জন্য — নয়।
দ্বিতীয়ত, কোয়ান্টাইজেশনকে বাদ দেওয়া যায় না। একই ফরম্যাট ভিন্ন মডেল ও ভিন্ন রানটাইমে ভিন্ন ফল দেয়, আর মেমরির সীমাবদ্ধতা প্রায়ই নির্ণায়ক হয়ে ওঠে — যেমন স্পার্স অ্যাক্টিভেশনের উদাহরণে, যেখানে গতি বেড়েছে, কিন্তু ৫.২৯ GiB কোথাও যায়নি।
তৃতীয়ত, একই রকম পারফরম্যান্স মডেলগুলো নির্দিষ্ট টাস্কে কেমন কাজ করবে সে সম্পর্কে কিছুই বলে না। প্রায় অভিন্ন সিস্টেম প্রোফাইলে IFBench এবং GPQA Diamond-এ Granite ও Ministral-এর উল্টো ফল — ঠিক সেই ক্ষেত্র যেখানে প্রথমে টাস্ক নির্ধারণ করতে হয় এবং তারপরই টেবিলের দিকে তাকাতে হয়।


