এজেন্টদের জন্য আরেকটি পরিমাপ কেন দরকার
বেশিরভাগ এজেন্ট বেঞ্চমার্ক পরিচিত প্রশ্নের উত্তর দেয়: মডেল সঠিক টুল বেছেছে কি না, আর্গুমেন্ট ঠিকভাবে সাজিয়েছে কি না, কাঙ্ক্ষিত ফলাফলে পৌঁছেছে কি না। এমন প্রায় সব পরিমাপই ক্রমিক সম্পাদনকে কেন্দ্র করে গড়া — একটার পর একটা কল, কোনো তাড়া নেই, সম্পদের জন্য প্রতিযোগিতা নেই।
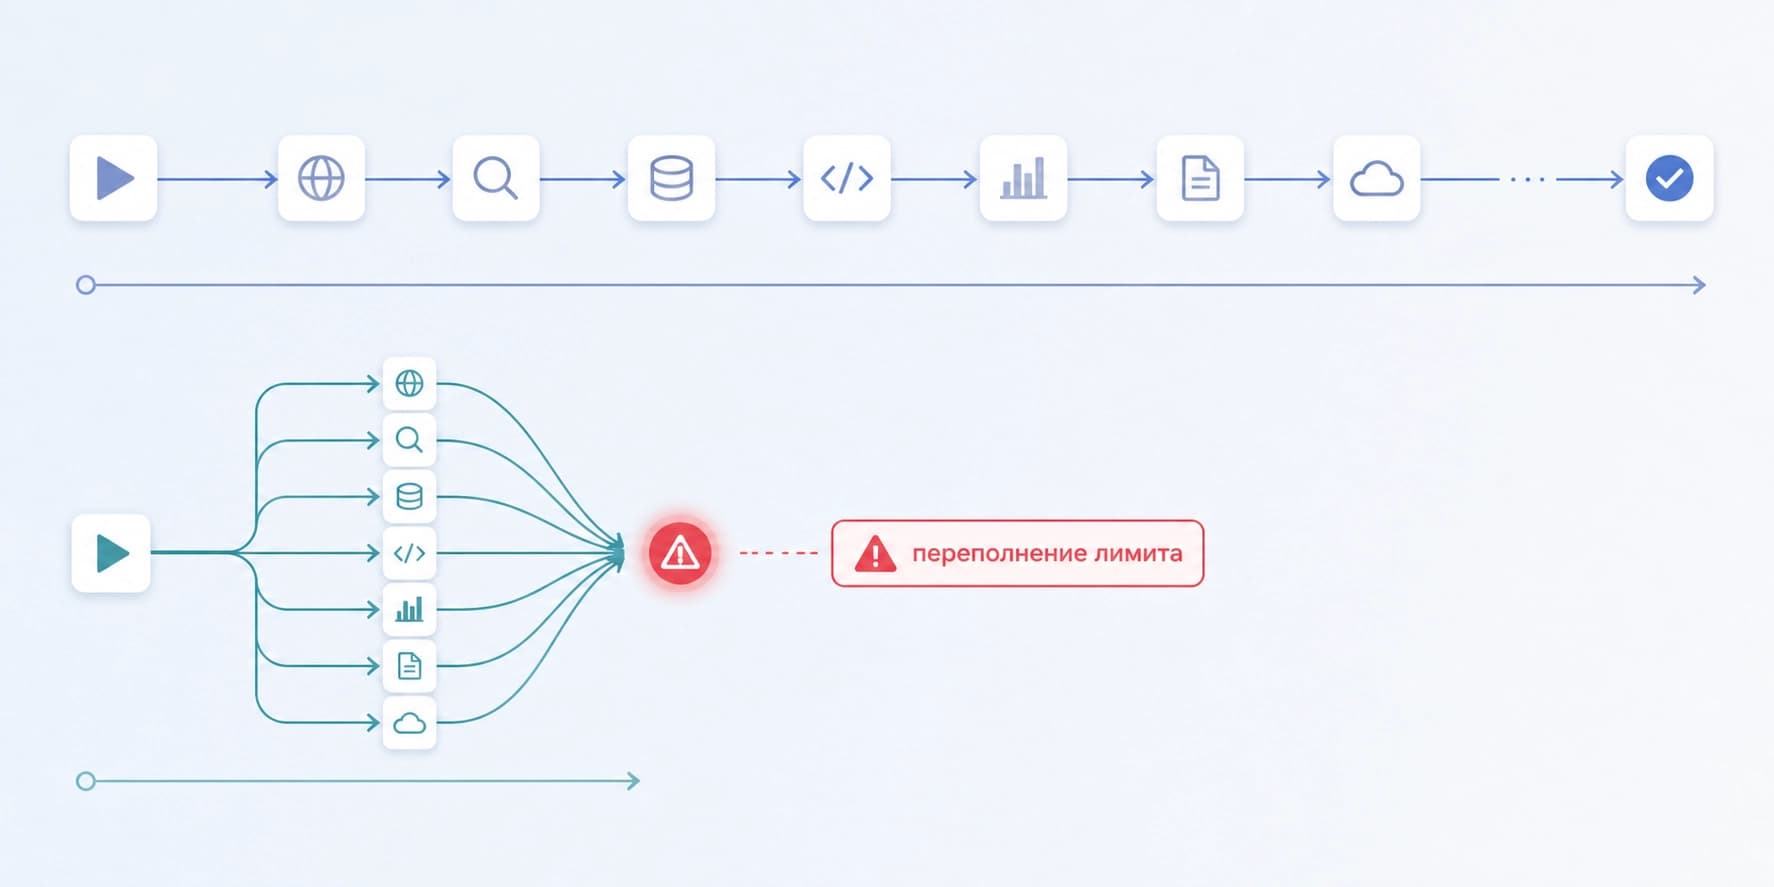
কিন্তু প্রকৃত ব্যবহার完全不同 দেখতে। গ্রহণযোগ্য বিলম্বের মধ্যে থাকতে হলে এজেন্টকে স্বাধীন কলগুলো সমান্তরালে চালাতে হয়। কিন্তু সীমা না মেনে সমান্তরালতা আরেক দেয়ালে গিয়ে ঠেকে: নিঃশেষিত কোটা, উপচে পড়া মেমরি, বিকল হয়ে যাওয়া বাইরের সার্ভিস।
PeakBench ঠিক এই অন্ধ জায়গাটার কথা বলে। লেখক Zhi-Kai Chen, Xu-Xiang Zhong, Song-Yan Li, De-Chuan Zhan এবং Han-Jia Ye এটি বর্ণনা করেছেন arXiv:2608.24509 প্রিপ্রিন্টে (২৫ আগস্ট ২০২৬-এর v1, ক্যাটাগরি cs.AI ও cs.SE); কোড নিবন্ধের সঙ্গে প্রকাশের প্রতিশ্রুতি আছে।
মূল ভাবনা, যা থেকে পুরো কাজটা এসেছে: এজেন্টের ব্যর্থ হওয়ার দুটি উপায় আছে, আর তারা পরস্পর বিপরীত। ক্রমিক সম্পাদন নিরাপদ, কিন্তু ধীর — সীমা ছাড়ানো হয় না শুধু এই কারণে যে একসঙ্গে কিছুই করা হচ্ছে না। সম্পদ না মেনে সমান্তরালতা দ্রুত, কিন্তু এমন উপচে পড়ার দিকে নিয়ে যায় যা সহজেই এড়ানো যেত। এই দুই মেরুর মাঝখানেই আছে সেই জিনিস, যা কেউ ঠিকঠাক মাপেনি।
বেঞ্চমার্কটি আসলে কী
এখানে রেফারেন্স উত্তরসহ স্থির কাজের বদলে ব্যবহার করা হয় সম্পাদনযোগ্য বহু-টুল ওয়ার্কফ্লো। প্রতিটির দুটি গুরুত্বপূর্ণ সংযোজন আছে: নির্ভরতার অ্যানোটেশন, যা দেখায় কোন ধাপগুলো সত্যিই পরস্পর সম্পর্কিত, এবং পরিমাপ করা সম্পদ-প্রোফাইল — একটি নির্দিষ্ট কল কতটা মেমরি, সময় বা কোটা খায়।
এই গঠন মূল্যায়নের বিষয়টাই বদলে দেয়। "সঠিক উত্তর এসেছে কি" প্রশ্নটি পিছিয়ে যায়, আর সামনে আসে প্রশ্নটি — "এজেন্ট কাজটা সময়ের মধ্যে কীভাবে ভাগ করল এবং বাজেট ছাড়াল কি না"।
লজিক্যাল পরিকল্পনা বনাম ফিজিক্যাল
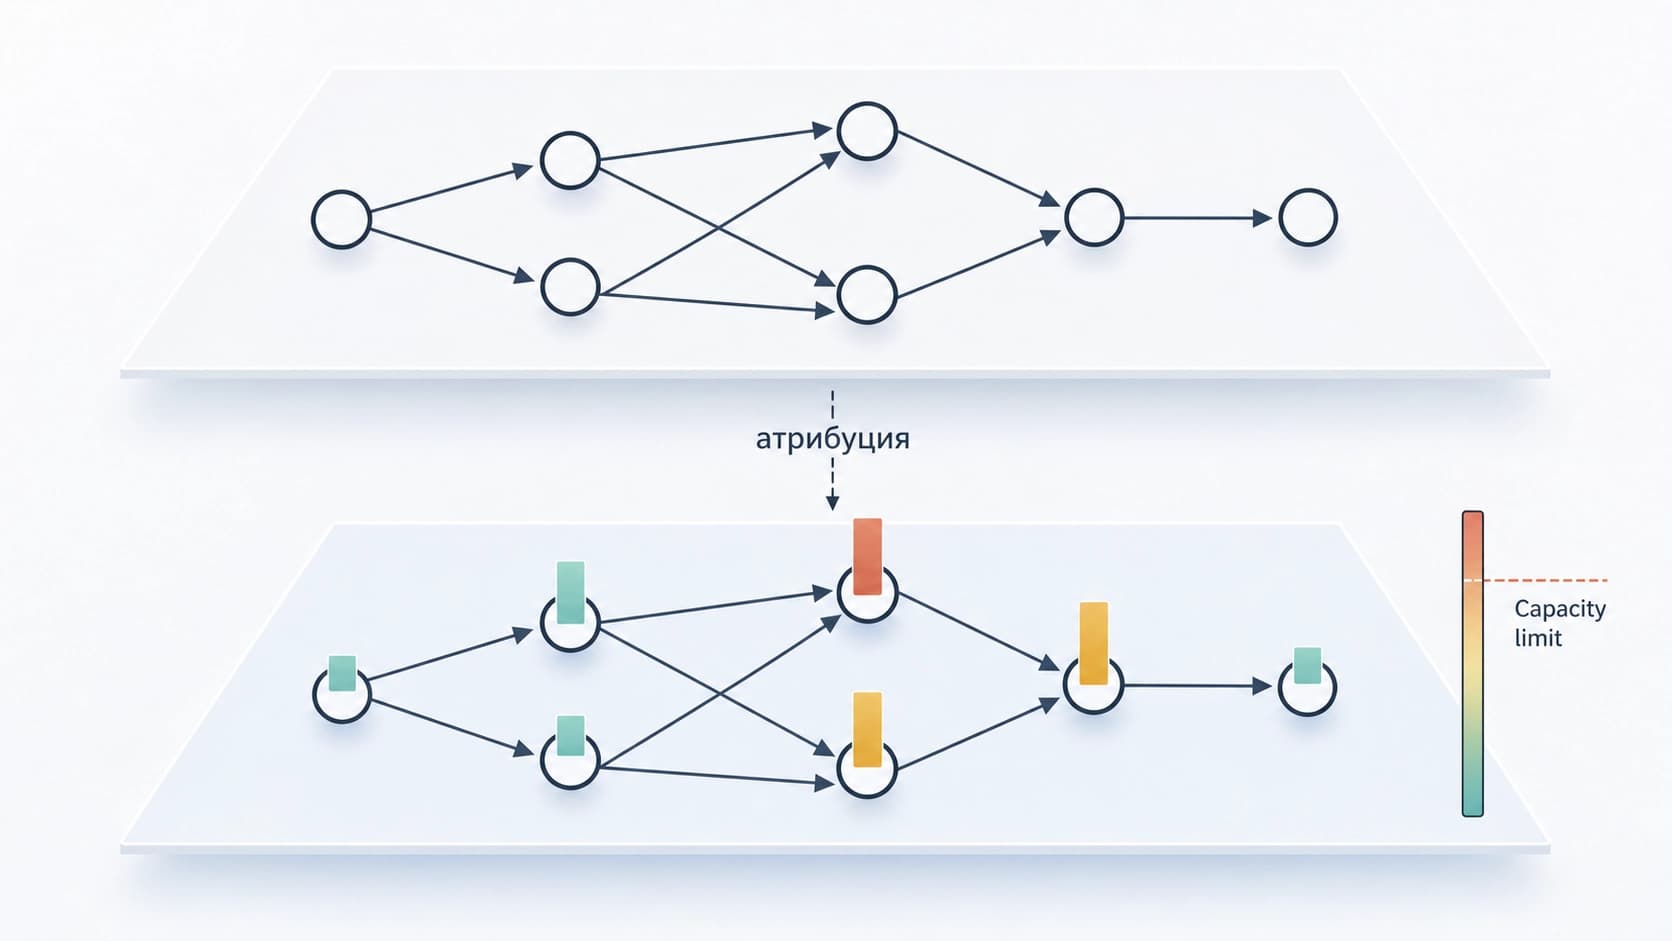
এ ধরনের প্রক্রিয়া মূল্যায়নে কেন্দ্রীয় জটিলতা হলো অ্যাট্রিবিউশন। যখন একটি রান ভেঙে পড়ে, তখন স্পষ্ট নয় ঠিক কী দায়ী: এজেন্ট নির্ভরতাগুলো ভুল বুঝেছে, নাকি ঠিক বুঝেছে কিন্তু উপলব্ধ সম্পদ হিসাব করেনি, নাকি দুটোই একসঙ্গে। সবকিছু একটিমাত্র সাফল্যের মেট্রিকে ঢেলে দেওয়া মানে সবচেয়ে কাজের জিনিসটা হারানো।
তাই মূল্যায়ন দুই ভাগে ভাগ করা হয়েছে। একটি পরিমাপ লজিক্যাল পরিকল্পনার জন্য: ধাপের ক্রম, নির্ভরতার সঠিকতা, বানানো সম্পর্কের অনুপস্থিতি। অন্যটি ফিজিক্যাল পরিকল্পনার জন্য, অর্থাৎ বাস্তব সীমাবদ্ধতা মেনে সময়সূচি। এই দুই পরিমাপের মেট্রিক আলাদা, আর একটিতে ব্যর্থতা অন্যটির সাফল্য ঢেকে দেয় না।
ভুল ক্রম আর ভুল বাজেট — আলাদা দুটি রোগ
দুই-ভাগের এই পরিকল্পনা সুন্দর কোনো শ্রেণিবিন্যাসের জন্য নয়, রোগনির্ণয়ের জন্য। এজেন্ট যদি লজিকের স্তরে ভুল করে, তাকে কোয়ার সাইজ নিয়ে বলা অর্থহীন — সে বোঝেনি কোনটা কার ওপর নির্ভর করে। আর যদি লজিক ঠিক থাকে কিন্তু সম্পাদন ভেঙে পড়ে, সমস্যা পরিকল্পনাকারীতে বা এজেন্টকে উপলব্ধ সম্পদ জানানোর ধরনটায়।
এজেন্ট সিস্টেম বানানোদের জন্য ব্যবহারিক শিক্ষা: কিছু ঠিক করার আগে বোঝা দরকার, ব্যর্থতাটা এই দুই স্তরের কোনটির। প্রম্পট-ইঞ্জিনিয়ারিং, ট্রাজেক্টরিতে প্রশিক্ষণ আর টুল সংশোধন সম্পূর্ণ আলাদা আলাদা সমস্যার সমাধান করবে।
মূল ফলাফল: নিখুঁত লজিকও ওভারলোড থেকে বাঁচায় না
কাজটির সবচেয়ে অপ্রিয় সিদ্ধান্ত শোনায় এমন: শক্তিশালী লজিক্যাল পরিকল্পনা সম্পদ-সীমাবদ্ধ অবস্থায় নিরাপদ বা কার্যকর সম্পাদনের নিশ্চয়তা দেয় না। এজেন্ট নির্ভুলভাবে নির্ভরতার গ্রাফ বানাতে পারে — তবুও প্রান্ত দিয়ে যুক্ত নয় এমন সবকিছু একসঙ্গে চালিয়ে সিস্টেম ফেলে দিতে পারে।
সম্পদ প্রকাশ করা preventable-উপচে পড়ার সংখ্যা কমায়
দ্বিতীয় পর্যবেক্ষণ: এজেন্টকে উপলব্ধ সম্পদের তথ্য দিলে প্রতিরোধযোগ্য উপচে পড়ার সংখ্যা কমে, আর ব্যবহার বাড়ে। এটি জাদু নয়, নতুন আর্কিটেকচারও নয় — শুধু কনটেক্সটে টুলের বর্ণনার সঙ্গে বাজেটও ঢোকে, যা মেনে চলতে হবে।
এখানে প্রভাবটা বেশি ভাবা উচিত নয়। কথা হলো, সম্পদ নিয়ে স্বচ্ছতা একটি সস্তা ও কার্যকর হস্তক্ষেপ, এটা নয় যে এটি সমস্যাটা পুরোপুরি সমাধান করে: এজেন্টকে এখনও এই তথ্য দক্ষতার সঙ্গে কাজে লাগাতে হবে।
কাদের কাজে লাগবে
বেঞ্চমার্কটি এজেন্টদের সম্পদ-সচেতন আচরণ নির্ণয়ের স্ট্যান্ড হিসেবে ভাবা হয়েছে, আর এটাই এর মূল উদ্দেশ্য। এটি ততটা চূড়ান্ত স্কোর দেয় না, বরং দেখায় মডেলের ঠিক কোথায় ছিঁড়ছে: নির্ভরতা বোঝায়, নাকি খরচের শৃঙ্খলায়।
এখান থেকে কয়েকটি ব্যবহারের দৃশ্য। এজেন্ট ফ্রেমওয়ার্ক বানানোদের জন্য — প্রোডাকশনের আগে পরিকল্পনাকারী যাচাইয়ের উপায়, দুর্ঘটনার পরে নয়। গবেষকদের জন্য — কনটেক্সটে বাজেট নিয়ে পরীক্ষার পুনরুৎপাদনযোগ্য সেটআপ। আর কঠোর সীমার কাজে মডেল বাছাই করা যারা, তাদের জন্য — মডেলগুলোর মধ্যে যে পার্থক্য সাধারণ সাফল্যের পরীক্ষা দেখায় না, তা দেখার সুযোগ।
মনে রাখা দরকার
এই পদ্ধতির একটি স্পষ্ট প্রবেশমূল্য আছে: সম্পদ-প্রোফাইল মাপতে হয়, আর নির্ভরতা চিহ্নিত করতে হয়। বাস্তব সিস্টেমে সীমা শব্দ করে, বাইরের সার্ভিস লোডে আচরণ বদলায়, আর একটি কলের খরচ সবসময় আগে থেকে জানা থাকে না। এখানে ল্যাবরেটরির নিখুঁততা যুদ্ধক্ষেত্রের চেয়ে বেশি, তাই সিদ্ধান্তগুলো হুবহু প্রোডাকশনে বসানো উচিত নয়।
তবে বেঞ্চমার্ক ছাড়াও কাঠামোটা কাজের। দুটি প্রশ্ন — "এজেন্ট ঠিকভাবে বুঝেছে কোনটা কার ওপর নির্ভর করে" এবং "সে বাজেটের মধ্যে থেকেছে কি না" — যেকোনো এজেন্ট সিস্টেমের ক্ষেত্রে জিজ্ঞাসা করা বুদ্ধিমানের কাজ, এমনকি হাতের কাছে যাচাইয়ের তৈরি স্ট্যান্ড না থাকলেও।