
সংক্ষিপ্ত চিন্তার শৃঙ্খল — সবসময় সেরা নয়
"উচ্চস্বরে ভাবতে" শেখানো বড় মডেলগুলো দীর্ঘ চিন্তার শৃঙ্খলের বদৌলতে এগিয়ে থাকে। কাজ যত জটিল, উত্তর দেওয়ার আগে মডেল তত বেশি মধ্যবর্তী ধাপ লিখে যায়। এমন একটি প্রক্রিয়া, যাকে সাধারণত এই মানের জন্য মূল চাবিকাঠি ধরা হয়, তা হলো আত্মপ্রতিফলন: ইতিমধ্যে নেওয়া ধাপগুলোর দিকে ফিরে তাকানো, ভুল লক্ষ্য করা এবং সমাধানের ধারা পুনরায় লেখার ক্ষমতা।
সমস্যা হলো, এই ক্ষমতার জন্য মূল্য দিতে হয়। প্রতিটি পুনর্বিবেচনা মানে ইনফারেন্সে অতিরিক্ত টোকেন, অর্থাৎ টাকা, সময় ও কম্পিউটেশনাল রিসোর্স। অথচ সম্প্রতি পর্যন্ত কেউ স্পষ্টভাবে ব্যাখ্যা করেনি, মডেলের "থেমে নিজেকে আবার যাচাই করা"র সিদ্ধান্তটি আসলে কী দিয়ে নিয়ন্ত্রিত হয়। আত্মপ্রতিফলন ছিল এক কালো বাক্সের ভেতরে আরেক কালো বাক্সের মতো: কাজ করে জানা যায়, কীভাবে — তা নয়।
Ge Yan, Chung-En Sun, Linbo Liu এবং Tsui-Wei Weng-এর কাজটি (arXiv:2512.13979, COLM 2026-এ গৃহীত) প্রশ্নটির দিকে এগোয় অপ্রত্যাশিত এক দিক থেকে — প্রম্পট দিয়ে নয়, ফাইন-টিউনিং দিয়েও নয়, বরং মডেলের লেটেন্ট রিপ্রেজেন্টেশন দিয়ে।
মডেলের ভেতরে প্রতিফলনের দিক
কী খোঁজা হয়েছিল এবং কী পাওয়া গেল
গবেষকরা আত্মপ্রতিফলনের উপর প্রয়োগ করেছেন representation engineering-এর কৌশল — এমন একটি ধারা, যা মডেলের আউটপুটের টেক্সট নয়, বরং তার অভ্যন্তরীণ অ্যাক্টিভেশন নিয়ে চর্চা করে। যুক্তিটি সরল: মডেল যদি "প্রতিফলন করবে" বলে "সিদ্ধান্ত" নেয়, তবে সেই সিদ্ধান্ত তার রিপ্রেজেন্টেশনের কোথাও প্রতিফলিত থাকে। তাহলে তা খুঁজে পাওয়া, বর্ণনা করা এবং — সবচেয়ে গুরুত্বপূর্ণ — ব্যবহার করা সম্ভব।
তাই-ই ঘটেছে। লেটেন্ট স্পেসে একটি নির্দিষ্ট দিক খুঁজে পাওয়া গেছে, যার বরাবর প্রতিফলনসহ ধাপগুলো প্রতিফলনবিহীন ধাপ থেকে আলাদা হয়ে যায়। মূলত এটি "আবার যাচাই করো / করো না" অক্ষ, এবং এই অক্ষে বিন্দুর অবস্থান দুই ধরনের ধাপকে স্থিরভাবে আলাদা করে।
প্রতিফলন নিয়ন্ত্রণ করে অনিশ্চয়তা
নিবন্ধের সবচেয়ে আকর্ষণীয় পর্যবেক্ষণ: খুঁজে পাওয়া দিক বরাবর অ্যাক্টিভেশনের মাত্রা ভালোভাবে পূর্বাভাস দেয়, শেষ পর্যন্ত উত্তরটি সঠিক হবে কি না। অন্য কথায়, প্রতিফলন এলোমেলোভাবে বা কোনো সময়সূচি অনুযায়ী চালু হয় না — তা মডেলের অভ্যন্তরীণ অনিশ্চয়তার সঙ্গে বাঁধা। মডেল যখন "অনুভব" করে পথ পিচ্ছিল, তখন সে থামে ও পুনর্বিবেচনা করে; যখন সব স্পষ্ট, তখন এগিয়ে যায়।
এটি বিশ্বচিত্রে একটি গুরুত্বপূর্ণ পরিবর্তন। প্রতিফলন আর আলাদা একটি ক্ষমতা নয়, যাকে বিকশিত করতে হয়; বরং এটি একটি সংকেত — মডেল নিজেই তার ধাপ নিয়ে সন্দেহ করছে বলে একটি সূচক।
ReflCtrl কীভাবে গঠিত
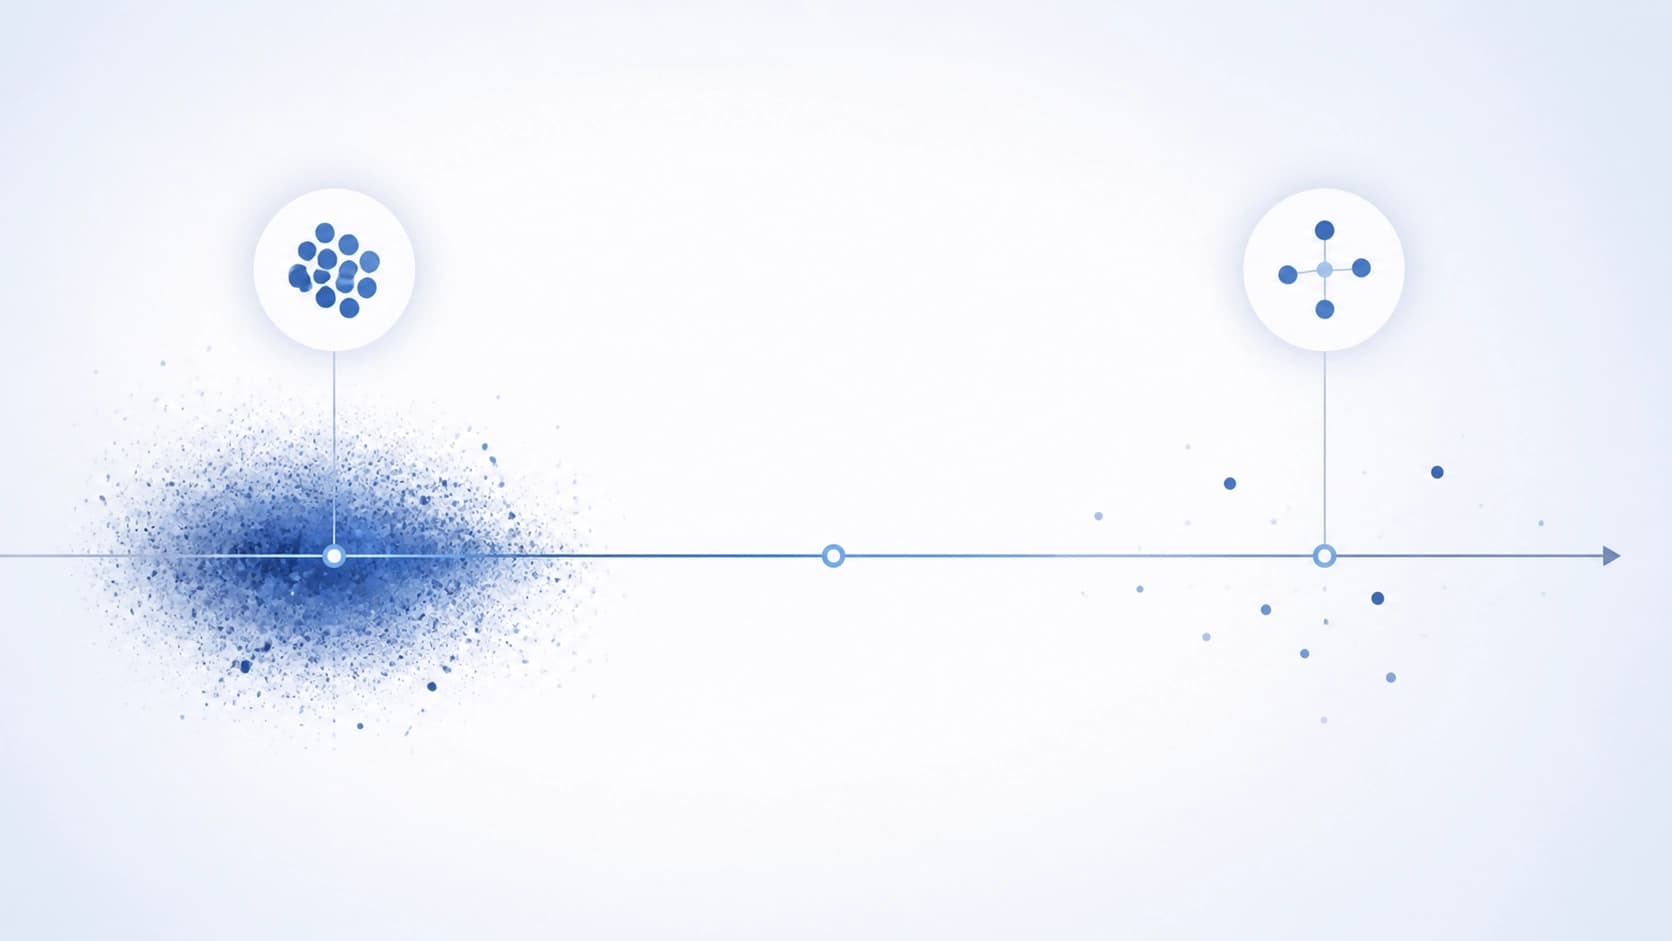
প্রতিফলনের সিদ্ধান্ত যদি অ্যাক্টিভেশনে থাকে, তবে তা সরাসরি প্রভাবিত করা যায় — প্রম্পট পুনরায় না লিখে, রিপ্রেজেন্টেশনে হস্তক্ষেপ করে। এর উপরই দাঁড়িয়ে আছে ReflCtrl: একটি ফ্রেমওয়ার্ক, যা স্টিয়ারিংয়ের মাধ্যমে আত্মপ্রতিফলন নিয়ন্ত্রণ করে — খুঁজে পাওয়া দিক বরাবর অ্যাক্টিভেশন সরিয়ে দেওয়া।
মূল সূক্ষ্ম দিকটি — কখন হস্তক্ষেপ করতে হবে
সহজ পদ্ধতিটি স্পষ্ট: প্রতিটি জেনারেট করা টোকেনে প্রয়োজনীয় সরিয়ে দেওয়া যোগ করা। এটিই প্রথম মাথায় আসে — এবং এটিই খারাপভাবে কাজ করে। রিপ্রেজেন্টেশনের উপর অবিরাম চাপ জেনারেশনের মান ক্ষয়ে দেয়: মডেল সংগতি হারায়, কারণ হস্তক্ষেপ সেখানেও যায় যেখানে তা অর্থহীন।
লেখকরা প্রস্তাব করেন ধাপ-ভিত্তিক (step-level) একটি রূপ। হস্তক্ষেপ প্রয়োগ করা হয় ঠিক একবার — প্রতিটি নতুন চিন্তার ধাপের একেবারে শুরুতে। এরপর মডেল নির্দ্বিধায়, বাধা ছাড়াই সেই ধাপের টোকেনগুলো জেনারেট করে। ফলে হয় সূক্ষ্ম নিয়ন্ত্রণ: প্রতিফলনের হার বদলায়, কিন্তু ধাপের ভেতরের চিন্তাধারা অপরিবর্তিত থাকে।
এই সমন্বয়টিই — অবিরামের বদলে বিরল, সুনির্দিষ্ট হস্তক্ষেপ — মূল লাভ দেয়।
পরীক্ষা-নিরীক্ষা কী দেখাল
পরীক্ষাগুলো চালানো হয়েছিল গাণিতিক ও সাধারণ চিন্তার বেঞ্চমার্কে। ফলাফলগুলো শিল্পের জন্য বরং অস্বস্তিকর একটি সিদ্ধান্তে পৌঁছে দেয়: প্রতিফলন প্রায়ই অতিরিক্ত।
- চিন্তার টোকেনের সংখ্যা মূল আয়তনের ৪৩.২% পর্যন্ত কমিয়ে আনা সম্ভব — নির্ভুলতা অক্ষুণ্ন রেখে।
- প্রভাব বিশেষভাবে লক্ষণীয় আরও শক্তিশালী মডেলে: মডেল যত ভালো, সে তত বেশি অকারণে নিজেকে যাচাই করে।
- তুলনীয় টোকেন বাজেটে ধাপ-ভিত্তিক স্টিয়ারিং প্রচলিত প্রতি-ট্যাক্টের চেয়ে স্পষ্টভাবে এগিয়ে।
দ্বিতীয় ও তৃতীয় বিন্দু পরস্পর সম্পর্কিত। শক্তিশালী মডেল তার ধাপ নিয়ে বেশি আত্মবিশ্বাসী, তাই তার প্রতিফলন প্রায়ই বৃথা চেষ্টা হয়ে দাঁড়ায় — আর প্রতি-ট্যাক্ট স্টিয়ারিং ঠিক এই কারণেই ক্ষতিগ্রস্ত হয় যে তা সময়মতো থামতে জানে না।
গবেষণাগারের বাইরে কেন এটি গুরুত্বপূর্ণ
চিন্তার অর্থনীতি কোনো বিমূর্ত বিষয় নয়। দীর্ঘ শৃঙ্খল ইনফারেন্সের বিল ফুলিয়ে তোলে, বিলম্ব বাড়ায় এবং বিদ্যমান হার্ডওয়্যারে কতগুলো অনুরোধ আদৌ পাঠানো যাবে তা সীমিত করে। যদি গুণমান না হারিয়ে "চিন্তার" প্রায় অর্ধেক সরিয়ে ফেলা যায়, তবে তা স্কেলে সরাসরি সাশ্রয়।
আরও একটি কম স্পষ্ট স্তরও আছে। কাজটি দেখায়, মডেলের আচরণ রিপ্রেজেন্টেশনের স্তরে নিয়ন্ত্রণ করা যায় — প্রম্পটের চেয়ে কোমল ও নির্ভুলভাবে, এবং ফাইন-টিউনিংয়ের চেয়ে সস্তায়। নিয়ন্ত্রণযোগ্যতা একটি আলাদা প্রকৌশল মাত্রা হয়ে ওঠে: "নির্দেশনায় কী লিখব" নয়, বরং "অ্যাক্টিভেশন কোথায় সরাব এবং কোন মুহূর্তে"।
সবশেষে, এটি ব্যাখ্যাযোগ্যতার ক্ষেত্রে একটি অবদান। মডেল যখন থেমে নিজেকে বলে "চলো আবার দেখি", তখন ভেতরে আসলে কী ঘটে — তা আমরা ক্রমশ ভালো বুঝতে পারছি।
খোলা প্রশ্ন
প্রয়োগের সীমারেখা এখনো পুরোপুরি চিহ্নিত নয়। একটি দিক বরাবর স্টিয়ারিং একটি সংকীর্ণ যন্ত্র: এটি খুঁজে পাওয়া প্রতিফলনের অক্ষটি ভালোভাবে ধরে, কিন্তু স্ব-সংশোধনের অন্য ধরনগুলোর কী হবে — তা স্পষ্ট নয়। আরও একটি প্রশ্ন থেকে যায়, খুঁজে পাওয়া দিকটি আর্কিটেকচারের মধ্যে কতটা স্থানান্তরযোগ্য: প্রতিটি মডেলের নিজস্ব রিপ্রেজেন্টেশন, এবং একটির জন্য কাজ করা ভেক্টর অন্যটির কাজে লাগবে — তা নিশ্চিত নয়।
সাশ্রয় ও নির্ভরযোগ্যতার মধ্যে সমঝোতাও পুরোপুরি স্পষ্ট নয়, বিশেষত এমন কাজে যেখানে ভুলের মূল্য চড়া। গড় নির্ভুলতা অক্ষুণ্ন রেখে ৪৩.২% টোকেন কমানো একটি শক্তিশালী ফলাফল, কিন্তু গড় নির্ভুলতা মানে বিরল বিপর্যয়কর ব্যর্থতার অনুপস্থিতি নয়। "অতিরিক্ত" প্রতিফলন থেকে সেই একমাত্র প্রতিফলনকে আলাদা করা, যা উত্তর বাঁচায় — সম্ভবত এই গবেষণাধারার পরবর্তী কাজ।


