কেন এজেন্টিক RAG একটি দ্বিধাবিভক্তিতে আটকে যায়
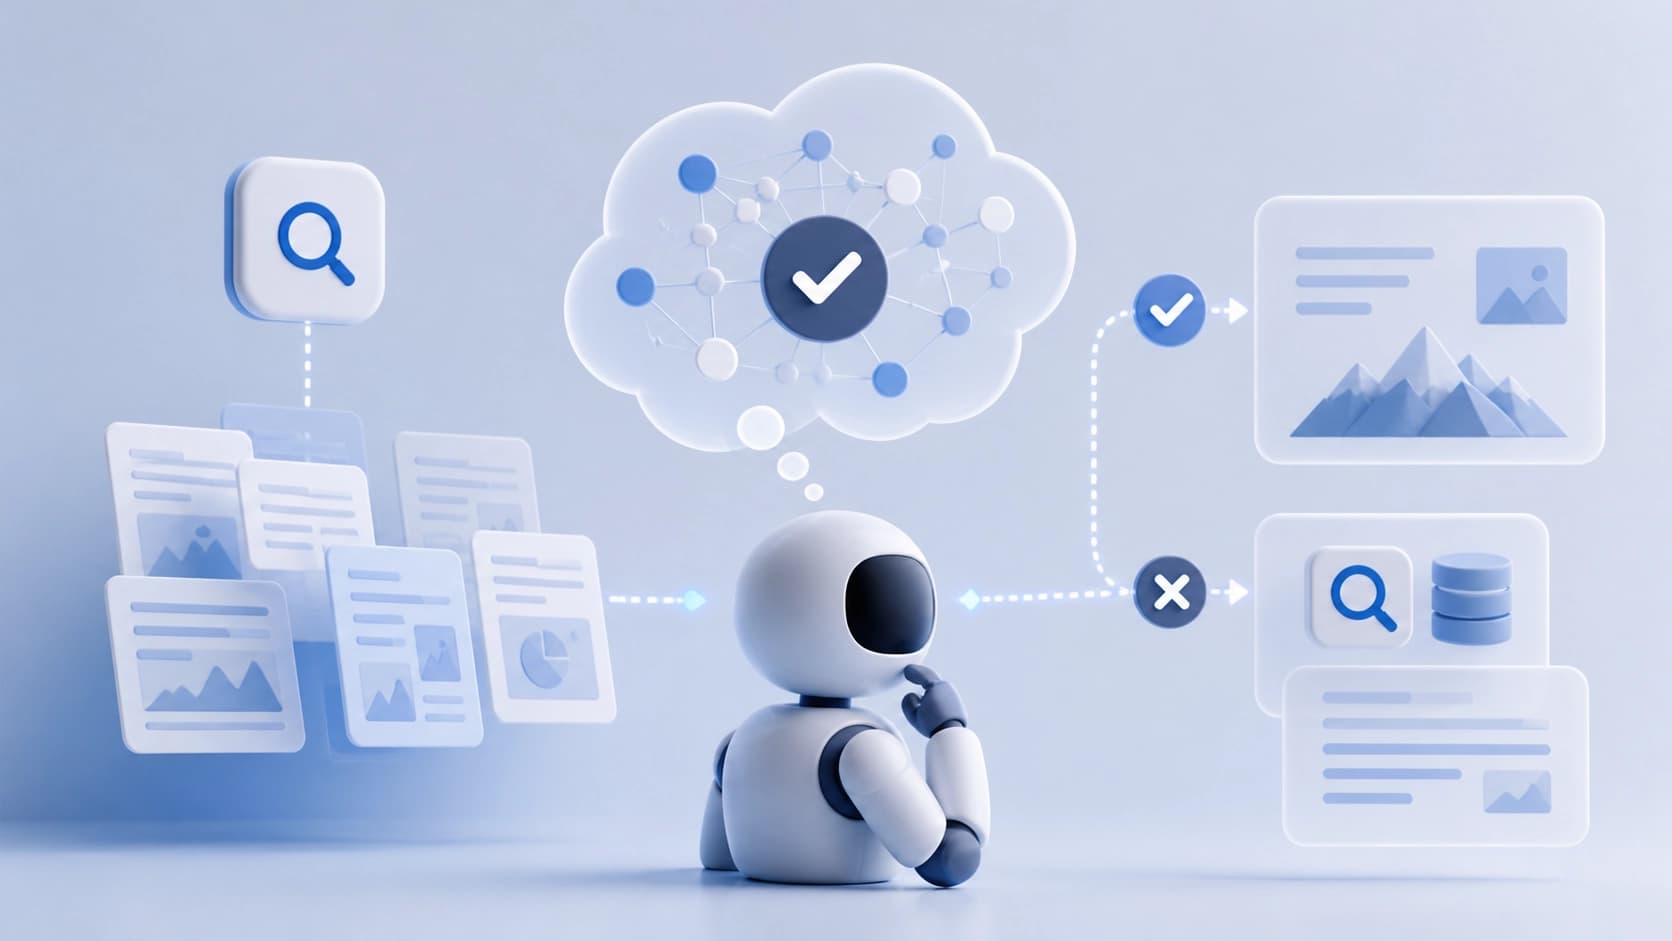
এজেন্টিক RAG একটি চক্র হিসেবে সাজানো: মডেল প্রশ্ন পড়ে, সিদ্ধান্ত নেয় আরেকটি সার্চ কোয়েরি দরকার কি না, ফলাফল পায় এবং আবার বেছে নেয় — আরও খুঁজবে নাকি উত্তর দেবে। প্রতিটি অতিরিক্ত পুনরাবৃত্তি টাকা ও সময় খরচ করে, প্রতিটি বাদ দেওয়া পুনরাবৃত্তি অসম্পূর্ণ উত্তরের ঝুঁকি তৈরি করে। ফলে দেখা যায়, এজেন্টের মূল দক্ষতা ডকুমেন্ট বের করা নয়, বরং সময়মতো বলা — "প্রমাণ যথেষ্ট"।
ক্লাসিক রিইনফোর্সমেন্ট লার্নিং এমন আচরণকে বাইরে থেকে মূল্যায়ন করে: উত্তর রেফারেন্সের সঙ্গে মিললে প্লাস, না মিললে মাইনাস। সংগৃহীত তথ্যের সম্পূর্ণতা নিয়ে মডেল নিজে কী ভাবে, তা কেউ জিজ্ঞেস করে না। এখান থেকেই দুটি প্রতিসম রোগের জন্ম: পলিসি হয় তখনও খুঁড়তে থাকে যখন ভেতরে সব পরিষ্কার, নয়তো সার্চ থামিয়ে দেয় যদিও ডেটা স্পষ্টতই কম। বাহ্যিক পুরস্কার এই পরিস্থিতিগুলো আলাদা করতে পারে না — ফলাফল একই, কিন্তু আচরণ ভিন্ন।
সমস্যা উপস্থাপনের পরিবর্তন
MetaRAG গবেষণাপত্রের লেখকেরা শুধু কর্ম নয়, বরং প্রমাণের পর্যাপ্ততা নিয়ে এজেন্টের অভ্যন্তরীণ বিশ্বাসের সঙ্গে সেই কর্ম কতটা মেলে, সেদিকেও তাকানোর প্রস্তাব দেন। এই উপস্থাপনাকে তারা বলেন বিশ্বাস-কর্ম সমন্বয় — belief-action alignment। ভাবনাটি সরল: সার্চের সিদ্ধান্তের গুণমান উত্তর之上的 আলাদা কোনো মেট্রিক নয়, বরং মডেল যা "ভাবছে" এবং যা করছে তার মধ্যে সমন্বয়।
MetaRAG কীভাবে সাজানো
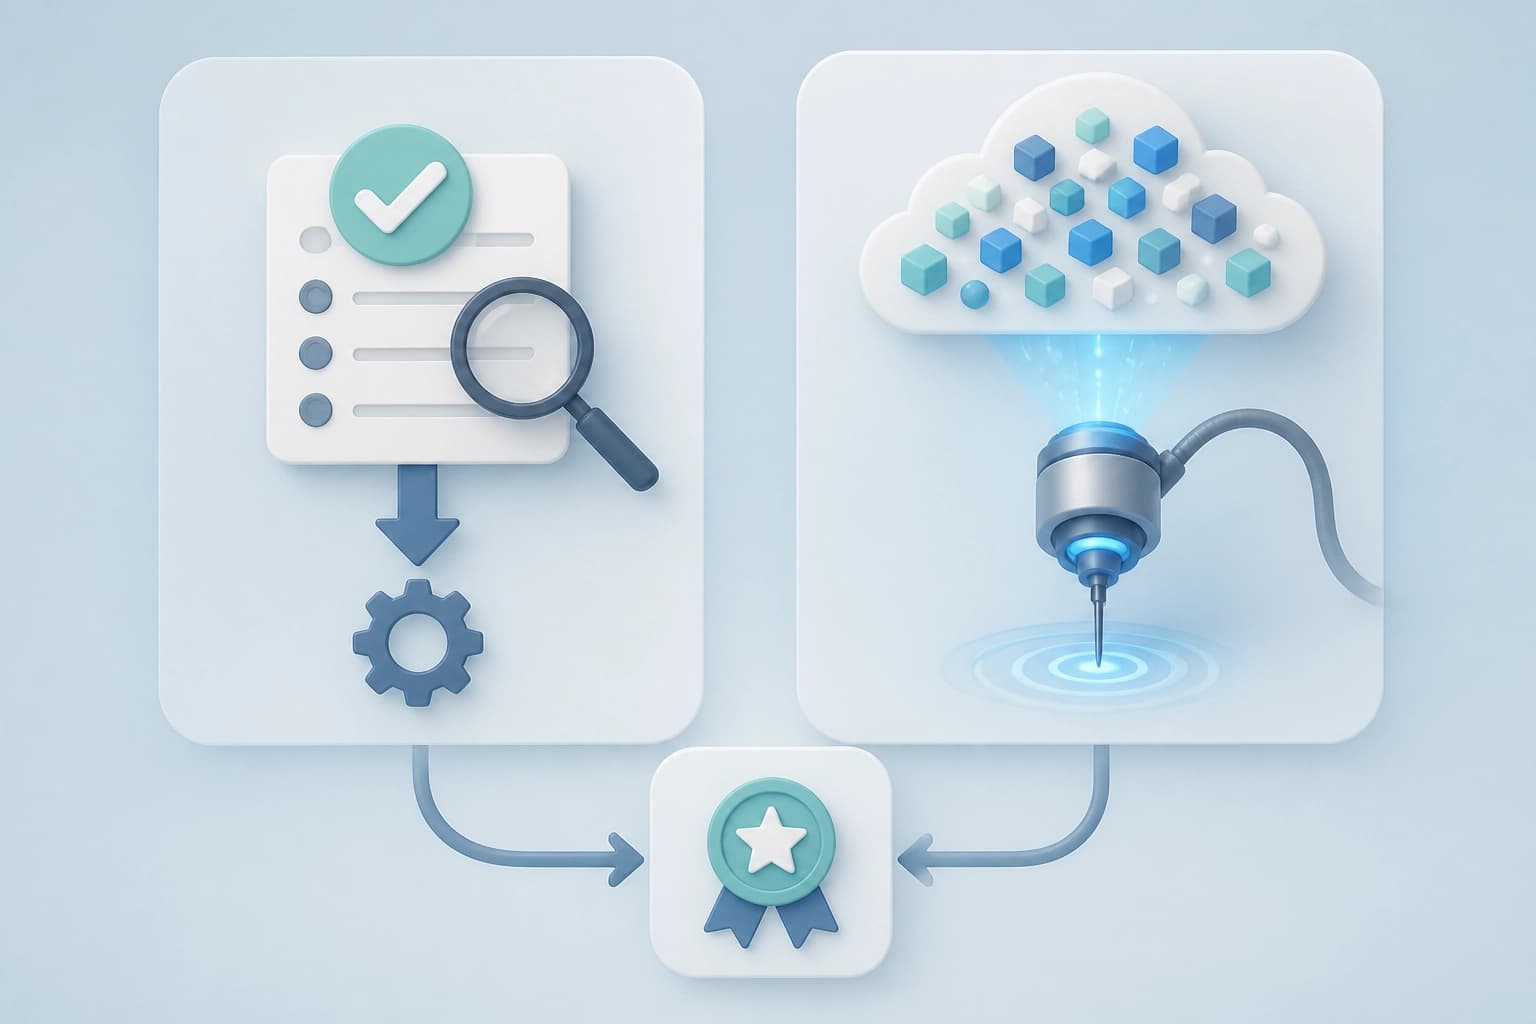
ফ্রেমওয়ার্কটি তিনটি অংশে গঠিত: কর্মের আগে স্পষ্ট যাচাই, অভ্যন্তরীণ বিশ্বাসের প্রোব এবং একটি বিশেষ পুরস্কার, যা একটিকে অন্যটির সঙ্গে যুক্ত করে।
কর্মের আগে যাচাই
প্রথম উপাদান — Verify-first Action Generation। পরবর্তী ধাপ সরাসরি দিয়ে দেওয়ার বদলে পলিসি প্রথমে সেটিকে একটি স্পষ্ট যাচাই প্রক্রিয়ার মধ্য দিয়ে চালায়: এই কর্ম বর্তমান সার্চ অবস্থার সঙ্গে মানানসই কি না। উদ্দেশ্য হলো আবেগপ্রবণ সিদ্ধান্তগুলো ট্রাজেক্টরিতে ঢোকার আগেই ছেঁকে ফেলা। মূলত এটি জেনারেশনে অন্তর্ভুক্ত একটি "স্টপ-ফ্রেম", যা দ্রুত এজেন্টদের সাধারণত অভাব হয়।
অভ্যন্তরীণ বিশ্বাসের প্রোব
দ্বিতীয় উপাদান — Internal Belief Probing। পলিসি যে কনটেক্সট দেখে (প্রশ্ন প্লাস কর্ম ও পর্যবেক্ষণের ইতিহাস), সেখান থেকেই আলাদাভাবে তার নিজের মত পড়া হয়: এখনই প্রশ্নের উত্তর দেওয়া যাচ্ছে কি না। গুরুত্বপূর্ণ হলো, এটি কোনো বাহ্যিক বিচারক-মডেল বা মানুষের অ্যানোটেশন নয় — সংকেতটি একই পলিসি থেকে নেওয়া, শুধু ভিন্নভাবে জিজ্ঞাসা করা।
সেফগার্ডসহ সমন্বয়ের পুরস্কার
এই দুটি সংকেত থেকে consistency reward বের করা হয়: এজেন্ট পুরস্কৃত হয় যখন তার কর্ম প্রমাণের পর্যাপ্ততা নিয়ে অভ্যন্তরীণ মূল্যায়নের সঙ্গে মেলে। এখানে একটি স্পষ্ট ফাঁদ আছে — যদি মডেল সুসংগতভাবে ও ধারাবাহিকভাবে ভুল করে, তবে "আত্মবিশ্বাসী ভুল" আচরণকে পুরস্কৃত করা শুরু হতে পারে। লেখকেরা একটি গেট দিয়ে এটি বন্ধ করেন: সমন্বয়ের পুরস্কার কেবল তখনই গণনা করা হয় যখন উত্তর সঠিক হয়েছে। অন্য কথায়, সমন্বয় নিজে লক্ষ্য নয়, বরং সঠিকতার একটি গুণক।
প্র্যাকটিশনারদের জন্য গুরুত্বপূর্ণ একটি আলাদা খুঁটিনাটি: বিশ্বাসের প্রোব কেবল প্রশিক্ষণের পর্যায়ে থাকে। ইনফারেন্সে এটি ডাকা হয় না, তাই প্রতিটি অনুরোধে অতিরিক্ত গণনা হয় না — ওভারহেড শূন্যই থাকে।
পরীক্ষা-নিরীক্ষা কী দেখাল
সাতটি পাবলিক প্রশ্নোত্তর বেঞ্চমার্কে কাজটি যাচাই করা হয়েছে। দাবিকৃত ফলাফল হলো এজেন্টিক RAG-এর জন্য শক্তিশালী RL-ভিত্তিক পদ্ধতিগুলোর তুলনায় নির্ভুলতা ও দক্ষতার মধ্যে সমঝোতায় ধারাবাহিক উন্নতি। অর্থাৎ লাভ শুধু আরও নির্ভুল উত্তর দেওয়ায় নয়, বরং তার জন্য অন্তহীন সার্চের দাম না দেওয়ায়।
এরপর লেখকেরা যাচাই করেন ফলাফল কতটা স্থানান্তরযোগ্য: ডিপ রিসার্চ পরিস্থিতিতে, বিভিন্ন অপটিমাইজারে এবং বিভিন্ন বেস মডেলে। তাদের তথ্য অনুযায়ী, এই সব কনফিগারেশনেই পদ্ধতিটি সুবিধা ধরে রাখে। এটিই সেই ধরনের যাচাই, যার অভাব প্রায়ই থাকে: একটি মডেল ও একটি ডেটাসেটে উন্নতিকে সহজেই হাইপারপ্যারামিটারের সফল টিউনিংয়ের সঙ্গে গুলিয়ে ফেলা যায়।
বাস্তবে এর অর্থ কী
এজেন্টিক সার্চ সিস্টেমের ডেভেলপারদের জন্য MetaRAG এমন একটি দিক দেখায়, যা ভাবনার চেয়ে কম খরচের। যদি আপনার ইতিমধ্যে পলিসি প্রশিক্ষণ থাকে, তবে অভ্যন্তরীণ বিশ্বাসের সংকেত যোগ করতে নতুন অ্যানোটেটরের দরকার নেই: পলিসি যে কনটেক্সট ইতিমধ্যে দেখছে, সেটিকেই সংকেতের উৎস হিসেবে ব্যবহার করা যায়। তবে সঠিকতার গেট অবশ্যই থাকতে হবে — এটি ছাড়া এজেন্ট সুন্দরভাবে ও আত্মবিশ্বাসের সঙ্গে ভুল করা শিখে যেতে পারে।
দ্বিতীয় উপসংহারটি সামগ্রিকভাবে পুরস্কার ডিজাইন নিয়ে। বাহ্যিক মেট্রিক্স "হয়েছে কি" প্রশ্নের উত্তর দেয়, কিন্তু "এজেন্ট সেই মুহূর্তে যথাযথ ছিল কি" নিয়ে প্রায় কিছুই বলে না। এই দুটির পার্থক্য করাই প্রবন্ধের মূল ভাবনা: বিশ্বাস ও কর্মের মধ্যে সমন্বয় একটি স্বতন্ত্র, আলাদাভাবে অপটিমাইজযোগ্য বস্তু, নির্ভুলতা বৃদ্ধির পার্শ্বপ্রতিক্রিয়া নয়।
তবে সীমাবদ্ধতাগুলো মনে রাখা উচিত: পরীক্ষা-নিরীক্ষা QA বেঞ্চমার্ক ও ডিপ রিসার্চ পরিস্থিতিতে সীমিত, আর পদ্ধতিটি নিজেই RL প্রশিক্ষণের উপরে বসানো, অর্থাৎ যেসব সিস্টেমে পলিসি একেবারেই প্রশিক্ষিত হয় না, সেখানে "আউট অব দ্য বক্স" প্রযোজ্য নয়। এমন ক্ষেত্রে ভাবনাটিই বেশি কাজে লাগে — কর্ম সম্পাদনের আগে স্পষ্টভাবে যাচাই করা এবং সিদ্ধান্তটি ডেটার পর্যাপ্ততা নিয়ে অভ্যন্তরীণ অনুভূতির সঙ্গে মেলে কি না তা আলাদাভাবে মূল্যায়ন করা।
সম্পূর্ণ পাঠ্য arXiv:2608.24214 (v1, ২৫ আগস্ট ২০২৬, cs.AI বিভাগ) হিসেবে পাওয়া যায় — কাজটি EMNLP 2026 সম্মেলনের মূল প্রোগ্রামে গৃহীত হয়েছে।