স্কেলার গুণফল: একটি সংকীর্ণ বাধা
প্রায় সব আধুনিক অ্যাটেনশন আর্কিটেকচার একইভাবে গঠিত: কোয়েরি ও কী-কে স্কেলার গুণফলের (বা তার স্বাভাবিকীকৃত সংস্করণের) মাধ্যমে মিলিয়ে নেওয়া হয়, ফলাফলকে ওজনে রূপান্তরিত করা হয়, আর আউটপুট তৈরি হয় ভ্যালুগুলোর ওজনযুক্ত যোগফল হিসেবে। পদ্ধতিটি সর্বজনীন, তবে এর একটি মূল্য আছে — এই কাঠামোয় ফিচার স্পেসের জ্যামিতি কঠোরভাবে নির্ধারিত: সাদৃশ্য পরিমাপ করা হয় "সোজা পথে", এটা বিবেচনা না করেই যে স্পেসের বিভিন্ন দিকের গুরুত্ব ও স্কেল ভিন্ন হতে পারে।
ঠিক এই সীমাবদ্ধতাকেই লক্ষ্য করে arXiv:2608.24462 «Mahalanobis-Based Multi-Head Attention for Complex State Propagation» (লেখক — Xiaohe Li; বিভাগ cs.AI)। প্রচলিত গুণফলের বদলে এতে ব্যবহৃত হয় মাহালানোবিস দূরত্বের উপর নির্মিত RBF কার্নেল। সহজ কথায়, সিকোয়েন্সের উপাদানগুলোর মধ্যে সাদৃশ্য "সরাসরি" নয়, বরং ডেটার কোভারিয়েন্স কাঠামোর সমন্বয়সহ গণনা করা হয় — যেন তুলনার আগে স্পেসটিকে একটু প্রসারিত ও ঘুরিয়ে নেওয়া হয়েছে, যাতে পারস্পরিক সম্পর্কযুক্ত দিকগুলোকে স্বাধীন হিসেবে গণ্য না করা হয়।
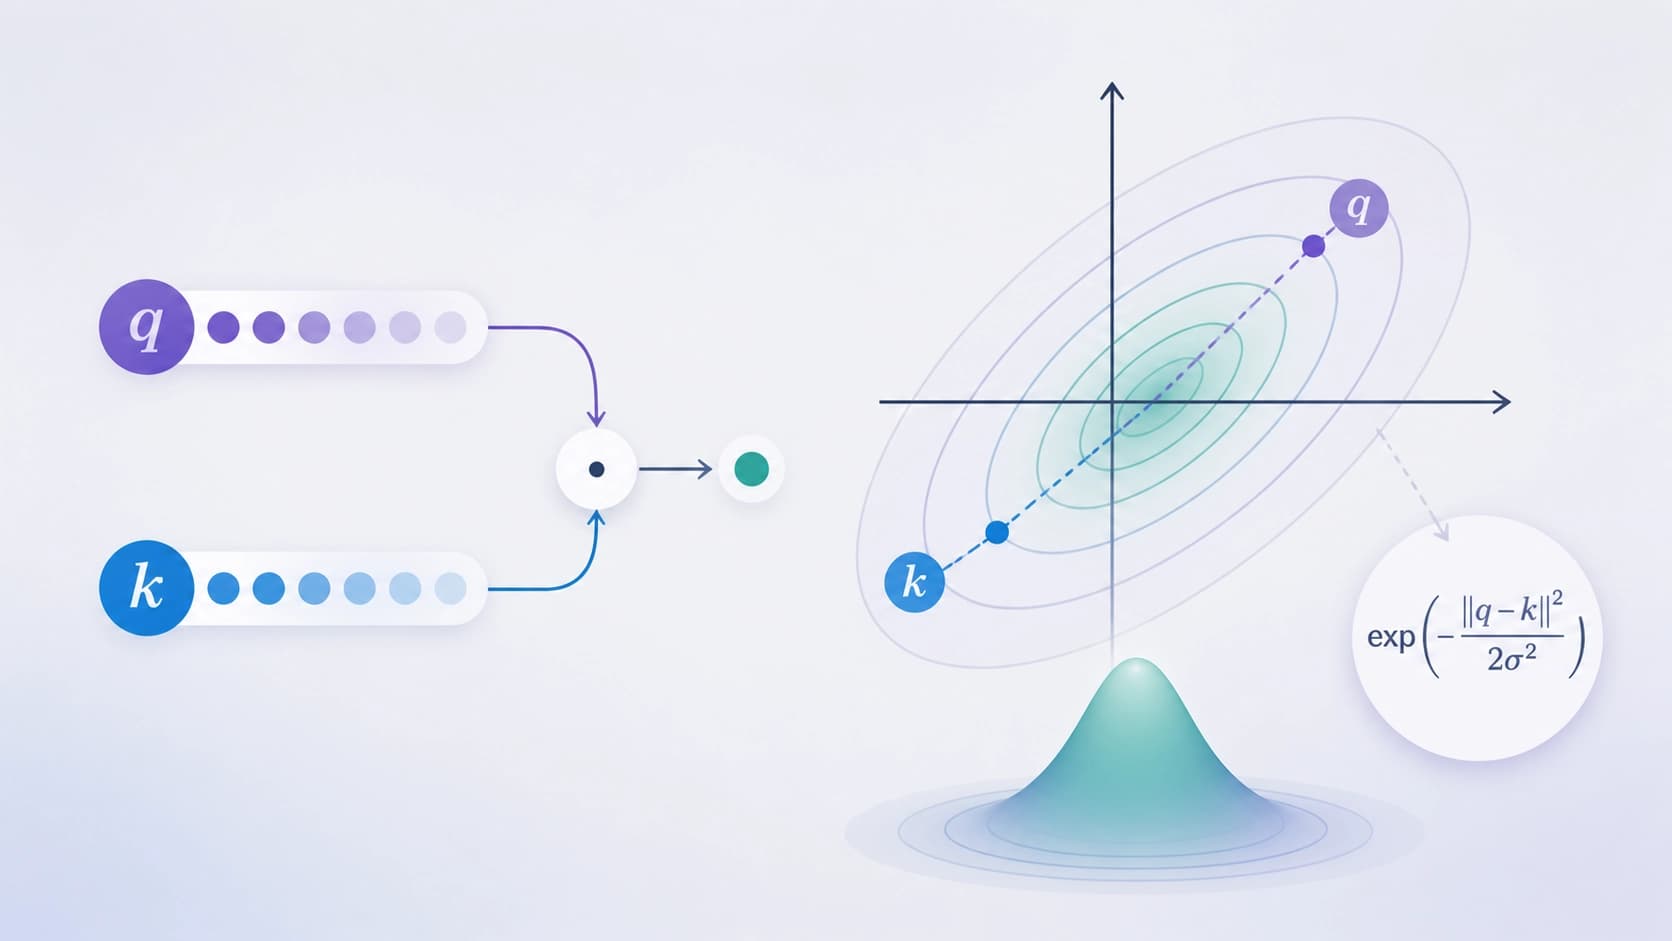
মাহালানোবিস দূরত্ব কী দেয়
প্যারামিটার বৃদ্ধি ছাড়াই অসীম-মাত্রিক স্পেসে অ্যাটেনশন
লেখকের মূল দাবি: মাহালানোবিস দূরত্বের উপর RBF কার্নেল অ্যাটেনশন এমনভাবে গণনা করতে দেয় যেন তা একটি অসীম-মাত্রিক ফিচার স্পেসে অবস্থান করছে, কিন্তু একইসাথে শেখার প্যারামিটারের সংখ্যা বাড়ে না। এটি কোনো জাদু নয়, বরং এর ফল যে কার্নেল নিজেই একটি অরৈখিক ম্যাপিং নির্ধারণ করে — ফিচার উন্মোচনের জন্য আলাদা স্তরের প্রয়োজন নেই। বাস্তব ক্ষেত্রে এর অর্থ হলো মেমরি ও অপ্টিমাইজেশনের তুলনামূলক কম চাহিদা, যা বিশাল মডেলের যুগে প্রায় চোখে পড়ার মতো ব্যতিক্রম।
ধনাত্মক নির্দিষ্টতা ও Tree Attention
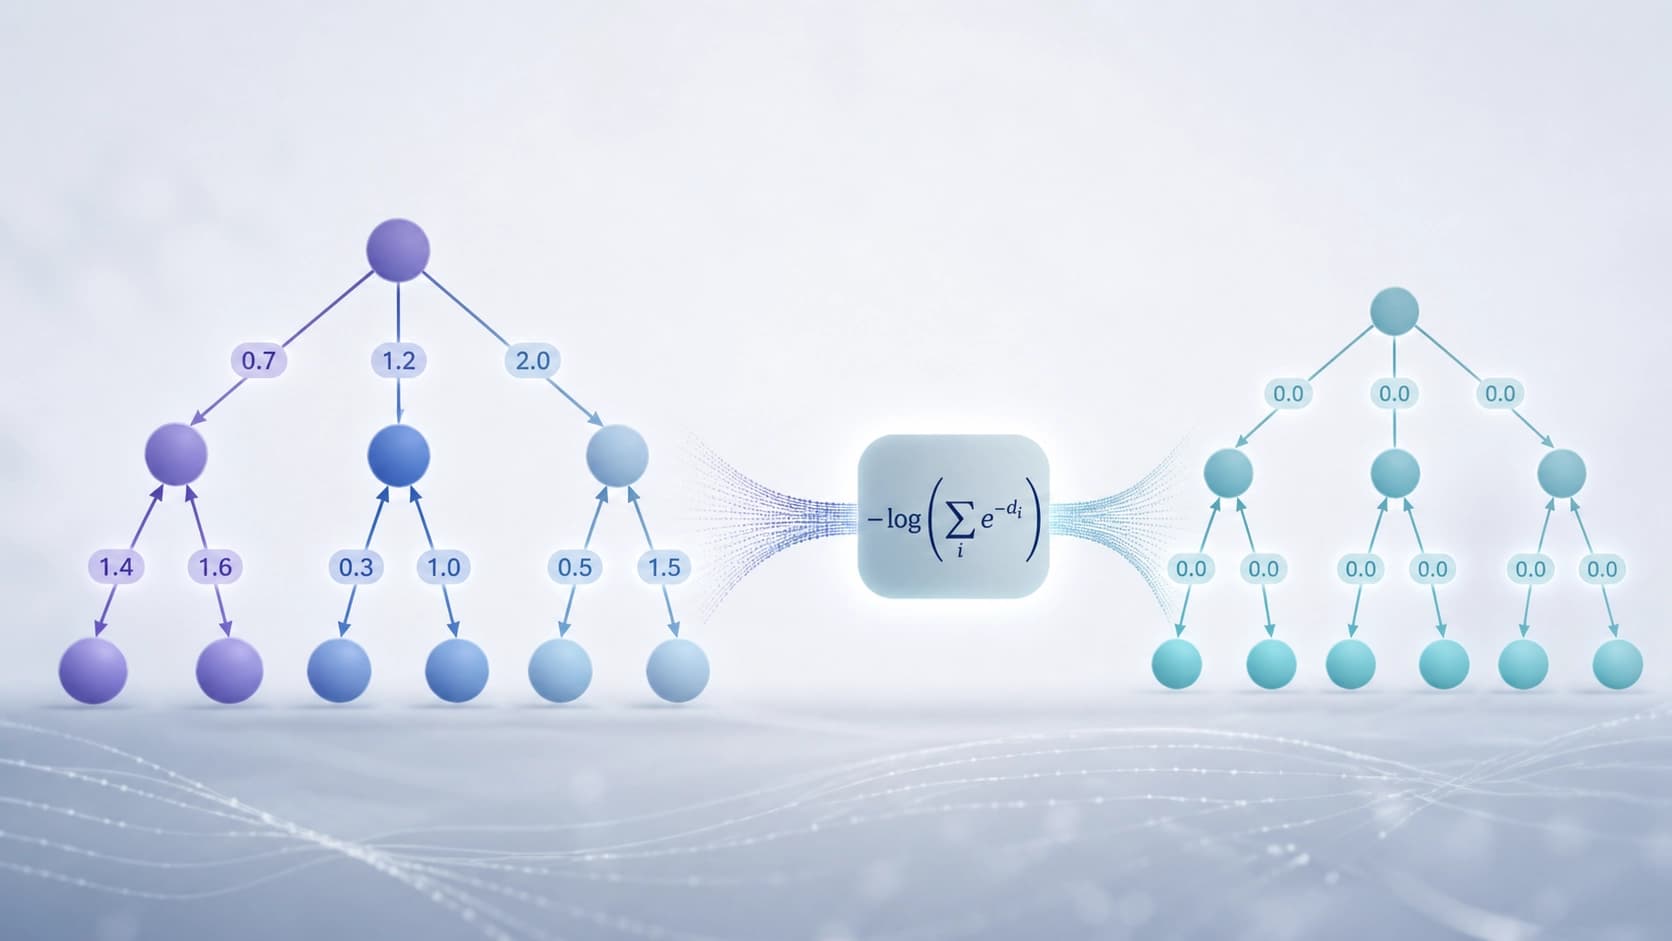
ধারণার দ্বিতীয় স্তরটি মাহালানোবিস দূরত্বের একটি গাণিতিক বৈশিষ্ট্যের উপর নির্ভর করে: এটি ধনাত্মক নির্দিষ্ট (positive definite)। এ থেকে সরাসরি তা নির্মাণ করা যায় যা নিবন্ধে Tree Attention নামে অভিহিত — অ্যাটেনশন স্কোরগুলো "কাঁচা" সাদৃশ্য থেকে নয়, বরং বৃক্ষ বরাবর সঞ্চিত দূরত্ব থেকে গঠিত হয়। এই ধরনের সঞ্চয়ন যাতে সংখ্যাগতভাবে বিচ্যুত না হয়, সেজন্য LogSumExp-এর মাধ্যমে সংশোধন প্রয়োগ করা হয়: দূরত্ব থেকে প্রান্তগুলো বরাবর সূচকের যোগফলের লগারিদম বিয়োগ করা হয়। মূলত এটি বৃক্ষের বিভিন্ন পথের অবদানগুলোকে তাদের আপেক্ষিক ওজন না হারিয়ে সমন্বয় করার একটি উপায়।
বিস্তারিত না জানা পাঠকের জন্য একটি কাজের উপমা এমন: "সাদৃশ্য"গুলোকে যেমন-তেমনভাবে যোগ করার বদলে, মডেল কাঠামোর গভীরে অগ্রসর হওয়ার সাথে সাথে সেগুলোকে সযত্নে স্বাভাবিকীকরণ করে। এটি অন্তর্দৃষ্টির চেয়ে হিসাবরক্ষণের কাছাকাছি — কিন্তু ঠিক এই সযত্নতাই দীর্ঘ নির্ভরতা-শৃঙ্খলে যুক্তিকে স্থিতিশীল রাখতে দেয়।
Attention meshing: হেডগুলো একে অপরের সাথে কথা বলতে শুরু করে
সাধারণত মাল্টি-হেড অ্যাটেনশন প্রায় স্বাধীন বিশেষজ্ঞদের একটি সেট হিসেবে গঠিত: প্রতিটি হেড নিজের হিসাব করে, আর মিশ্রণ ঘটে কেবল আউটপুটে, একটি রৈখিক প্রক্ষেপণের মাধ্যমে। MHA-CSP-তে মাহালানোবিস দূরত্বের ম্যাট্রিক্সগুলো পুনঃপুনঃ ব্যবহার করা হয় — সেগুলোর ভিত্তিতে গড়ে ওঠে "attention meshing" প্রক্রিয়া, যা বিভিন্ন হেডের কার্নেলগুলোকে সরাসরি পারস্পরিক ক্রিয়ায় বাধ্য করে। লেখক দ্বিমুখী সুবিধার কথা জানান: নির্ভুলতাও বেশি, আর প্রশিক্ষণও বেশি দক্ষতার সাথে চলে, কারণ একই গণনামূলক কাজ পুনরাবৃত্তি করা হয় না।
পরীক্ষা-নিরীক্ষা: ১১৯ হাজার প্যারামিটার বনাম বড় বেসলাইন মডেল
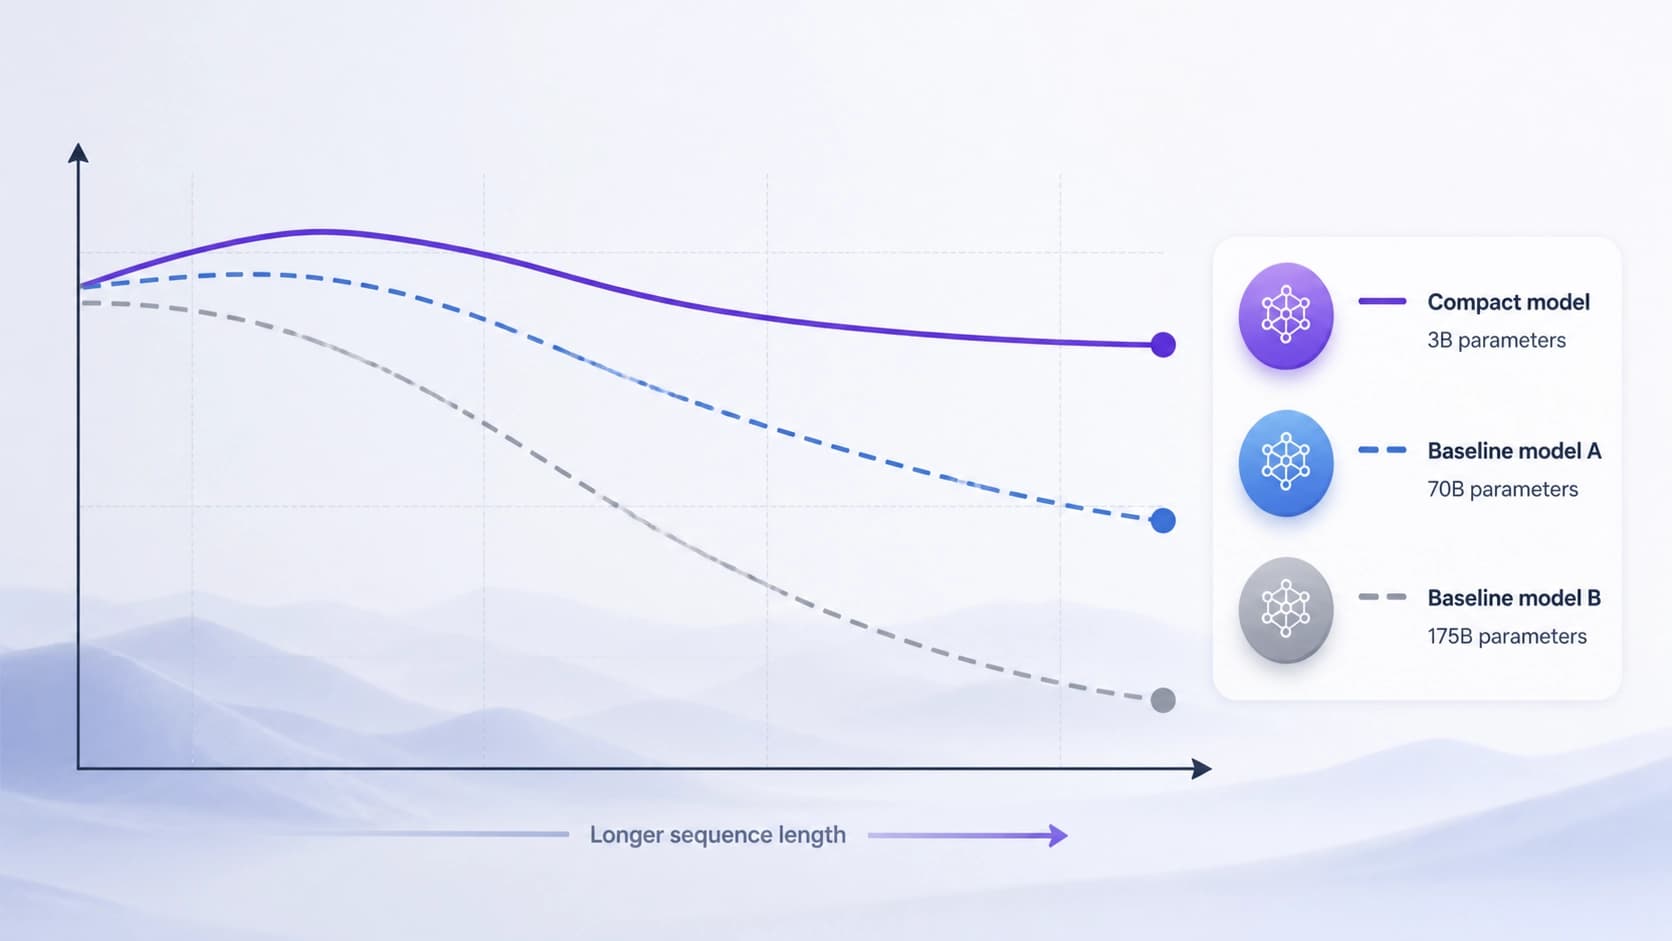
কাজটির সবচেয়ে আলোচিত অংশ হলো তুলনা। মাত্র ১১৯ হাজার প্যারামিটারের MHA-CSP-কে তুলনা করা হয়েছে বেসলাইন ট্রান্সফরমার ও গ্রাফ কনভলিউশনাল নেটওয়ার্কের সাথে, যেগুলো অভিন্ন পরিস্থিতিতে শূন্য থেকে প্রশিক্ষিত। কাজটি হলো দীর্ঘ সিকোয়েন্সে অবস্থা ট্র্যাকিং। তাছাড়া teacher forcing প্রয়োগ করা হয়েছিল কেবল চূড়ান্ত লুকানো অবস্থায়, অর্থাৎ মডেল প্রতিটি ধাপে সূত্র পায়নি, যেমনটি প্রায়ই বেশি শিক্ষণীয় প্রশিক্ষণে করা হয়।
লেখকের দাবি অনুযায়ী, MHA-CSP ধারাবাহিকভাবে প্রতিযোগীদের ছাড়িয়ে যায়। বেসলাইন মডেলগুলো এখানে হয় ঘন অ্যাটেনশনের (ট্রান্সফরমার) উপর, নয়তো গ্রাফ বরাবর তথ্য বিস্তারের (GCN) উপর নির্ভর করে, অথচ MHA-CSP কাঠামোবদ্ধ যুক্তি অর্জন করে দূরত্বের সিন্থেটিক সংশোধন এবং backbone CSP থেকে উত্তরাধিকারসূত্রে পাওয়া মিতব্যয়ী তথ্য-পরিভ্রমণের মাধ্যমে।
জোর দেওয়া উচিত: বিষয়টি এই নয় যে ছোট মডেল সবকিছুতে বড় মডেলকে "ধরে ফেলছে"। বিষয়টি নির্দিষ্ট একটি শ্রেণির কাজ — অভ্যন্তরীণ প্রতীকী কাঠামোসহ দীর্ঘ সিকোয়েন্স, যেখানে কেবল প্রসঙ্গ মনে রাখাই নয়, তার অবস্থা ধরে রাখাও গুরুত্বপূর্ণ। ঠিক সেখানেই দূরত্বের জ্যামিতি ও বৃক্ষ-ভিত্তিক স্বাভাবিকীকরণ কাজ করতে শুরু করে।
বাস্তবে এটি কী বদলায়
কাজটির মূল সিদ্ধান্ত এভাবে প্রণীত: জটিল-মানবিশিষ্ট অবস্থা বিস্তার (complex-valued state propagation), সম্মিলিত মাল্টি-হেড সংশোধনের সাথে মিলিত হয়ে প্রতীকী কাঠামো ধরার জন্য একটি কার্যকর হাতিয়ার হিসেবে প্রমাণিত হয়। আর এটি কাঠামোবদ্ধ যুক্তির কাজে দক্ষতা ও গুণমানের মধ্যে একটি নতুন ভারসাম্য নির্ধারণ করে।
বৃহত্তর দৃষ্টিতে দেখলে, এখানে সাম্প্রতিক বছরের একটি প্রবণতা লক্ষ্য করা যায়: প্যারামিটার বাড়ানোর বদলে গবেষকরা আরও উপযুক্ত ইন্ডাকটিভ বায়াস খুঁজছেন — অর্থাৎ ডেটার প্রকৃতি সম্পর্কে সঠিক অনুমান আর্কিটেকচারে গেঁথে দিচ্ছেন। স্কেলার গুণফল সুবিধাজনক ছিল, কিন্তু বরং অমসৃণ একটি অনুমান। এটিকে কোভারিয়েন্স মেট্রিকসহ একটি কার্নেল দিয়ে প্রতিস্থাপন করা হলো মডেলকে বলার একটি চেষ্টা: "স্পেসের সব দিক সমান নয়, এটি শুরু থেকেই বিবেচনায় রাখো"।
বাইরে থেকে সতর্ক দৃষ্টি
পাইপলাইন নতুন করে লেখার তাড়াহুড়ো করার কারণ নেই। প্রথমত, ফলাফলগুলো অবস্থা ট্র্যাকিংয়ের একটি নির্দিষ্ট সেট কাজে পাওয়া; আলাদা যাচাই ছাড়া এগুলো টেক্সট জেনারেশন, মাল্টিমোডালিটি বা সংলাপভিত্তিক পরিস্থিতিতে প্রয়োগ করা উচিত নয় — অ্যাবস্ট্রাক্টে এমন পরীক্ষা নেই। দ্বিতীয়ত, একক লেখক এবং প্রিপ্রিন্টের প্রথম সংস্করণ (v1, জমা দেওয়া হয়েছে ২৫ আগস্ট ২০২৬) বোঝায় যে আমরা এখনো স্বাধীন পুনরুৎপাদন দেখিনি: ৩৭৭ কিলোবাইটের ফাইলটি PDF, HTML ও TeX সোর্সে পাওয়া যায়, তবে পুনরুৎপাদন একটি আলাদা বিষয়।
তবুও দিকটি ফলপ্রসূ মনে হচ্ছে। স্কেলার গুণফল থেকে সরে আসা, দূরত্বের জ্যামিতি নিয়ে সরাসরি কাজ করা, হেডগুলোর মধ্যে গণনা পুনঃব্যবহার — এগুলো ঠিক সেই পদক্ষেপগুলো যা প্রকাশক্ষমতা বিসর্জন না দিয়েই মডেলের খরচ কমায়। যদি ফলাফলগুলো অন্য ডোমেইনে নিশ্চিত হয়, তবে "ছোট কিন্তু সঠিকভাবে গঠিত" নেটওয়ার্কগুলোর জন্য আরও একটি জোরালো যুক্তি তৈরি হবে।