
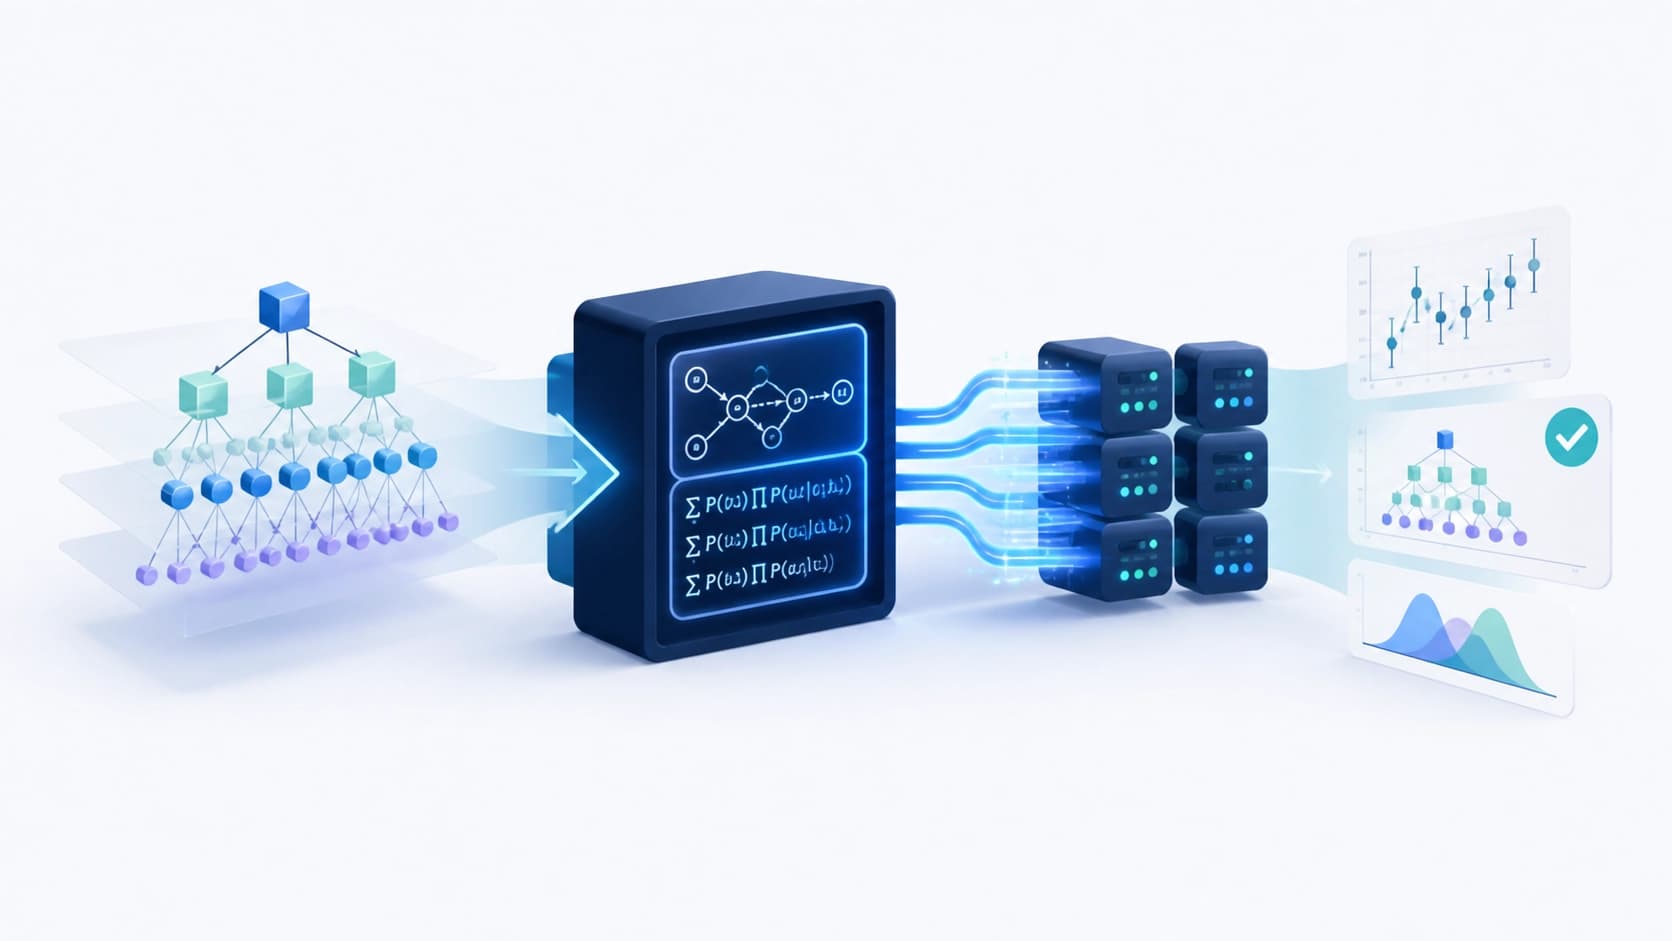
নেস্টেড ডেটা এবং কার্যকারণ অনুমানের পুরনো সমস্যা
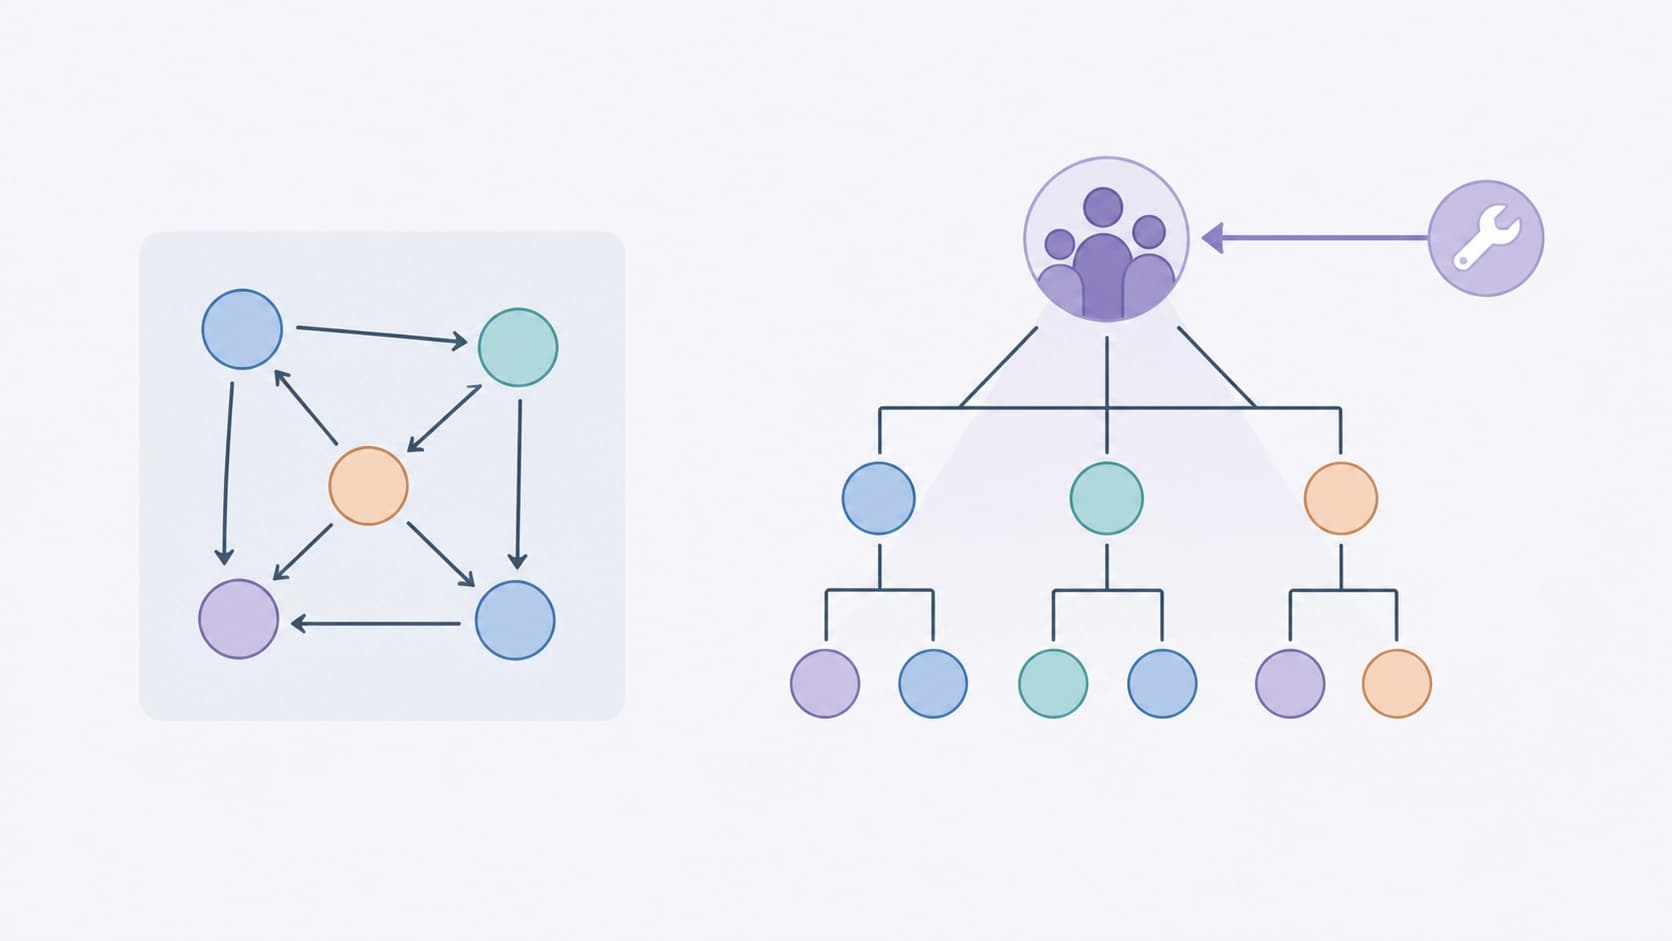
ক্লাসিক্যাল কার্যকারণ অনুমান পদ্ধতিগুলো বেশ ভালো কাজ করে, যখন পর্যবেক্ষণগুলো একে অপরের থেকে স্বাধীন হয়। কিন্তু ডেটায় যখন স্তরক্রম তৈরি হয় — ক্লাসের ভেতরে শিক্ষার্থী, ক্লিনিকের ভেতরে রোগী, বিভাগের ভেতরে কর্মী — তখন সরল পদ্ধতি বিভ্রান্ত করতে শুরু করে। সাধারণ গ্রুপ বস্তুগুলোর মধ্যে একটি পারস্পরিক সম্পর্ক তৈরি করে, যা মডেল ভুলভাবে সংকেত হিসেবে ধরে নেয়, আর উপরের স্তরে ঘটে যাওয়া হস্তক্ষেপগুলো (যেমন পুরো ক্লাসে শর্ত পরিবর্তন) কোথাও "সংযুক্ত" করার জায়গা পাওয়া যায় না।
ঠিক এই বিষয়েই stat.ML বিভাগে নতুন প্রিপ্রিন্ট arXiv:2608.24500 — "Scalable and Versatile Identification for Hierarchical Structural Causal Models: A New Look at Project STAR"। কাজটি প্রকাশিত হয়েছে ২০২৬ সালের ২৫ আগস্ট, প্রস্তুত করেছেন নয়জন লেখকের একটি দল — Janis Aiad, Aghiles Drali, Aymen El Ouadrhiri, Anass Ettahiri, Yasser Oufqir, Simon Patry, David Cortes, Marianne Clausel এবং Emilie Devijver। PDF, HTML সংস্করণ এবং TeX সোর্স পাওয়া যাচ্ছে; বিষয়বস্তু — মেশিন লার্নিং এবং কৃত্রিম বুদ্ধিমত্তা।
এই উপাদানটি আরেকটি নতুন মডেল হিসেবে নয়, বরং একটি সম্পূর্ণ, পুনরুৎপাদনযোগ্য পাইপলাইন গড়ে তোলার চেষ্টা হিসেবে আকর্ষণীয়: গ্রাফের আনুষ্ঠানিক লেখা থেকে শুরু করে একটি নির্দিষ্ট সংখ্যা পর্যন্ত, যা কোনো নিবন্ধে বা ক্লায়েন্টের সামনে প্রতিবেদনে রক্ষা করা যায়।
লেখকেরা কী প্রস্তাব করছেন
এখানে স্তরক্রমিক কাঠামোগত কার্যকারণ মডেল (HSCM) এর জন্য একটি পাইপলাইনের কথা বলা হচ্ছে। এটি উন্মুক্ত এবং স্কেলযোগ্য হিসেবে পরিকল্পিত: একই যুক্তি ছোট শিক্ষামূলক উদাহরণ এবং অনেক গ্রুপযুক্ত ডেটা — উভয়ই সামলাতে পারবে।
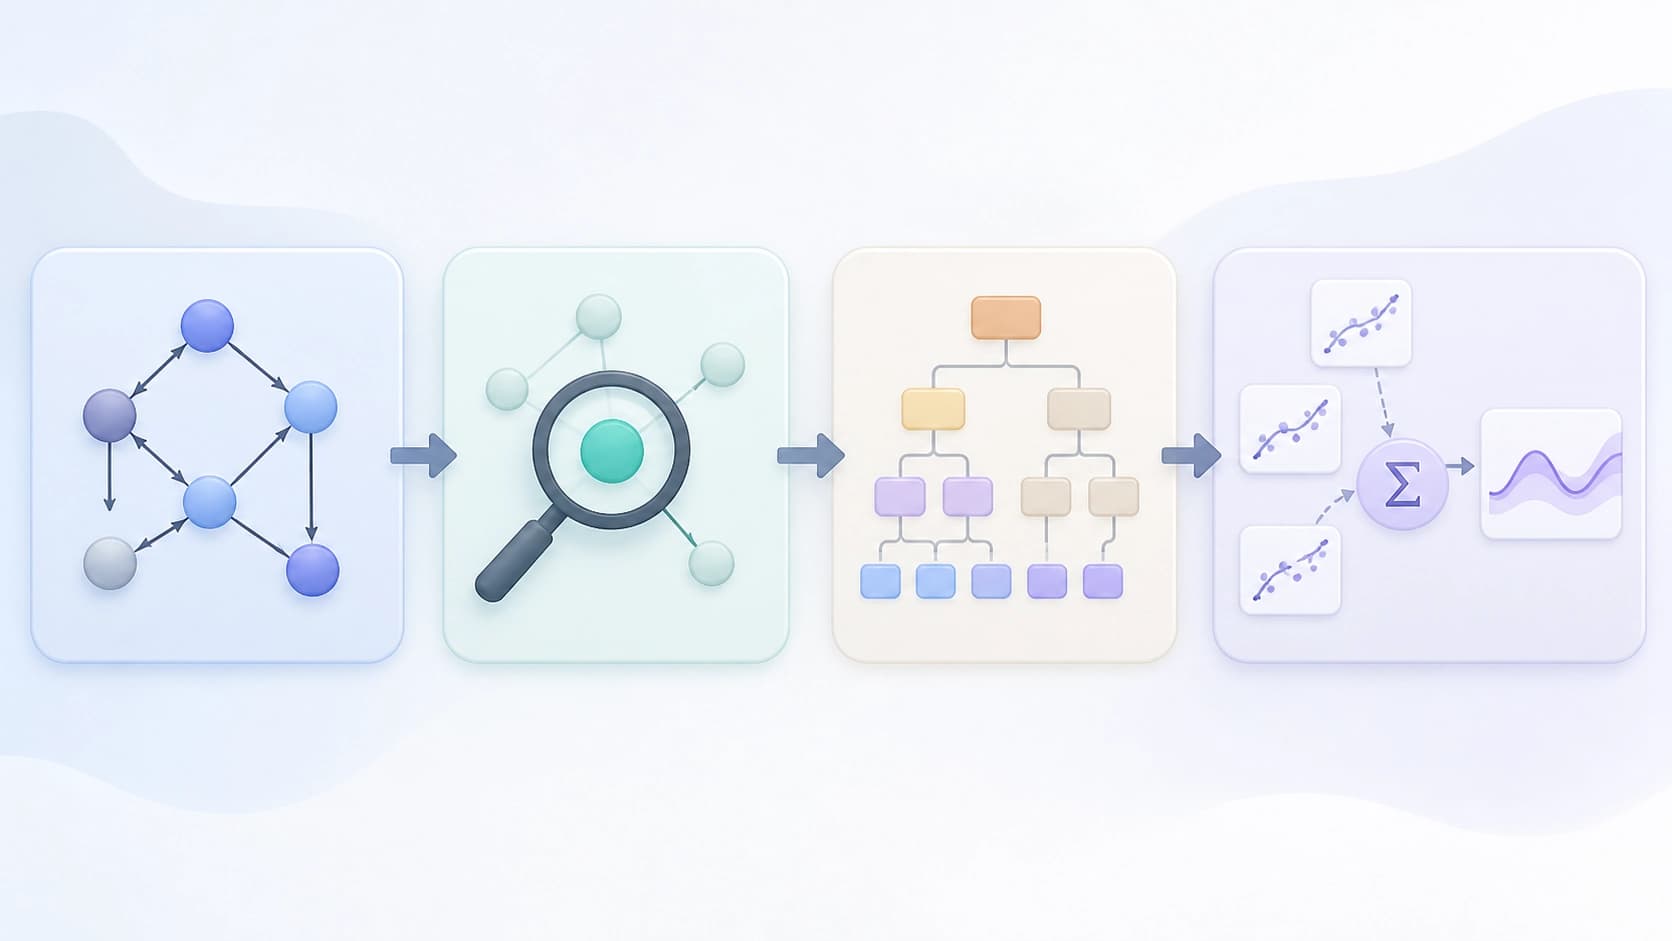
কাঠামোটি চারটি স্তর থেকে তৈরি:
- গ্রাফ রূপান্তর — স্তরগুলোর মধ্যে নির্ভরতা বর্ণনা করে এমন কাঠামোর প্রস্তুতি;
- pyAgrum লাইব্রেরিতে do-calculus এর মাধ্যমে প্রতীকী শনাক্তকরণ — মেশিন নিজেই নির্ধারণ করে কোন প্রভাবগুলো উপলব্ধ ডেটা থেকে অনুমানযোগ্য, এবং সংশ্লিষ্ট রাশি বের করে;
- এই রাশিকে HSCM এর বদ্ধ সূত্রে রূপান্তর — প্রতীকী ফলাফল স্তরক্রমিক মডেলের কাঠামোর মধ্যে গণনাযোগ্য কিছুতে পরিণত হয়;
- ইতিমধ্যে ফিট করা স্থানীয় সম্ভাব্যতা মডেলের মাধ্যমে সংখ্যাগত মূল্যায়ন।
এখানে যুক্তিটি মূলত দ্বিস্তরীয়। প্রথমে নির্ধারণ করা হয় প্রভাবটি নীতিগতভাবে শনাক্তযোগ্য কি না — এটি গণিতের প্রশ্ন, ডেটার নয়। আর পরেই যুক্ত হয় পরিসংখ্যান: অনুমান, ত্রুটি, স্থিতিশীলতা।
বিমূর্ত সিনট্যাকটিক ট্রি — স্কেলের চাবিকাঠি
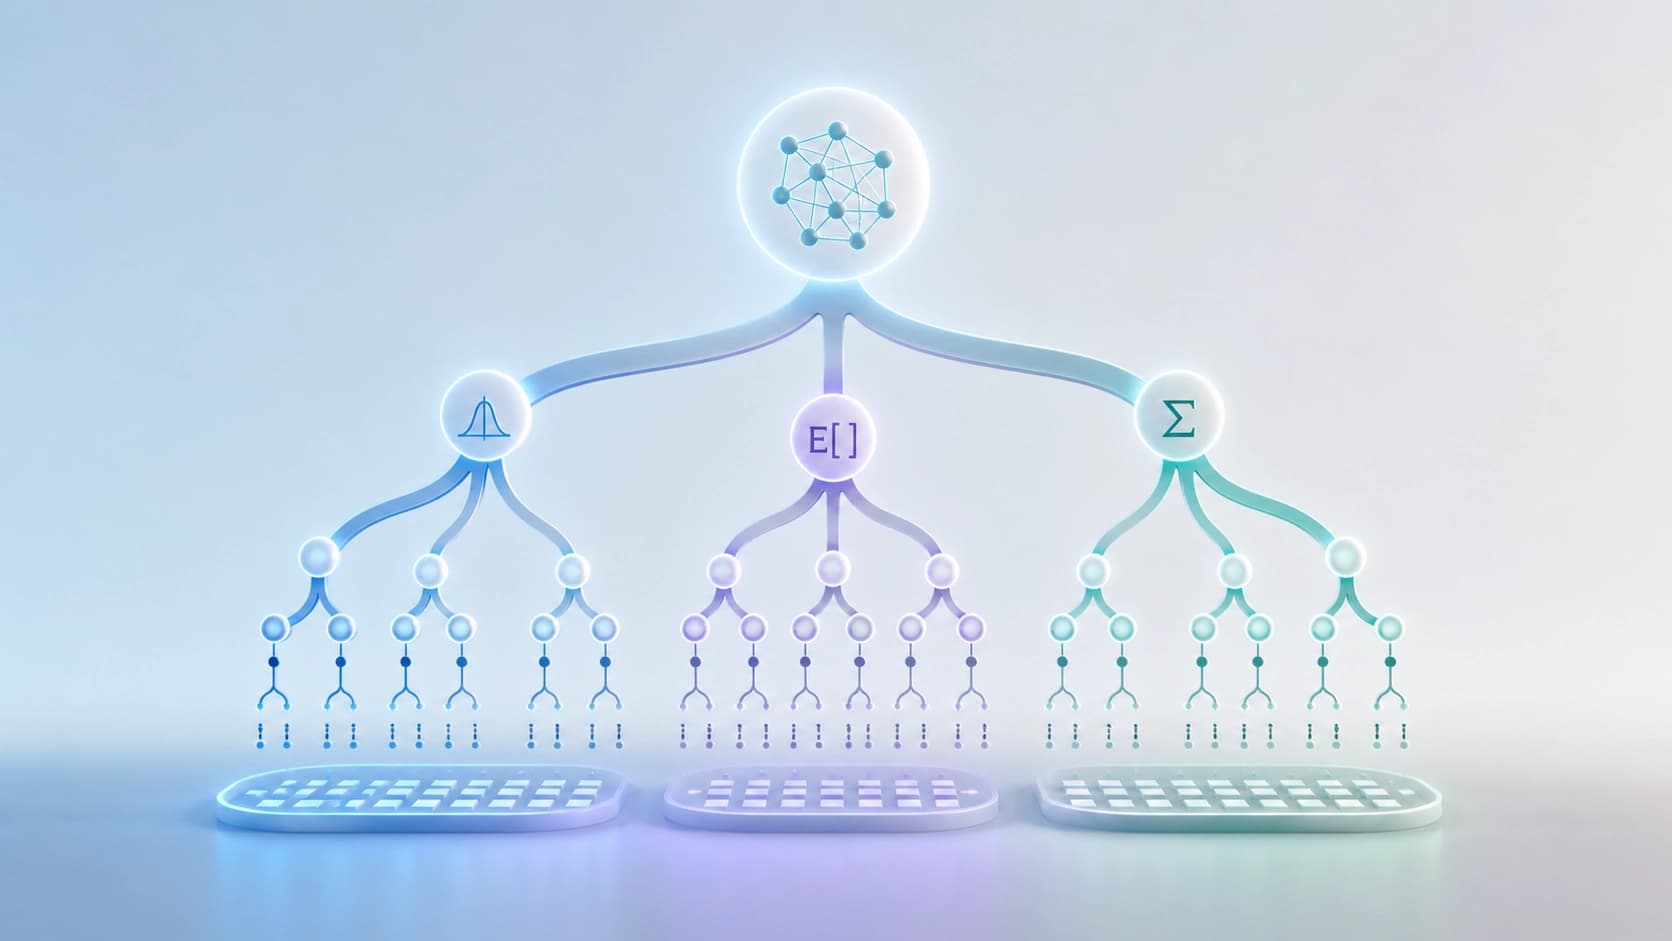
কাজটির প্রধান প্রযুক্তিগত আবিষ্কার — অভিযোজিত বিমূর্ত সিনট্যাকটিক ট্রি (AST)। pyAgrum থেকে শনাক্ত করা রাশিটি সরাসরি "হুবহু" গণনা করা হয় না: এটিকে একটি ট্রিতে বিশ্লেষণ করা হয়, আর সেই ট্রির পাতাগুলো তিন ধরনের স্বাধীন উপকর্মে পরিণত হয় — ঘনত্ব গণনা, গাণিতিক প্রত্যাশা নির্ণয় এবং মার্জিনালাইজেশন।
কেন এটি গুরুত্বপূর্ণ? প্রাপ্ত উপকর্মগুলো সমান্তরালে গণনা করা যায় এবং মধ্যবর্তী ফলাফল ক্যাশে রাখা যায়। একটি বিশাল রাশির বদলে, যেখানে প্রাথমিক ধাপের ভুল পরবর্তী সবকিছু নষ্ট করে দেয়, সেখানে স্বাধীন টুকরোগুলোর একটি সেট তৈরি হয়, যার প্রতিটি আলাদাভাবে যাচাইযোগ্য। মূলত, লেখকেরা গণনাশক্তির সমস্যাকে গণনার সংগঠনের সমস্যায় রূপান্তরিত করেন।
Project STAR-এ যাচাই
বিষয়বস্তুপূর্ণ উদাহরণ হিসেবে নেওয়া হয়েছে STAR (Student-Teacher Achievement Ratio) পরীক্ষা, যা ১৯৮৫ সালে মার্কিন যুক্তরাষ্ট্রের টেনেসি অঙ্গরাজ্যে পরিচালিত হয়েছিল। এটি একটি আদর্শ স্তরক্রমিক ডেটাসেট: এটি ক্লাসের আকারের প্রভাব শিক্ষার্থীর ফলাফলে মূল্যায়নের জন্য তৈরি করা হয়েছিল, আর এতে পর্যবেক্ষণগুলো ক্লাসের ভেতরে নেস্টেড। এমন কাঠামো HSCM এর জন্য আদর্শ পরীক্ষাক্ষেত্র, কারণ এখানে হস্তক্ষেপ স্বাভাবিকভাবেই ক্লাসের স্তরে ঘটে, কোনো একক শিশুর স্তরে নয়।
প্রকৃত ডেটায় যাওয়ার আগে, লেখকেরা ক্যানোনিক্যাল HSCM মোটিফ এবং বেঞ্চমার্ক দৃশ্যপটে পাইপলাইনটি যাচাই করেন, যেখানে সঠিক উত্তর আগে থেকেই জানা। এটি একটি যুক্তিসঙ্গত ক্রম: প্রথমে নিশ্চিত হওয়া যে পদ্ধতিটি যেখানে উত্তর জানা আছে সেখানে সঠিক উত্তর খুঁজে পায়, এবং কেবল তারপর এমন ডেটায় প্রয়োগ করা যেখানে যাচাইয়ের কিছু নেই। চূড়ান্ত প্রয়োগ — STAR এর কাঠামোয় কিন্ডারগার্টেনে গণিতের ফলাফল।
ফলাফল কী দেখাল
সিদ্ধান্তগুলো বাস্তববাদী হয়ে উঠেছে, এবং এখানেই তাদের মূল্য।
প্রথমত, স্তরক্রম উপেক্ষা করা সমতল বেস মডেলগুলো সংযোগ পুনরুদ্ধার করে — কিন্তু ক্লাসের স্তরে হস্তক্ষেপ এনকোড করতে সক্ষম নয়। "ছোট ক্লাস — বেশি স্কোর" এই পারস্পরিক সম্পর্ক এবং ক্লাস ছোট করার কার্যকারণ প্রভাব — দুটি ভিন্ন বিষয়, এবং প্রথমটি দ্বিতীয়টির বিকল্প নয়।
দ্বিতীয়ত, কেবল প্রতীকী শনাক্তকরণই যথেষ্ট নয়। এমনকি রাশিটি সঠিকভাবে অনুমান করা হলেও, ব্যবহারিক স্তরক্রমিক অনুমানের জন্য একটি কার্যকর সংখ্যাগত স্তর প্রয়োজন।
এখান থেকেই তৃতীয় বক্তব্য: স্কেলযোগ্য মূল্যায়ন এবং সংখ্যাগত স্থিতিশীলতার যাচাই — পদ্ধতির একটি সংযোজন নয়, বরং তার কেন্দ্রীয় অংশ। একটি সুন্দর রাশি, যা গণনা করা অসম্ভব বা ডেটার সামান্য পরিবর্তনেই ভেঙে পড়ে, কোনো বৈজ্ঞানিক মূল্য বহন করে না। তাই পাইপলাইনে গণনার বিশ্লেষণ এবং স্থিতিশীলতা নিয়ন্ত্রণে এত মনোযোগ দেওয়া হয়েছে।
STAR এর বাইরে কেন এটি প্রয়োজন
স্তরক্রমিক ডেটা যতটা মনে হয় তার চেয়ে অনেক বেশি দেখা যায়। শিক্ষা, চিকিৎসা, ক্লাস্টারিংসহ A/B-পরীক্ষা, অঞ্চলভিত্তিক সমাজ জরিপ, ব্যাচভিত্তিক শিল্প পরিমাপ — সর্বত্রই নেস্টিং আছে, আর সর্বত্রই সরলতার জন্য এটি উপেক্ষা করার প্রলোভন আছে।
কাজটির মূল্য এই যে এটি কোনো আলাদা কৌশল নয়, বরং একটি পুনরুৎপাদনযোগ্য পদ্ধতি প্রস্তাব করে। উন্মুক্ত কোড, pyAgrum এর মাধ্যমে স্বয়ংক্রিয় শনাক্তকরণ, গণনাযোগ্য সূত্রে আনুষ্ঠানিক রূপান্তর, স্বাধীন উপকর্ম — এসব মিলে প্রবেশের সীমা কমিয়ে দেয়: গবেষককে প্রতিটি নতুন গ্রাফ কাঠামোর জন্য নিজে সূত্র বের করতে হয় না।
সীমাবদ্ধতা এবং সাধারণ বিবেক
মনে রাখা উচিত, এটি একটি প্রিপ্রিন্ট, পিয়ার-রিভিউ করা প্রকাশনা নয়: arXiv:2608.24500 সংস্করণ v1, DOI 10.48550/arXiv.2608.24500। ক্যানোনিক্যাল মোটিফ এবং একটি ডেটাসেটে ফলাফল — ভালো একটি যাচাই, কিন্তু সর্বজনীন প্রমাণ নয়।
এছাড়া, যেকোনো কার্যকারণ অনুমান গ্রাফ কাঠামো সম্পর্কিত অনুমানের উপর নির্ভর করে। পাইপলাইন গণনা স্বয়ংক্রিয় করে এবং তা আরও স্বচ্ছ করে তোলে, কিন্তু "আমরা কি আদৌ পৃথিবীকে সঠিকভাবে বর্ণনা করেছি" — এই প্রশ্নটি দূর করে না। গ্রাফ ভুল হলে, সযত্নে গণনা করা প্রভাবও সযত্নে গণনা করা একটি ভ্রান্তি হয়েই থাকবে।
ঠিক তাই নিবন্ধটির প্রধান ব্যবহারিক উপসংহারটি বিনয়ী শোনায়: মূল্যায়ন ছাড়া শনাক্তকরণ অর্থহীন, স্থিতিশীলতা ছাড়া মূল্যায়ন ঝুঁকিপূর্ণ, আর নেস্টেড ডেটার জন্য মডেলে একটি আলাদা স্তর প্রয়োজন, নইলে গ্রুপ-স্তরের হস্তক্ষেপগুলোর সাথে তুলনা করার মতো কিছুই থাকে না।


