সম্পূর্ণ ফাইন-টিউনিং আর বুদ্ধিমান বিকল্প নয়
ইলেক্ট্রোএনসেফালোগ্রাফির জন্য ফাউন্ডেশনাল মডেলগুলো লেবেল ছাড়াই প্রশিক্ষণ দেওয়া হয় — কনট্রাস্টিভ টাস্কে বা সিগন্যালের মাস্ক করা অংশ পুনর্গঠনের মাধ্যমে। যুক্তিটা হলো: মডেল প্রথমে রিদম, আর্টিফ্যাক্ট এবং অবস্থার মধ্যে রূপান্তরের সাধারণ নিয়মগুলো শিখে নেয়, তারপর এপিলেপটিক ডিসচার্জ শনাক্ত করার মতো সংকীর্ণ কাজের জন্য তাকে আরও প্রশিক্ষণ দেওয়া হয়। তত্ত্বগতভাবে এটি এমন রিপ্রেজেন্টেশন দেয় যা ক্লিনিক ও যন্ত্রপাতির মধ্যে স্থানান্তরযোগ্য। বাস্তবে ব্যাপারটা আরও জটিল: ক্লিনিকাল রেকর্ডিংয়ের আর্কাইভগুলো একে অপরের সাথে এতটাই অসদৃশ যে স্থানান্তরের গুণমান লক্ষণীয়ভাবে কমে যায়।
দ্বিতীয় সমস্যা হলো অর্থনীতি। ক্লাসিক ফাইন-টিউনিং সব ওয়েট আপডেট করে, অর্থাৎ প্রতিটি নতুন কাজের জন্য বড় ধরনের কম্পিউটেশনাল রিসোর্স দরকার। GPU-ক্লাস্টার ছাড়া কোনো বিভাগে এই ধরনের পরিস্থিতি চালু করাই যায় না। এখান থেকেই arXiv:2608.24727 কাজটির মূল প্রশ্ন: সামান্য অংশ প্যারামিটার দিয়েই কি কাজ চালানো যায়, আর গুণমানে কোনো ক্ষতি না হয়?
নয় শতাংশ: আসলে কী টিউন করা হয়
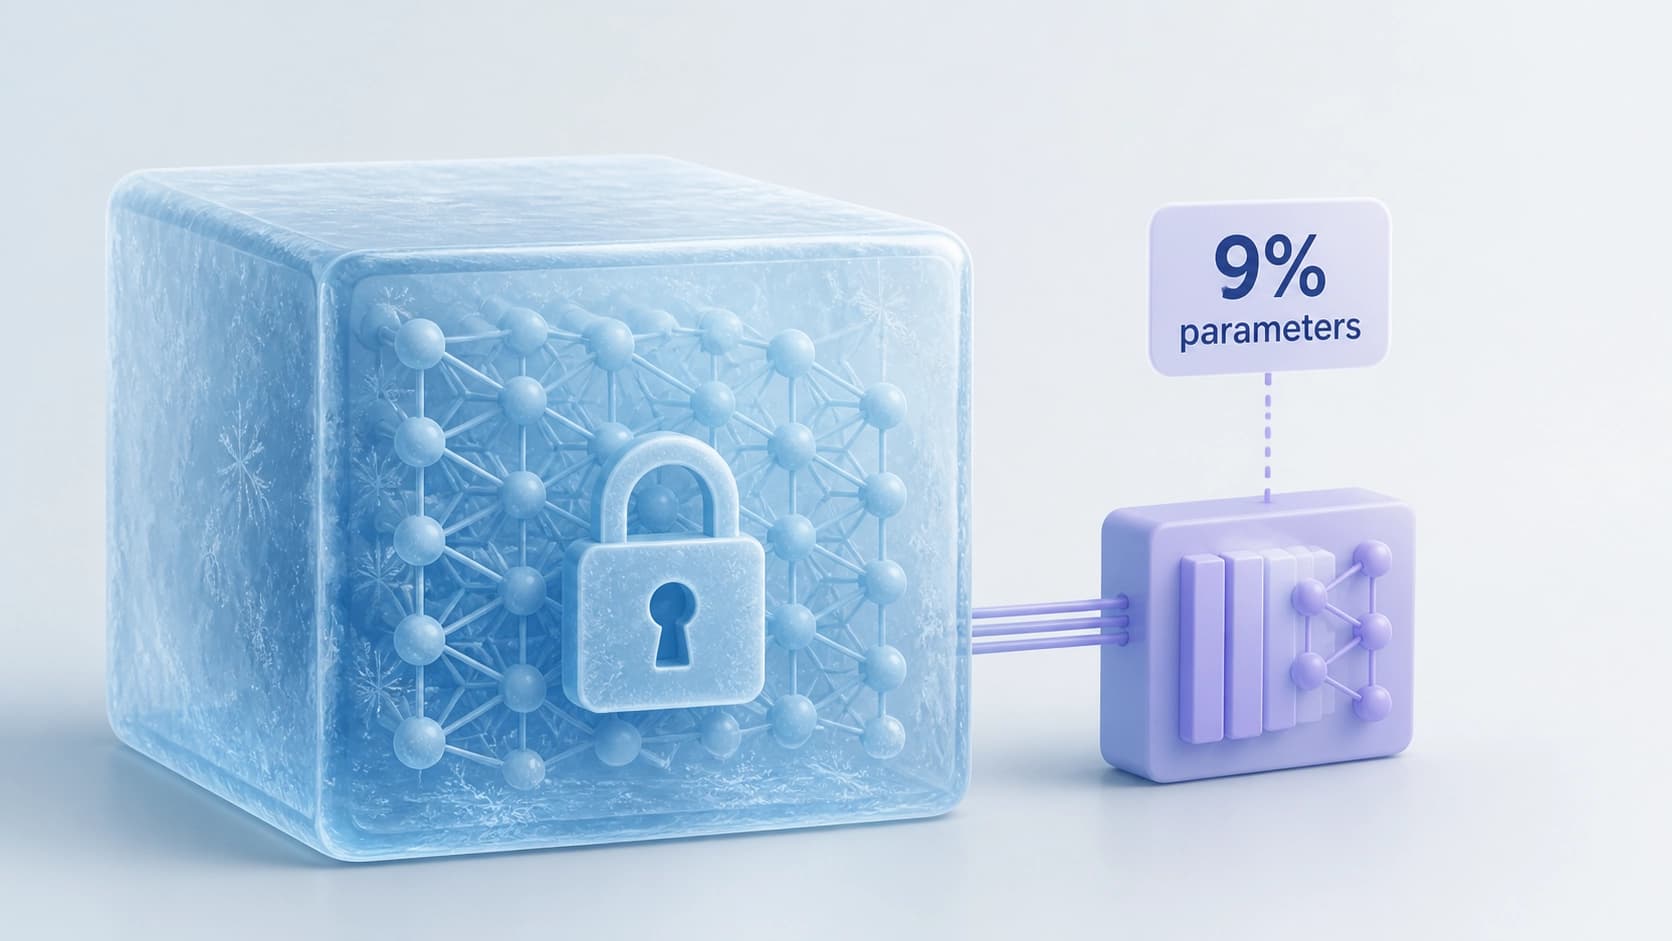
প্রিপ্রিন্টের লেখকরা হলেন Meghal Dani এবং Stefanie Liebe। তাঁরা এমন একটি মোড পরীক্ষা করেন যেখানে প্রায় ৯% ওয়েট প্রশিক্ষণযোগ্য থাকে, আর মডেলের বাকি অংশ ফ্রিজ করা থাকে। অভিযোজন হয় স্ব-শিক্ষণমূলক ধাঁচে: মডেলকে শুধু ক্লাস লেবেলের সাথে মেলানো হয় না, বরং লক্ষ্য কাজের সাথে অভ্যন্তরীণ রিপ্রেজেন্টেশনগুলো সমন্বয় করা হয়। লেখাটি ২৫ আগস্ট ২০২৬-এ প্রকাশিত (সংস্করণ v1), এটি cs.LG এবং cs.AI বিভাগে অন্তর্ভুক্ত, DOI — 10.48550/arXiv.2608.24727। কোড পুনরুৎপাদনের জন্য উন্মুক্ত।
মূল কথা হলো এটি কোনো "কাটছাঁট করা" মডেল নয়। এটি পরিচালনার একটি ভিন্ন মোড: ভারী পূর্ব-প্রশিক্ষিত এনকোডার অপরিবর্তিত থাকে, আর প্রতিটি নতুন কাজের জন্য একটি কম্প্যাক্ট উপরি-কাঠামো টিউন করা হয়। ক্লিনিকের জন্য এই বিভাজন মৌলিক — ব্যয়বহুল পূর্ব-প্রশিক্ষণ একবারই করা হয়, সস্তা অভিযোজন যতবার খুশি ততবার পুনরাবৃত্তি করা যায়।
ভিন্ন পূর্ব-প্রশিক্ষণ লক্ষ্যসহ দুটি মডেল
ফলাফল যেন কোনো একটি সফল আর্কিটেকচারের উপর নির্ভর না করে, সেজন্য পরীক্ষায় দুটি SOTA মডেল অংশ নেয়: কনট্রাস্টিভ লক্ষ্যসহ BIOT এবং মাস্ক করা অংশ পুনর্গঠনে প্রশিক্ষিত CBraMod। যদি কৌশলটি দুই ক্ষেত্রেই কাজ করে, তাহলে এটি কাকতালীয় নয়, বরং পদ্ধতির একটি বৈশিষ্ট্য।
তিনটি ক্লিনিকাল ডেটাসেট এবং দুটি যাচাই মোড
মূল্যায়ন করা হয় TUAB (অস্বাভাবিকতা শনাক্তকরণ), TUEV (ইভেন্ট শ্রেণীবিভাগ) এবং CHB-MIT (খিঁচুনি শনাক্তকরণ)-এ। পরিমাপ করা হয় দুইবার — in-distribution এবং out-of-distribution, অর্থাৎ শুধু "নিজের" ডেটাতেই নয়, সরে যাওয়া ডিস্ট্রিবিউশনেও পরীক্ষা করা হয়।
ফলাফল কী দেখাল
- লিনিয়ার প্রোবিংয়ের তুলনায় স্ব-শিক্ষণমূলক অভিযোজন ধারাবাহিক উন্নতি দেয় — AUCPR-এ ২০ গুণ পর্যন্ত। এটি "সামান্য ভালো" নয়, বরং মাত্রার ক্রমের পার্থক্য, এবং এটি বিশেষভাবে লক্ষণীয় সেখানে যেখানে বিরল ক্লাস সামগ্রিক accuracy-এর চেয়ে বেশি গুরুত্বপূর্ণ।
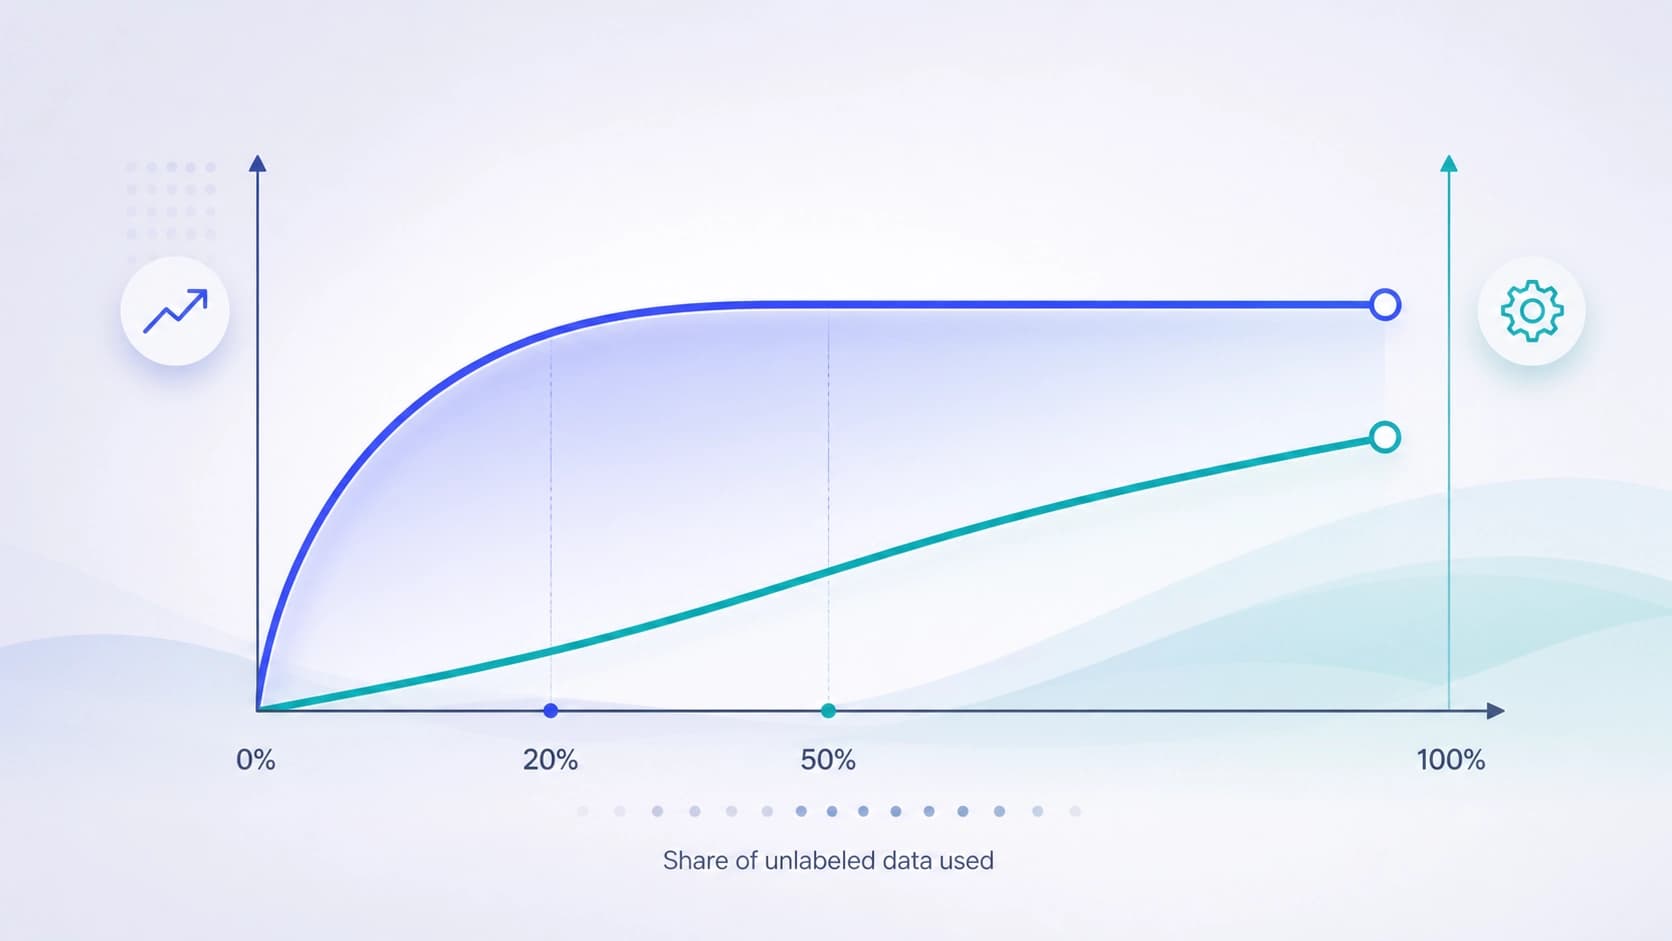
- নির্দিষ্ট কম্পিউটেশনাল বাজেটে শীর্ষে পৌঁছানো যায় মাত্র ২০–৫০% উপলব্ধ আনলেবেলড রেকর্ডিং দিয়েই। বাকি কর্পাস আর কোনো উন্নতি যোগ করে না।
- যদি সিগন্যাল উইন্ডোর মোট সংখ্যা নির্দিষ্ট থাকে, ফলাফল নির্ভর করে না তার মধ্যে কতজন রোগী অন্তর্ভুক্ত হলো তার উপর। অর্থাৎ কাজ করে "মানুষের অনন্যতা" নয়, বরং খণ্ডাংশগুলোর সময়গত বৈচিত্র্য: রেকর্ডিংয়ের ভেতরে ভিন্ন ভিন্ন অবস্থা, মোড এবং আর্টিফ্যাক্ট।
শেষ পয়েন্টটি ডেটা সংগ্রহ করার প্রচলিত যুক্তিকে উল্টে দেয়। সহজবোধ্যভাবে মনে হয়, যত বেশি ভিন্ন রোগী, তত নির্ভরযোগ্য। এখানে দেখা যায়, উইন্ডোর সংখ্যার কঠোর সীমা থাকলে কম সংখ্যক মানুষের কাছ থেকেই ডেটা সংগ্রহ করা যায় — শুধু সময়ের সাথে তাদের সিগন্যালের বৈচিত্র্য লক্ষ্য রাখলেই হয়।
কেন এটি ক্লিনিকের হিসাব বদলে দেয়
এতদিন EEG ফাউন্ডেশনাল মডেল চালু করার ক্ষেত্রে বাধা ছিল রিপ্রেজেন্টেশনের গুণমান নয়, বরং বাজেট: মডেল থেকে উপকার পেতে হলে সম্পূর্ণ ফাইন-টিউনিং এবং বড় লেবেলযুক্ত কর্পাসের সামর্থ্য থাকতে হতো। কাজটি দেখায় যে এই বাধা একইসাথে দুই দিক থেকে কমানো সম্ভব — কম্পিউটেশন এবং ডেটা উভয় দিকেই। একশ শতাংশের বদলে নয় শতাংশ ওয়েট, আর পুরো ভলিউমের বদলে অর্ধেক আনলেবেলড আর্কাইভ।
হাসপাতালের জন্য এর অর্থ আরও বাস্তবসম্মত একটি পরিস্থিতি: মডেল কেন্দ্রীয়ভাবে পূর্ব-প্রশিক্ষিত হয়, আর স্থানীয়ভাবে নির্দিষ্ট কাজের জন্য সাধারণ যন্ত্রপাতিতেই টিউন করা হয়। কে বেশি রেকর্ডিং সংগ্রহ করেছে তার উপর নির্ভরতা কমে, আর অতিরিক্ত ঘণ্টার সিগন্যাল সংরক্ষণ ও প্রক্রিয়াকরণের খরচও কমে।
মনে রাখা উচিত
ফলাফলটিকে "নয় শতাংশ সবসময়ই যথেষ্ট" হিসেবে পড়া উচিত নয়। এটি একটি নির্দিষ্ট পরীক্ষার একটি নির্দিষ্ট মোড, যেকোনো আর্কিটেকচার ও যেকোনো ডেটাসেটের জন্য সর্বজনীন রেসিপি নয়। লেখকরা নিজেরাই সতর্ক করেন: EEG মডেলের সাধারণীকরণ সীমিতই রয়ে গেছে, বিশেষত ভিন্নধর্মী ক্লিনিকাল কর্পাসে। প্যারামিটার-দক্ষ অভিযোজন স্থানান্তরের সমস্যা দূর করে না — এটি কেবল তাতে প্রবেশের খরচ কমায়।
ব্যবহারিক উপসংহারটি যতটা মনে হয় তার চেয়ে সহজ: আলোচনাটি "EEG-এর জন্য ফাউন্ডেশনাল মডেল নিয়ে আদৌ মাথা ঘামানো উচিত কি না" এই স্তর থেকে সরে গিয়ে "বিভাগে এগুলো কীভাবে চালু করা যায়" এই স্তরে চলে যায়। আর এটি কেবল মেশিন লার্নিংয়ের নয়, বরং ইঞ্জিনিয়ারিং ও প্রক্রিয়া সংগঠনের প্রশ্ন।