স্বয়ংক্রিয় মূল্যায়নের গুণমানের প্রতিবেদনে সাধারণত ঠিক দুটি সংখ্যা জায়গা পায়: মডেলের রায় মানুষের সঙ্গে কতটা মেলে এবং বিকল্পের ক্রম বদলানো বা প্রম্পট নতুন করে লেখার মতো ছোটখাটো পরিবর্তনের প্রতি সেগুলো কতটা স্থির থাকে। নতুন একটি গবেষণাপত্র দাবি করে, এটুকু যথেষ্ট নয় — এবং বিচারককে ভিন্ন চোখে দেখার প্রস্তাব দেয়।
সম্মতি ভুল প্রশ্নের উত্তর দেয়
সম্মতি এবং উপরিতলের ঝাঁকুনির প্রতি স্থিরতা — এগুলো নির্ভরযোগ্যতা (reliability) সম্পর্কে। একটি নির্ভরযোগ্য পরিমাপক যন্ত্র স্থির ফলাফল দেয়, কিন্তু স্থিরতা নিজে থেকে এই বলে না যে তা সঠিক রাশিটি মাপছে কি না। যে থার্মোমিটার সবসময় ২০ ডিগ্রি দেখায়, তা অত্যন্ত নির্ভরযোগ্য এবং সম্পূর্ণ অকেজো।
«A Judge Should Know What Changed: Construct Validity for LLM-as-a-Judge Evaluation» (Jianlin Chen, Wenhui Chen, Ziyao Lin, Chi Man Vong; arXiv:2608.24419, cs.AI, জমা দেওয়া হয়েছে ২৫ আগস্ট ২০২৬; ৩৯ পৃষ্ঠা, ১০টি চিত্র, ১১টি সারণি) শীর্ষক নিবন্ধের লেখকেরা আলোচনাটিকে নিয়ে যান কনস্ট্রাক্ট ভ্যালিডিটির সমতলে: মূল্যায়নটি যে ধারণাটি মাপার দাবি করে, তা আদৌ মাপে কি না। একটি LLM-বিচারকের জন্য এর অর্থ সহজ — বিচারককে অর্থে সাড়া দিতে হবে, রূপে নয়।
দুই মাত্রার প্রোফাইল
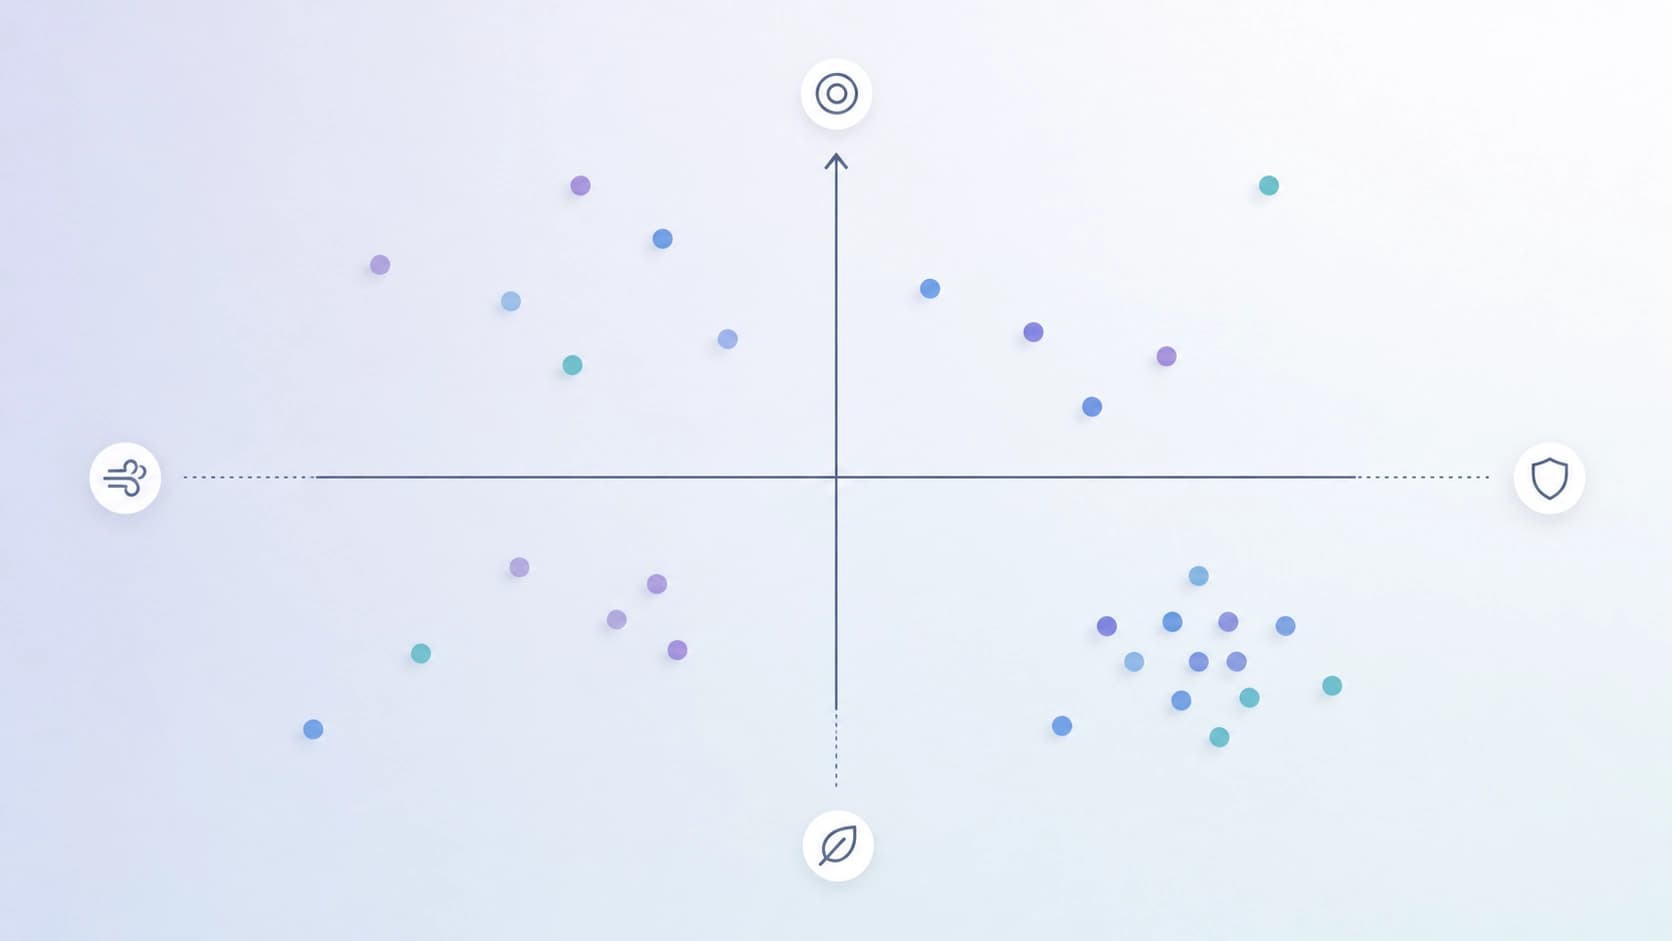
একটি মেট্রিকের বদলে দুটি সম্ভাবনার একটি প্রোফাইল প্রস্তাব করা হয়।
S — অপরিবর্তনশীলতা। কোনো সম্পাদনা অর্থ অটুট রাখলে রায় কতবার অপরিবর্তিত থাকে: অনুচ্ছেদ সরানো হলো, শৈলী বদলানো হলো, বাহুল্য বাদ দেওয়া হলো। ভালো বিচারকের এখানে টলে যাওয়া উচিত নয়।
R — কনস্ট্রাক্ট সংবেদনশীলতা। কোনো সম্পাদনা ন্যূনতম হলেও অর্থে আঘাত করলে রায় কতবার বদলায়: একটি শর্ত জুড়ে দেওয়া হলো, দাবি দুর্বল করা হলো, প্রয়োগের পরিধি সংকুচিত করা হলো। ভালো বিচারকের এখানে সাড়া দেওয়া বাধ্যতামূলক।
নিবন্ধের মূল দাবি: S এবং R স্বাধীন, এবং কোনো স্কেলার সারসংক্ষেপ সব প্রাসঙ্গিক তুলনা সংরক্ষণ করে না। সহজ কথায়, দুটি সংখ্যার গড় করে একটি সৎ সংখ্যা পাওয়া যায় না — উচ্চ S ও নিম্ন R-এর বিচারক এবং নিম্ন S ও উচ্চ R-এর বিচারক একই «গড় মূল্যায়ন» দিতে পারে, অথচ মৌলিকভাবে ভিন্ন যন্ত্র থেকে যায়।
কীভাবে যাচাই করা হলো
পরীক্ষামূলক গঠন এ ধরনের কাজের স্বাভাবিক ধাঁচের চেয়ে заметно কঠোর।
- ৭ জন বিচারক এবং ৪টি ডোমেইন — অর্থাৎ একটি মডেল বা এক ধরনের কাজেই যাচাই করা হয়নি।
- ৭ ধরনের কনস্ট্রাক্ট-পরিবর্তনকারী হস্তক্ষেপ বনাম ৫টি নিয়ন্ত্রণ, যা কেবল রেজিস্টার ছোঁয় এবং অর্থ বদলায় না।
- সম্পাদনার দিক — তা কনস্ট্রাক্ট বদলায় কি না — নির্ধারণ করেছেন মানব অ্যানোটেটররা, ডিফল্ট লেবেলিং নয়।
- জেনারেশন, ভেরিফিকেশন এবং বিচারকত্ব অছেদহীন মডেল পরিবারে সীমাবদ্ধ ছিল। এটি গুরুত্বপূর্ণ খুঁটিনাটি: বিচারক নিজের তৈরি টেক্সট মূল্যায়ন করে না, এবং নিজের উদ্ভাবিত সম্পাদনা যাচাই করে না।
শেষ বিন্দুটি আলাদা মনোযোগের দাবি রাখে। যখন জেনারেটর, ভেরিফায়ার এবং বিচারক একই মডেল, তখন উচ্চ সম্মতি সাধারণ পক্ষপাতের কৃত্রিম ফল হতে পারে, গুণমানের প্রমাণ নয়।
অপরিবর্তনশীলতা প্রায় নিখুঁত, সংবেদনশীলতা — নয়
এখানেই সবচেয়ে মজার অংশ শুরু। সম্মত অপরিবর্তনশীলতার সীমা S ≥ ০.৯০-এ বিচারকেরা গড়ে দেখিয়েছেন S = ০.৯৪৫। রিপোর্টিংয়ে সাধারণত যে সংখ্যার দিকেই লক্ষ্য থাকে।
সংবেদনশীলতা meanwhile — R = ০.৩১৯। মোটামুটি ব্যাখ্যা: প্রায় তিনটি ক্ষেত্রে দুটিতে বিচারক সেই সম্পাদনা লক্ষ করেনি, যা অর্থ বদলায়। অপরিবর্তনশীলতায় আনুষ্ঠানিকভাবে নিখুঁত ফলাফল একইসঙ্গে বিষয়বস্তুতে খুব দুর্বল সাড়ার সঙ্গে সহাবস্থান করে।
পরিসর আর শক্তি — এক নয়
দুর্বল সংবেদনশীলতা অসমভাবে বিতরণ করা। যখন সম্পাদনা দাবির পরিসর বদলায়, সাড়া বেশি: R_scope = ০.৩৮৩। যখন তা শক্তি বদলায় — দুর্বলতর: R_strength = ০.২৬২। ব্যবধান +০.১২১, এবং এর চিহ্ন সাতজন বিচারকের সবার জন্য একই।
অর্থাৎ বিষয়টি মডেলগুলোর মধ্যে দৈব বিচ্যুতি নয়, বরং একটি পদ্ধতিগত বৈশিষ্ট্য। বিচারকেরা প্রয়োগের পরিধির প্রসারণ ও সংকোচন ভালোভাবে পড়তে পারেন, আত্মবিশ্বাসের মাপকাঠিতে স্থানচ্যুতির চেয়ে — «সম্ভবত» বনাম «নিশ্চিতভাবে», «সহায়তা করতে পারে» বনাম «সহায়তা করে»। বাস্তব কাজে এটি অপ্রীতিকর খবর: ঠিক এই ধরনের ক্রমাঙ্কনই সবচেয়ে বেশি আলাদা করার প্রয়োজন হয়।
মানব লেবেলও যাচাই করা উচিত
আলাদা একটি প্রসঙ্গ — পাঁচটি প্রকাশ্য লেবেল সেট, যা মানদণ্ড হিসেবে ব্যবহৃত হয়। কেবল টেক্সটের উপরিতলের বৈশিষ্ট্যের উপর নির্ভরশীল প্রেডিক্টরগুলো জোড়া মোডে ৫৫–৬৭% লেবেল পুনরুৎপাদন করে। MT-Bench-এর ক্ষেত্রে উপরিতলের হিউরিস্টিক ৬৭.৪% মানব ভোটের সঙ্গে মিলেছে।
উপসংহারটি অস্বস্তিকর। যদি বিষয়বস্তু সম্পর্কে কিছু না বোঝা একটি সরল নিয়ম মানব সিদ্ধান্তের দুই-তৃতীয়াংশ পুনরাবৃত্তি করে, তবে এই ধরনের লেবেল অর্থকে রূপ থেকে ভালোভাবে আলাদা করে না — এবং কেবল বিচারকই নয়, যে সেটে তাকে যাচাই করা হয় সেটিও বৈধতা যাচাই করা প্রয়োজন।
এ নিয়ে কী করা যায়
লেখকেরা LLM-বিচারককে অন্য কিছু দিয়ে প্রতিস্থাপনের প্রস্তাব দেন না — তাঁরা রিপোর্টিং এবং যাচাইয়ের পদ্ধতি বদলানোর প্রস্তাব দেন।
যৌথ রিপোর্টিং। S এবং R পাশাপাশি প্রকাশিত হয়, একটি সংখ্যায় গুটিয়ে ফেলা হয় না। প্রতিবেদনের পাঠক সঙ্গে সঙ্গে দেখতে পান, বিচারকের দুর্বলতা কোথায়।
ভ্যালিডেশন সেটের অডিট। মানব লেবেলের সঙ্গে সম্মতিতে ভরসা করার আগে যাচাই করা উচিত, টেক্সট না বুঝে এই লেবেলগুলো কতটা পূর্বানুমেয়। যদি ভালোভাবে পূর্বানুমেয় হয় — তবে সেগুলোর উপর ভরসা অতিরঞ্জিত।
ভূমিকা বিভাজন। জেনারেশন, ভেরিফিকেশন এবং বিচারকত্ব ভিন্ন মডেল পরিবারে থাকলে ঝুঁকি কমে যে উচ্চ অপরিবর্তনশীলতা সাধারণ অন্ধবিন্দুর পরিণতি হয়ে দাঁড়াবে।
মূল কথা
উচ্চ সম্মতি স্থিরতা সম্পর্কে, সঠিকতা সম্পর্কে নয়। যে বিচারক অর্থগত সম্পাদনার আগে ও পরে সমান আত্মবিশ্বাসে রায় দেন, তিনি «স্থির» নন, বরং অসতর্ক। যতদিন প্রতিবেদনে কেবল একটি সংখ্যা থাকবে, ততদিন এই দুই অবস্থার পার্থক্য করা অসম্ভব — এবং ঠিক সেজন্যই দুই মাত্রার প্রোফাইল জটিলতা নয়, বরং ন্যূনতম প্রয়োজনীয় সততার পরিচয়।