সমস্যা: মডেলকে সেখানে পরীক্ষা করা হয় যেখানে খোঁজার আর দরকার নেই
হিস্টোলজিক্যাল স্লাইড হলো একটি গিগাপিক্সেল ছবি। রোগনির্ণয় করতে প্যাথলজিস্ট প্রথমে কম বিবর্ধনে প্রস্তুতিটি দেখে নেন, সন্দেহজনক অংশগুলো চিহ্নিত করেন, তারপর সেগুলো কাছ থেকে পর্যবেক্ষণ করেন, বিভিন্ন স্কেলে চিত্রটি মিলিয়ে দেখেন এবং কেবল তারপর সিদ্ধান্তে পৌঁছান। এই কাজের একটি বড় অংশ ব্যয় হয় দেখার পেছনে নয়, বরং খোঁজার পেছনে: কোথায় তাকানো উচিত।
AI-প্যাথলজির জন্য বিদ্যমান বেশিরভাগ বেঞ্চমার্ক মডেলের কাছ থেকে কাজের এই অংশটি কেড়ে নেয়। ইনপুট হিসেবে দেওয়া হয় হয় আগে থেকে কাটা কোনো প্যাচ, নয়তো স্লাইড থেকে আগেই বের করা ফিচার — অর্থাৎ অন্য কেউ আগেই ঠিক করে দিয়েছে ঠিক কোথায় গুরুত্বপূর্ণ। মডেল প্রস্তুত প্রমাণ পায় এবং সেগুলো নিয়ে যুক্তি করার দক্ষতা প্রদর্শন করে। কিন্তু সে নিজে কতটা ভালোভাবে প্রমাণ সংগ্রহ করতে পারে — তা প্রায় অপরীক্ষিতই থেকে যায়।
ঠিক এই ফাঁকটির দিকেই লক্ষ্য করে EviPathBench-এর কাজটি। এর লেখকরা হলেন Dankai Liao, Tianyi Zhang, Yufeng Wu, Xinyue Zhang, Qiaochu Xue, Zeyu Liu, Dachun Zhao, Linghan Cai এবং Yueming Jin; প্রিপ্রিন্টটি arXiv-এ প্রকাশিত হয় ২১ জুলাই ২০২৬-এ, এবং ২৫ আগস্টের মধ্যে এটি ইতিমধ্যে চতুর্থ সংস্করণে পৌঁছেছে (arXiv:2607.19261, cs.CV / cs.AI)। সম্পাদনার এই ঘনত্ব নিজেই ইঙ্গিত দেয়: লেখকরা বিষয়টিকে জীবন্ত ও বিতর্কিত মনে করেন।
বেঞ্চমার্কটি কীভাবে তৈরি
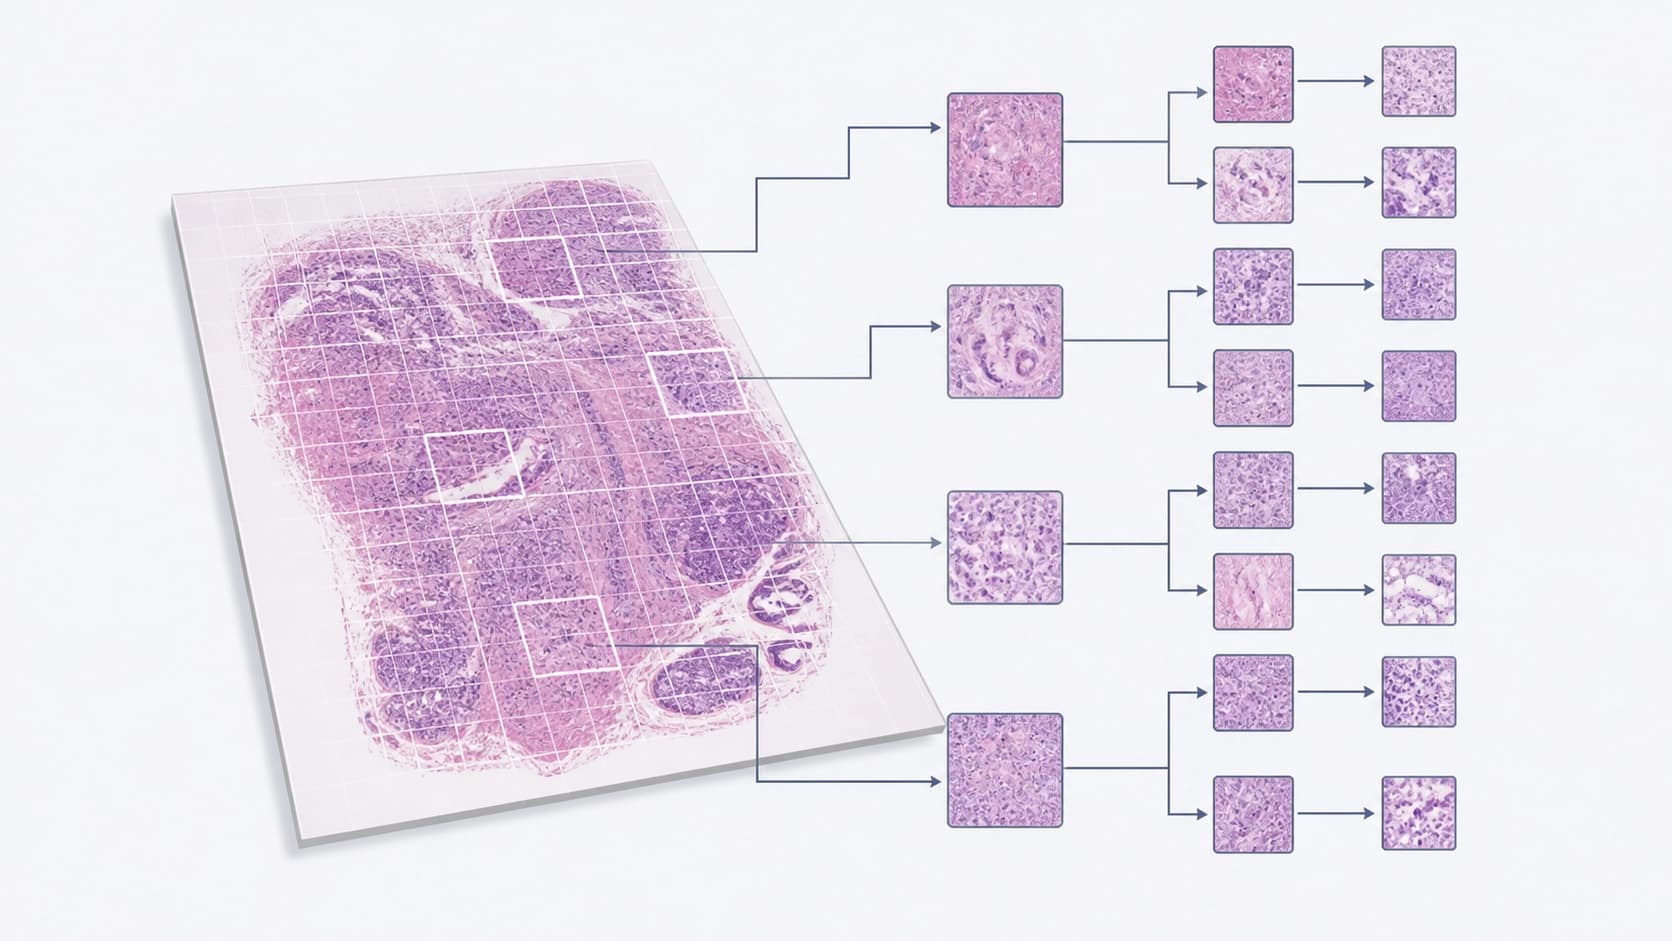
EviPathBench কয়েকটি আলাদা বহুনির্বাচনী প্রশ্নের সেট হিসেবে নয়, বরং একটি ডায়াগনস্টিক ট্রি হিসেবে গঠিত। বিভিন্ন বিবর্ধনে পরস্পরের ভেতরে অবস্থিত অঞ্চলগুলো নির্দিষ্ট স্কেল-সংশ্লিষ্ট পর্যবেক্ষণের সঙ্গে যুক্ত, এবং শেষে — প্যাথলজিক্যাল রিপোর্ট-স্তরের রোগনির্ণয়ের সঙ্গে। মডেলের কাছ থেকে কেবল "ক্যান্সার" লেবেল দেওয়া নয়, বরং একটি শৃঙ্খল পেরোনো প্রত্যাশিত: অঞ্চল খুঁজে বের করা, সেই বিবর্ধনে পর্যবেক্ষণ বর্ণনা করা, এক স্তর উপরে ওঠা, বিভিন্ন স্কেলের মধ্যে তথ্য সমন্বয় করা এবং সেগুলোকে একটি সামগ্রিক সিদ্ধান্তে নিয়ে আসা।
চারটি পরীক্ষাযোগ্য দক্ষতা
লেখকরা স্লাইড নিয়ে কাজ করার দক্ষতাটিকে উপাদানে ভাগ করেছেন এবং প্রতিটি আলাদাভাবে মূল্যায়ন করেন:
- ছবি ও টেক্সটের মিলকরণ — প্রমাণের ব্যাখ্যা, যখন মডেল যা দেখেছে তা বর্ণনার সঙ্গে যুক্ত করে।
- ছবির প্রতি টেক্সট কোয়েরি (retrieval) — যাচাইকরণ: বর্ণনার ভিত্তিতে স্লাইডে সংশ্লিষ্ট অংশ খুঁজে বের করতে হয়।
- ডায়াগনস্টিক অঞ্চলের লোকালাইজেশন — প্রকৃতপক্ষে প্রমাণ সংগ্রহ: ঠিক কোথায় খুঁজতে হবে।
- বহুস্তরের যুক্তি — বিভিন্ন বিবর্ধনে পাওয়া পর্যবেক্ষণগুলোকে একটি একক চিত্রে সমন্বিত করা।
এই বিভাজনটি নিজেই মূল্যবান: এটি দেখায় যে "স্লাইড বোঝা" একটিমাত্র দক্ষতা নয়, বরং কয়েকটি, এবং সেগুলোর মধ্যে পার্থক্য খুব বড় হতে পারে।
ডেটা ও অ্যানোটেশন
ভিত্তি হিসেবে রয়েছে TCGA-র ১,৮২২টি WSI এবং দশজন সার্টিফায়েড প্যাথলজিস্ট কর্তৃক অ্যানোটেট করা ১৭,১৩৫টি ডায়াগনস্টিক পথ। আলাদাভাবে একটি প্রাইভেট কোহোর্ট ব্যবহার করা হয়, যেখানে স্তন ক্যান্সারের ১৯০টি স্লাইডের বিস্তারিত অ্যানোটেশন রয়েছে — এটি প্রয়োজন সম্পূর্ণ প্রস্তুতির স্বায়ত্তশাসিত অনুসন্ধান যাচাই করতে, আগ্রহের অঞ্চলটি কোথায় তা নিয়ে কোনো ইঙ্গিত ছাড়াই।
ফলাফল: যুক্তি করা যায়, খোঁজা যায় না
মূল্যায়নে ১৯টি "ভিশন-ল্যাঙ্গুয়েজ" মডেল অংশ নেয় — সার্বজনীন, চিকিৎসা-সংক্রান্ত এবং বিশেষায়িত প্যাথলজি মডেল — সঙ্গে একটি টেক্সট মডেল-রেফারেন্স, যা সূচনা বিন্দু হিসেবে প্রয়োজন।
চিত্রটি বৈপরীত্যপূর্ণ। সেরা ওপেন মডেলগুলো বহুস্তরের যুক্তিতে ৯৩%-এর বেশি নির্ভুলতা ছাড়িয়ে যায় এবং উভয় ক্রস-মোডাল মিলকরণ কাজে ৫০%-এর বেশি। মনে হয়, সবই ভালো।
কিন্তু ডায়াগনস্টিক অঞ্চলের লোকালাইজেশনে — বিপত্তি। text-guided mean IoU-তে সেরা ফলাফল ০.০৯-ও ছুঁতে পারে না। এটি একটি সাধারণ হিউরিস্টিকের চেয়েও খারাপ, যা স্লাইডের কেন্দ্রে একটি আয়তক্ষেত্র বসায়, কিছুই বিশ্লেষণ না করে। অন্য কথায়, যে মডেল টিস্যুর দিকে তাকাতে শেখা, সে এমন প্রোগ্রামের চেয়েও খারাপভাবে খোঁজে যা কোথাও তাকায়ই না।
স্কেল খোঁজাকে ভেঙে দেয়
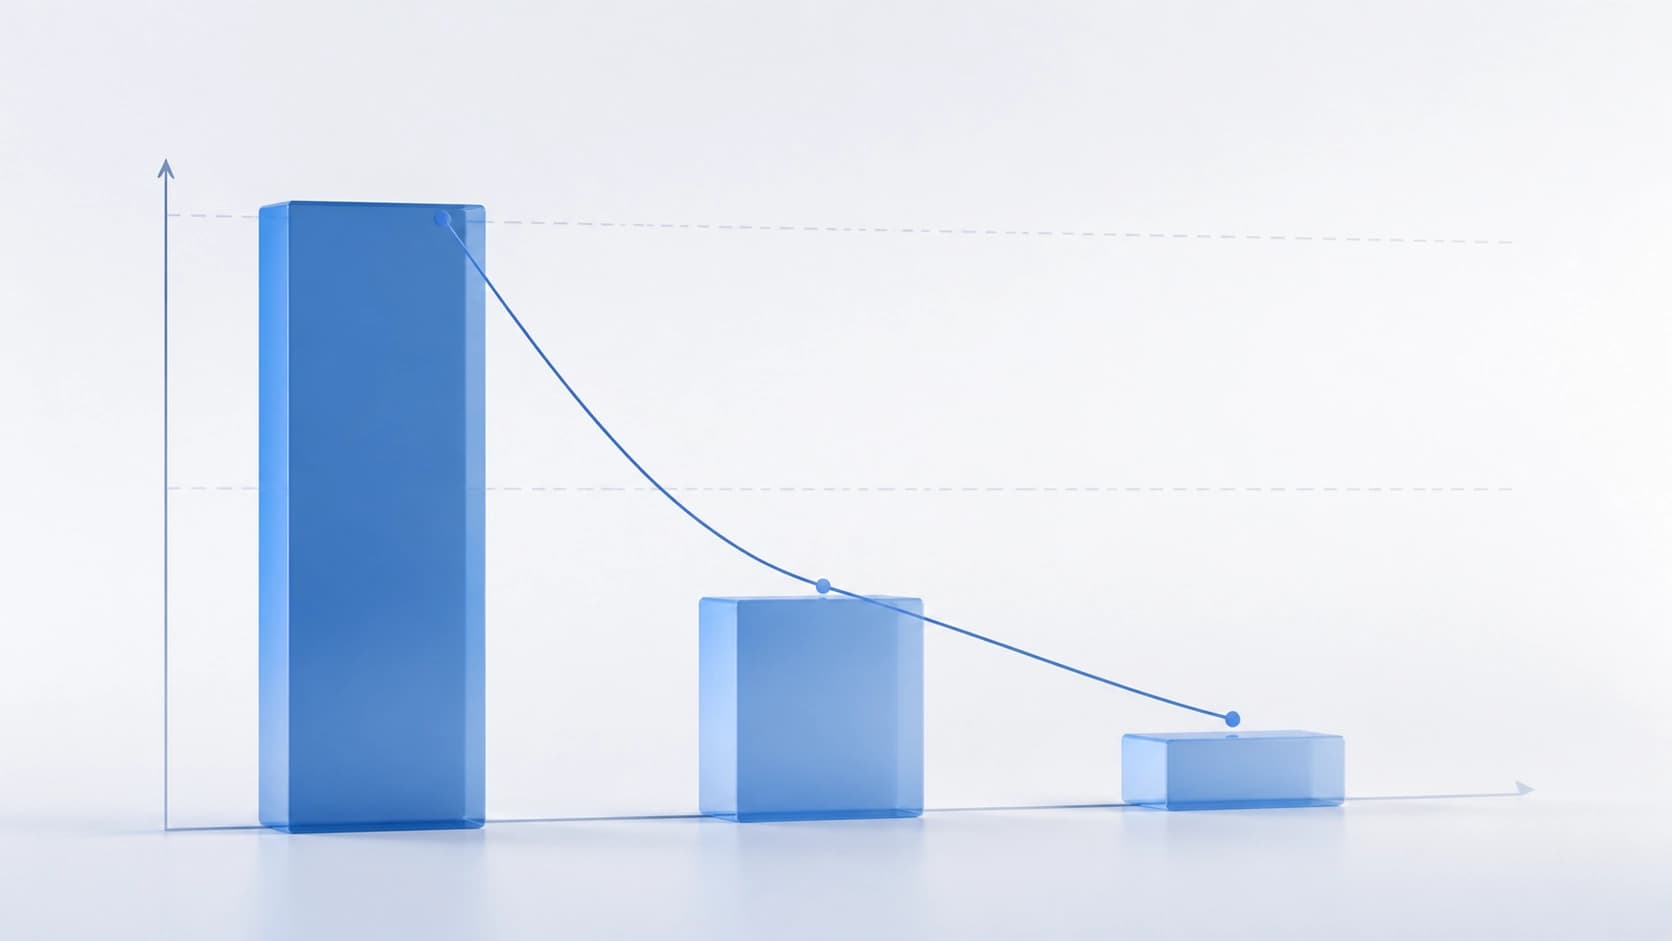
পরীক্ষার আলাদা একটি ধারা — স্লাইডের স্বায়ত্তশাসিত অনুসন্ধান। এখানে নিরঙ্কুশ hit rate বিবর্ধন বাড়ার সঙ্গে সঙ্গে ধসে পড়ে: কম বিবর্ধনে ০.৫২২, মাঝারিতে ০.১৮৫ এবং উচ্চে ০.০২০। পতনের যুক্তি স্পষ্ট: কম বিবর্ধনে মডেল টিস্যুর সামগ্রিক স্থাপত্য দেখে এবং সহজেই "কোনো সঠিক অঞ্চলে" পৌঁছে যায়, কিন্তু জুম যত বাড়ে, দৃষ্টিক্ষেত্র তত সংকুচিত হয় এবং পূর্ববর্তী ধাপের প্রতিটি ভুল তত ব্যয়বহুল হয়। ভুলগুলো জমতে থাকে, এবং সর্বোচ্চ বিবর্ধনে মডেল প্রায় নিশ্চিতভাবেই ভুল দিকে তাকায়।
এ থেকে যা বোঝা যায়
কাজটির মূল সিদ্ধান্তটি সহজভাবে বলা যায়: প্রস্তুত প্রমাণ নিয়ে যুক্তি করার দক্ষতা এবং সেই প্রমাণ সংগ্রহ করার দক্ষতার মধ্যে একটি গভীর ফাঁক রয়েছে। আধুনিক মডেলের ক্ষেত্রে প্রথমটি ইতিমধ্যে মোটামুটি ভালো হয়, দ্বিতীয়টি — প্রায় হয়ই না।
বাস্তব প্রয়োগে এর অর্থ হলো, স্লাইড নেভিগেশন এখনো মডেলের "উপর ছেড়ে দেওয়া" এবং ক্লিনিক্যালভাবে অর্থবহ ফলাফলের আশা করা যায় না। তবে বেঞ্চমার্কটি নিজেই একটি সাধারণ ফ্রেমওয়ার্ক দেয়: এটি দিয়ে উভয় দক্ষতা মাপা যায় এবং দেখা যায় কোনো নির্দিষ্ট উন্নতি — রিইনফোর্সমেন্ট লার্নিং, জুম ধাপের মধ্যে মেমরি, হায়ারার্কিক্যাল সার্চ — যে অংশটি ব্যর্থ হচ্ছে সেখানে এগিয়ে নিতে সাহায্য করে কি না।
কিছু সতর্কতাও মনে রাখা উচিত। প্রাইভেট কোহোর্টটি স্তন ক্যান্সারে সীমাবদ্ধ, এবং ডেটার মূল অংশ TCGA-র রেট্রোস্পেক্টিভ উপাদান, অর্থাৎ প্রকৃত ক্লিনিক্যাল বৈচিত্র্য সেখানে সম্পূর্ণভাবে প্রতিফলিত নয়। লোকালাইজেশন মেট্রিক্সগুলো অঞ্চলের সীমানা কীভাবে অ্যানোটেট করা হয়েছিল তার প্রতি সংবেদনশীল, এবং এক মাসে প্রিপ্রিন্টের চারটি সংস্করণ ইঙ্গিত দেয় যে সংখ্যাগুলো এখনো স্পষ্ট হতে পারে।