
SimTrace:基于匿名化真实会话和网页环境模型的合成点击轨迹
作者介绍了一种框架,可对真实交互进行匿名化,构建模拟的网页环境副本,并以此生成包含用户上下文和环境观察的多模态点击轨迹。在电子商务场景中,该方案在 8 项真实性指标中的 7 项上优于基线方法;在合成数据上训练的模型表现出与真实数据训练的模型相当的准确率,而且加入合成数据后,下一步动作预测性能提升了 +11.0%;代码已向研究人员开放。
什么是 SimTrace
SimTrace 是一个用于生成合成多模态点击轨迹的框架。它以真实用户轨迹和指定的 Web 环境为基础。论文《SimTrace: Grounded Multimodal User Trajectories Generation for Online User Modeling》于 2026年9月29日提交。作者:Yunan Lu、Shuang Xie、Meghna Allamudi、Mingyu Zhao、Han Li、Lingyun Wang 和 Zhou Yu。论文可在 arXiv 上获取:2609.38397。
关键要素:
- 生成合成多模态点击轨迹;
- 以真实用户轨迹为基础;
- 以指定的 Web 环境为基础;
- 对真实交互进行匿名化处理;
- 创建 Web 环境的模拟副本;
- 为每个动作附上 Web 环境观测和用户上下文。
实用标准:当需要合成点击轨迹时,该框架适用于互联网用户行为建模。
合成轨迹的生成方式
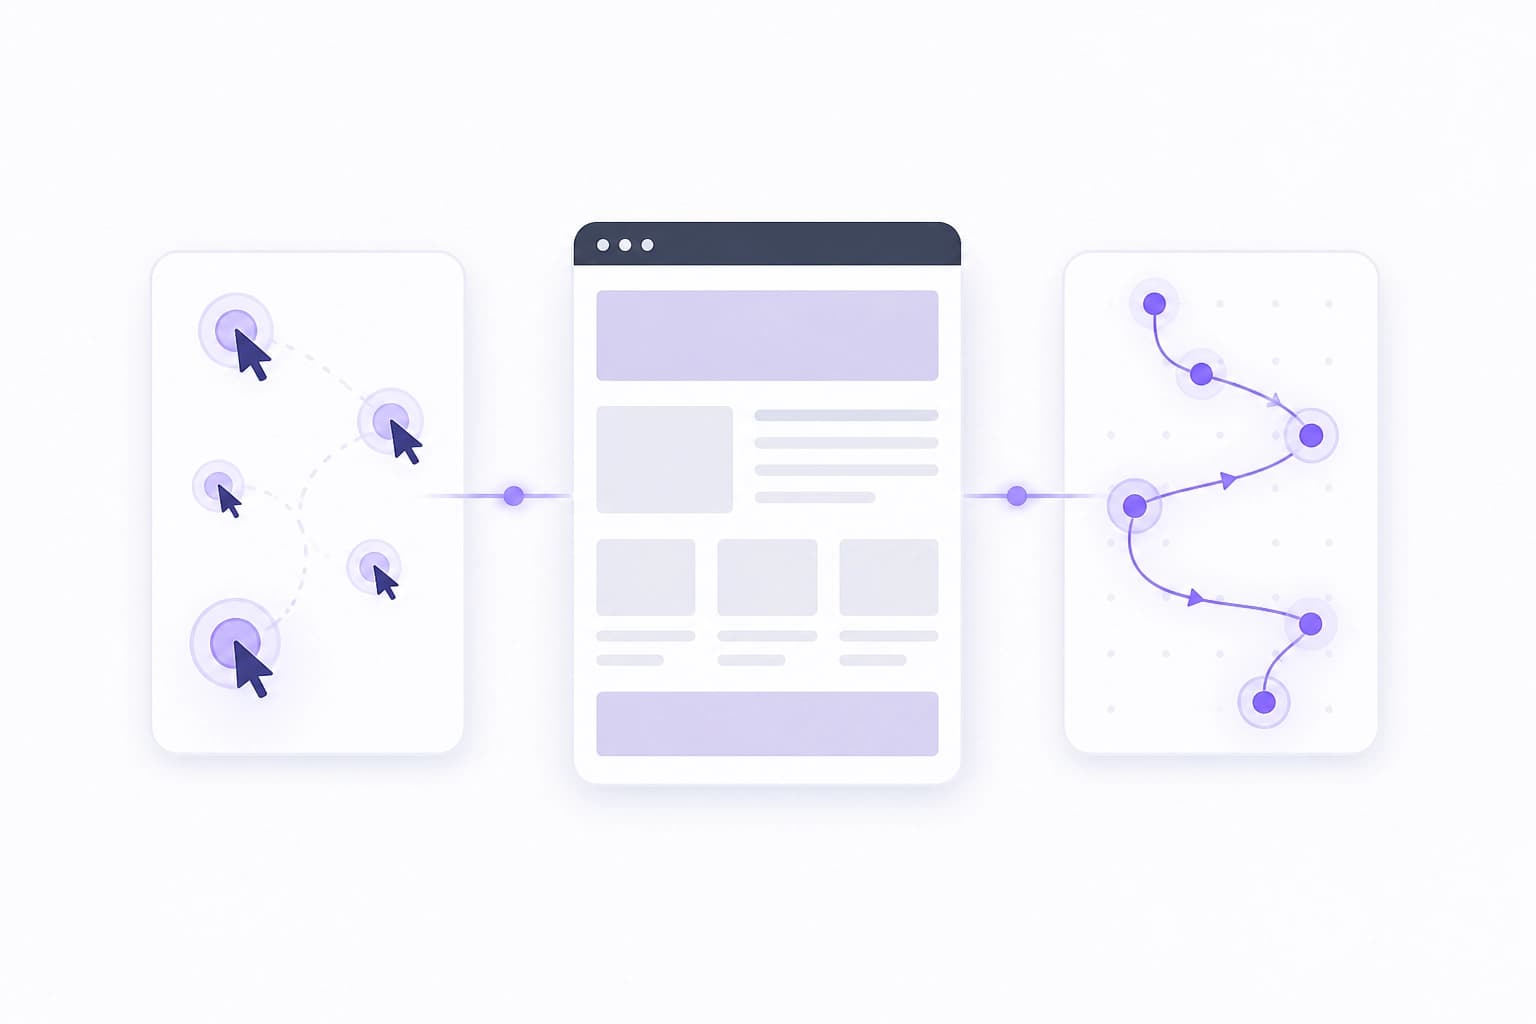
SimTrace 分多个阶段进行生成。首先,系统会对真实交互进行匿名化处理。然后创建 Web 环境的模拟副本。框架基于这些数据生成合成轨迹。轨迹中的每个动作都附有 Web 环境观测和用户上下文。
阶段:
- 对真实交互进行匿名化处理。
- 创建 Web 环境的模拟副本。
- 基于匿名化数据和环境副本生成合成轨迹。
- 为每个动作附上 Web 环境观测和用户上下文。
实用标准:启动生成需要真实的匿名化会话和 Web 环境描述。
电子商务评估
研究人员在电子商务场景中应用了 SimTrace,并评估了数据复现准确性和实际效用。在 8 项数据复现准确性指标中,有 7 项优于竞争基线方法。
结论:在电子商务场景中,该框架在大多数数据复现准确性指标上表现更优。
合成数据对模型的作用
在 SimTrace 的实验中,使用合成数据训练的模型表现与使用真实数据训练的模型相当。这适用于购买预测和推荐任务。在下一步行动预测任务中,与仅使用真实数据训练相比,将合成数据添加到真实数据中使准确率提高了 11.0%。
| 任务 | 结果 | | 购买预测 | 使用合成数据训练的模型表现与使用真实数据训练的模型相当 | | 推荐 | 使用合成数据训练的模型表现与使用真实数据训练的模型相当 | | 下一步行动预测 | 将合成数据添加到真实数据中,相比仅使用真实数据使准确率提高了 11.0% |
实用标准:合成轨迹可用于替代真实数据进行购买预测和推荐。对于下一步行动预测,建议将合成轨迹与真实数据结合使用。
开源代码与应用标准
SimTrace 以开源软件包的形式发布,用于互联网用户行为建模研究。该软件包可用于研究任务。
实用标准:当任务涉及互联网用户行为建模时,适合使用该框架。使用时需要匿名化的真实会话和指定的 Web 环境。
结论:开源代码让研究人员能够使用该框架的实现进行研究。
常问问题
相关材料
所有材料
医疗 LLM 能获知指南更新,却常常仍按旧规则回答
ChronoEvo 对 1709 项临床指南变更的研究显示:在基础模型中,90.8% 的回答记录了新变化,但只有 58.5% 完整应用了这些变化;这一差距达 32.3 个百分点,并且在 14 个模型中均存在。即使提高更新内容的显著性,也未能显著提升将新规则完整纳入临床指南的比例。
4 十一月 2026
封闭式 LLM 智能体的世界模型:在风险点进行校正
提出了 PAWM——一种外部预测器,不会重复逐步观察,而是在可能发生故障时介入,引导智能体避开错误操作。经过基于合成场景的 SFT 和 GRPO 协同训练后,该方法使 Claude Sonnet 4.5 在 ScienceWorld 和 WebArena-Lite 上分别提升了 24.3% 和 7.7%。
4 十一月 2026
SpeechLLM 上的分类头:在情感识别中,它在哪些方面优于标签生成?
基于 IEMOCAP 和 MELD,比较了紧凑型 SpeechLLM 的情感标签生成输出与基于其隐藏表示的线性分类器。分类器带来的性能提升并非普遍存在:它取决于语料库,以及使用的是参考转录文本还是 ASR 输出。
4 十一月 2026