
कॉन्फिडेंस वोटिंग आख़िर काम क्यों करती थी
बड़े भाषा मॉडल्स के इर्द-गिर्द पाइपलाइन बनाने वाले हर किसी से परिचित यह विचार सरल है: एक ही काम को कई बार समानांतर रूप से चलाओ, फिर बहुमत से जवाब चुनो। लेकिन "सपाट" बहुमत से नहीं, बल्कि भारित बहुमत से — हर रन को मॉडल के आंतरिक संकेतों के आधार पर भार मिलता है, अक्सर टोकन की लॉग-प्रायिकताओं के आधार पर। जिस विकल्प में मॉडल अधिक आश्वस्त था, वह बाक़ियों से ऊँची आवाज़ में सुनाई देता है।
एक-चरणीय तर्क के लिए यह तरीक़ा ठीक-ठाक काम करता है: अगर मॉडल ग़लती करता है, तो आम तौर पर झिझकता है, और सही जवाब के साथ उच्च आश्वासन आता है। लॉग-प्रायिकताओं का अंतर एक तरह का अंतर्निहित त्रुटि-डिटेक्टर बन जाता है, जिसके लिए न अतिरिक्त कॉल चाहिए, न लेबलिंग, न कोई अलग जज मॉडल।
टूटती वहीं है जहाँ शुरुआत हुई थी: बहु-चरणीय खोज पर
दिक़्क़त यह है कि आधुनिक एजेंट अलग तरह से बने होते हैं। वे सिर्फ़ एक पास में तर्क नहीं करते: वे क्वेरी बनाते हैं, बाहरी दस्तावेज़ लाते हैं, उन्हें संदर्भ में शामिल करते हैं, क्वेरी को परिष्कृत करते हैं और यह क्रम कई बार दोहराते हैं, जब तक अंतिम जवाब के लिए पर्याप्त सामग्री जमा न हो जाए। हर चरण मॉडल की विंडो में दूसरों के टेक्स्ट के टुकड़े जोड़ता है।
«Beyond Confidence: Test-Time Scaling for Multi-Turn Search Agents via Retrieval Grounding» (arXiv:2608.24024, EMNLP 2026 सम्मेलन के Findings में स्वीकृत) के लेखक — Hyunho Kook, Junhyuk So, Tianyu Fu, Haizhong Zheng और Beidi Chen — ने जाँचा कि इस परिदृश्य में कॉन्फिडेंस वोटिंग का क्या होता है। नतीजा अप्रिय है: एक-चरणीय कार्यों पर तराशी गई यह तकनीक खोज एजेंट्स पर ख़राब तरीक़े से लागू होती है।
विफलता का तंत्र: copy inflation
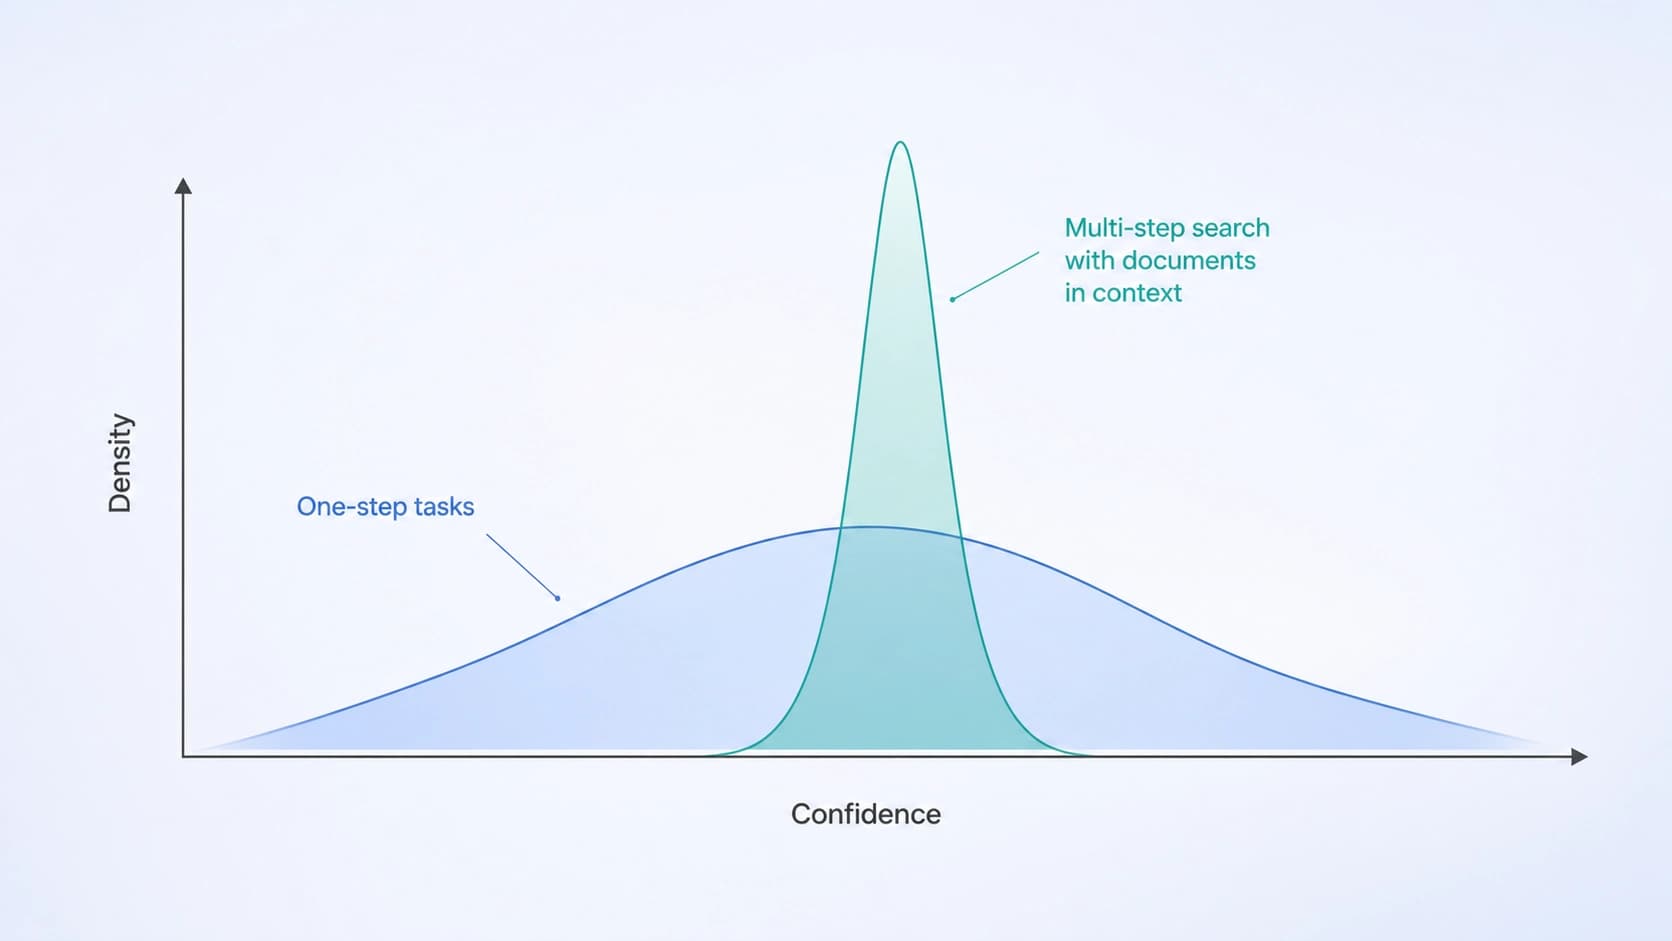
शोधकर्ताओं ने इस कारण को copy inflation — «कॉपी-आधारित फुलाव» — नाम दिया। जब निकाले गए दस्तावेज़ संदर्भ में आते हैं, तो जिन टोकनों को मॉडल इन दस्तावेज़ों से अपने जवाब में उठाता है, उन्हें व्यवस्थित रूप से बढ़ी हुई लॉग-प्रायिकताएँ मिलती हैं। कॉपी करना एक आसान काम है: जो टेक्स्ट ठीक आँखों के सामने है उसे जारी रखना, सांख्यिकीय रूप से अपना कुछ बनाने से आसान है। मॉडल ऐसे टोकन पर "आश्वस्त" इसलिए है क्योंकि वह सही है, ऐसा नहीं — बल्कि इसलिए कि वह सीधे उतारा गया है।
आगे यह प्रभाव जमा होता जाता है। चूँकि सभी रन किसी न किसी तरह मिले दस्तावेज़ों पर निर्भर करते हैं, सबको फूले हुए प्रायिकता-अंकों का अपना हिस्सा मिलता है। एक ही प्रश्न के भीतर आश्वासन के आकलन बराबर हो जाते हैं, एक संकीर्ण दायरे में सिकुड़ जाते हैं — और भारित वोटिंग वह मुख्य चीज़ खो देती है जिसके लिए वह अस्तित्व में थी: मज़बूत रन को कमज़ोर से अलग पहचानने की क्षमता। भार लगभग एक जैसे हो जाते हैं, और एग्रीगेशन साधारण बहुमत में बदल जाता है, बस अतिरिक्त गणनात्मक बोझ के साथ।
क्या पेश करते हैं: Retrieval-Grounded Voting
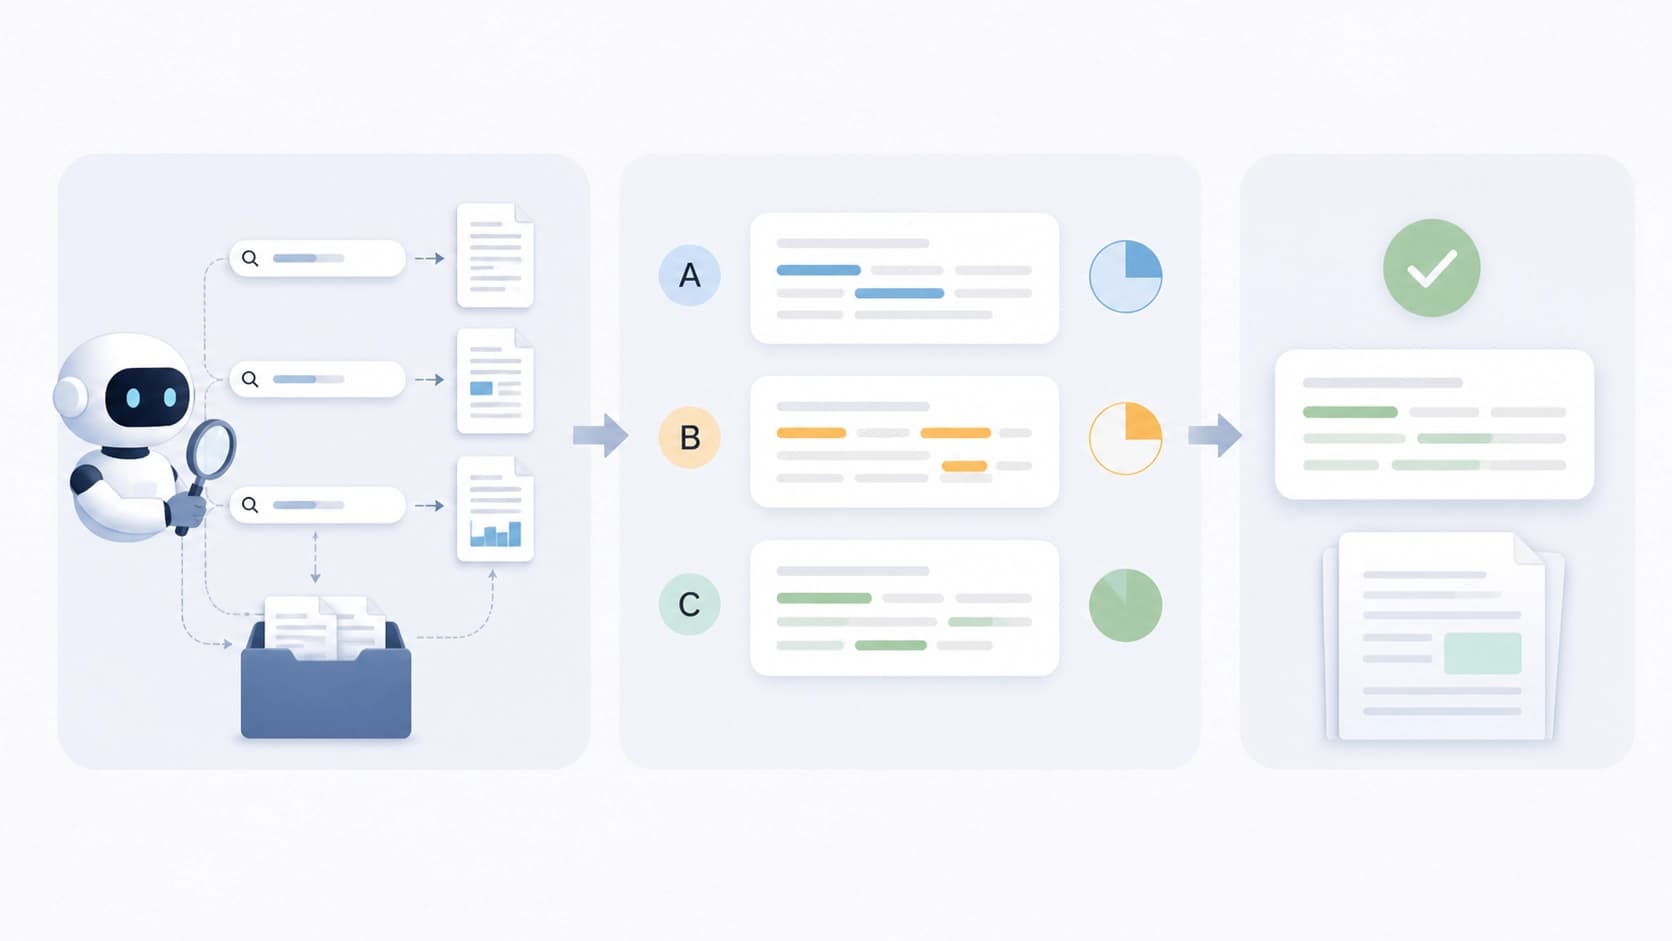
विकल्प के तौर पर लेखक Retrieval-Grounded Voting (RGV) नामक विधि पेश करते हैं। यह भी हर रन को अलग-अलग आँकता है, लेकिन देखता मॉडल के भीतर नहीं, बल्कि बाहर — अंतिम जवाब के उन दस्तावेज़ों से संबंध को, जो इस रन ने ख़ुद ही निकाले थे।
मीट्रिक जानबूझकर सरल है: जवाब के टेक्स्ट और निकाले गए स्रोतों के टेक्स्ट के बीच शाब्दिक अतिव्यापन। जवाब जितना अधिक मिली सामग्री पर टिका होगा, उसका स्कोर उतना ऊँचा होगा। जिस रन ने अपनी ओर से कुछ गढ़ लिया या भटक गया, वह अपने दस्तावेज़ों के साथ कम शब्द साझा करता है और कम भार पाता है।
यह संकेत काम क्यों करता है
तर्क यह है: अगर एजेंट ने वाक़ई प्रासंगिक पृष्ठ खोजे और उन्हीं पर निष्कर्ष बनाया, तो जवाब की शब्दावली अनिवार्य रूप से स्रोतों की शब्दावली से टकराएगी — शब्दों, नामों, वाक्यांशों में। यह शुद्धता का आदर्श लक्षण नहीं है, लेकिन वहाँ टिकाऊ है जहाँ लॉग-प्रायिकताएँ पहले ही ख़राब हो चुकी हैं।
RGV का मुख्य गुण यह है कि वह संकेत दूषित संदर्भ के बाहर गिनता है। आकलन "जवाब — दस्तावेज़" की जोड़ी पर बनता है, न कि जनरेशन के क्षण में मॉडल की स्थिति पर, इसलिए copy inflation उस पर असर नहीं डालता। साथ ही यह विधि टोकन की लॉग-प्रायिकताओं तक पहुँच और LLM को अतिरिक्त कॉलों के बिना काम चला लेती है: न कोई जज मॉडल, न कोई दूसरा पास, बस अतिव्यापन की गिनती — एक ऐसा काम जो साधारण कोड से लगभग मुफ़्त में हो सकता है।
नतीजे
प्रयोग खोज एजेंट्स के लिए चार बेंचमार्क और पाँच अलग भाषा मॉडल्स पर किए गए। तस्वीर दोहराती है: RGV लगातार कॉन्फिडेंस वोटिंग से आगे रहता है।
सबसे उदाहरणात्मक माप «minority-correct» प्रश्नों पर है, जहाँ सही जवाब आठ में से केवल एक-दो रन में आता है। यहीं कॉन्फिडेंस के आधार पर भारांकन सबसे बुरी तरह विफल होता है: फूले हुए प्रायिकता-अंक वोटिंग को भारी, पर ग़लत संस्करण की ओर खींच ले जाते हैं। ऐसे प्रश्नों पर RGV से बढ़त +35% तक पहुँचती है, और समग्र सटीकता में — +5.4% तक।
आँकड़ों को एक शर्त के साथ पढ़ना चाहिए: यह "किसी भी खोज प्रणाली की गुणवत्ता में पाँच प्रतिशत की बढ़ोतरी" नहीं है, बल्कि स्थिर मॉडल और रनों के सेट पर एग्रीगेशन प्रक्रिया का सुधार है। यानी यह विधि एजेंट में ख़ुद कुछ नहीं बदलती — वह बस एजेंट जो पहले ही जनरेट कर चुका है, उसमें से ज़्यादा सावधानी से चुनती है।
व्यवहार में इसका क्या मतलब है
अगर आप बहु-चरणीय एजेंट बना रहे हैं और पहले से self-consistency या प्रायिकताओं पर आधारित कोई भी वोटिंग इस्तेमाल कर रहे हैं, तो RGV के तीन व्यावहारिक फ़ायदे हैं:
- इन्फ़रेंस पर कुछ ख़र्च नहीं। मॉडल को अतिरिक्त कॉलों की ज़रूरत नहीं, भार तैयार जवाबों और दस्तावेज़ों के आधार पर बाद में गिना जाता है।
- बंद मॉडल्स के साथ काम करता है। टोकन की लॉग-प्रायिकताएँ हमेशा उपलब्ध नहीं होतीं, और कभी-कभी API के पीछे पूरी तरह छिपी होती हैं। टेक्स्ट की तुलना इस बाधा से मुक्त है।
- पूर्वानुमेय ढंग से डिबग होता है। मीट्रिक पारदर्शी है: देखा जा सकता है कि किन शब्दों ने मेल खाया, और समझा जा सकता है कि रन को ऐसा भार क्यों मिला।
विधि कहाँ लड़खड़ा सकती है
कमज़ोर जगह बनावट से ही साफ़ है: शाब्दिक अतिव्यापन शब्दों के मेल को पुरस्कृत करता है, अर्थ के मेल को नहीं। पुनर्लिखित पर सही जवाब को अनुचित रूप से कम भार मिलेगा; संख्यात्मक नतीजा या छोटा सार भी मूल टेक्स्ट से लगभग नहीं टकराएगा, भले ही वह पूरी तरह उसके अनुरूप हो। उलटी स्थिति और भी अप्रिय है: जो रन बस मिली सामग्री को लंबा-चौड़ा उद्धृत करता है, वह समाधान में कुछ जोड़े बिना ऊँचा स्कोर बटोर लेगा।
इसलिए समझदार रणनीति यही है — RGV को सभी संकेतों का विकल्प नहीं, बल्कि एक अतिरिक्त वोट मानना, जो ख़ास तौर पर वहीं उपयोगी है जहाँ मॉडल का आश्वासन किसी मायने में नहीं रह जाता। इसे दूसरे तरह की जाँचों के साथ जोड़ना भी तर्कसंगत है: अर्थों की तुलना, किसी अलग मॉडल से आकलन, तथ्यों के आधार पर सत्यापन। लेखक, कार्य की शब्दावली को देखते हुए, ठीक इसी दिशा में बढ़े हैं — «मॉडल की आंतरिक भावना पर भरोसा करने» से «वह वास्तव में क्या कर चुका है, उसका आकलन करने» की ओर।
निष्कर्ष
copy inflation की कहानी एजेंटिक पाइपलाइनों की एक सामान्य समस्या का अच्छा उदाहरण है: एक ही मॉडल और तर्क के एक ही चरण पर अलग-अलग तराशी गई तकनीकें चुपचाप ढह जाती हैं, जब चक्र में खोज, संदर्भ और दूसरों के टेक्स्ट जुड़ जाते हैं। मॉडल का आश्वासन शुद्धता का माप होना बंद कर देता है और कॉपी करने की सहजता का माप बन जाता है।
RGV एक बग़लिया रास्ता सुझाता है, जो लगभग उबाऊ लगता है — जवाब और स्रोतों के बीच शब्दों के अतिव्यापन की गिनती। लेकिन यही उबाऊपन विधि को आकर्षक बनाता है: यह सस्ती है, पारदर्शी है, मॉडल के भीतर तक पहुँच की माँग नहीं करती और वहाँ ठोस लाभ देती है जहाँ सही जवाब शोर में डूब जाता है। तैयार API से खोज एजेंट बनाने वाली टीमों के लिए यह उपयोगी सुधार का दुर्लभ मामला है, जिसके लिए न दोबारा ट्रेनिंग चाहिए, न इन्फ़रेंस के नए बजट।


