Por que os agentes precisavam de mais uma medição
A maioria dos benchmarks de agentes responde a perguntas claras: a modelo escolheu a ferramenta certa, montou os argumentos corretamente, chegou ao resultado desejado. Quase todas essas medições são construídas em torno da execução sequencial — uma chamada após a outra, sem pressa e sem competição por recursos.
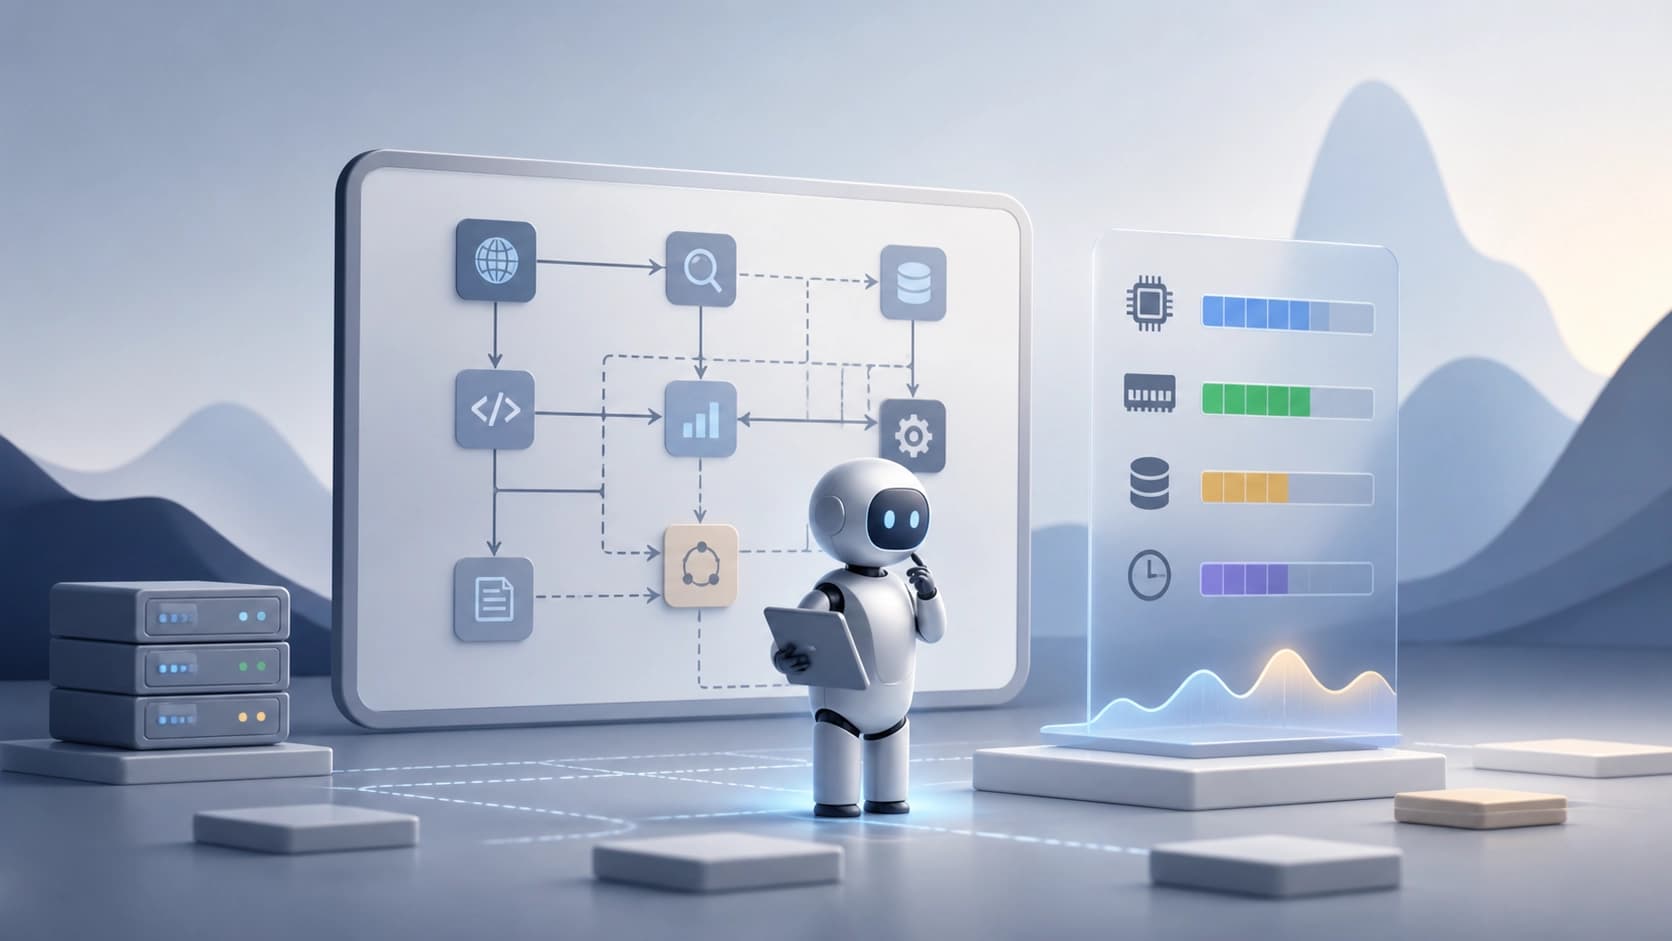
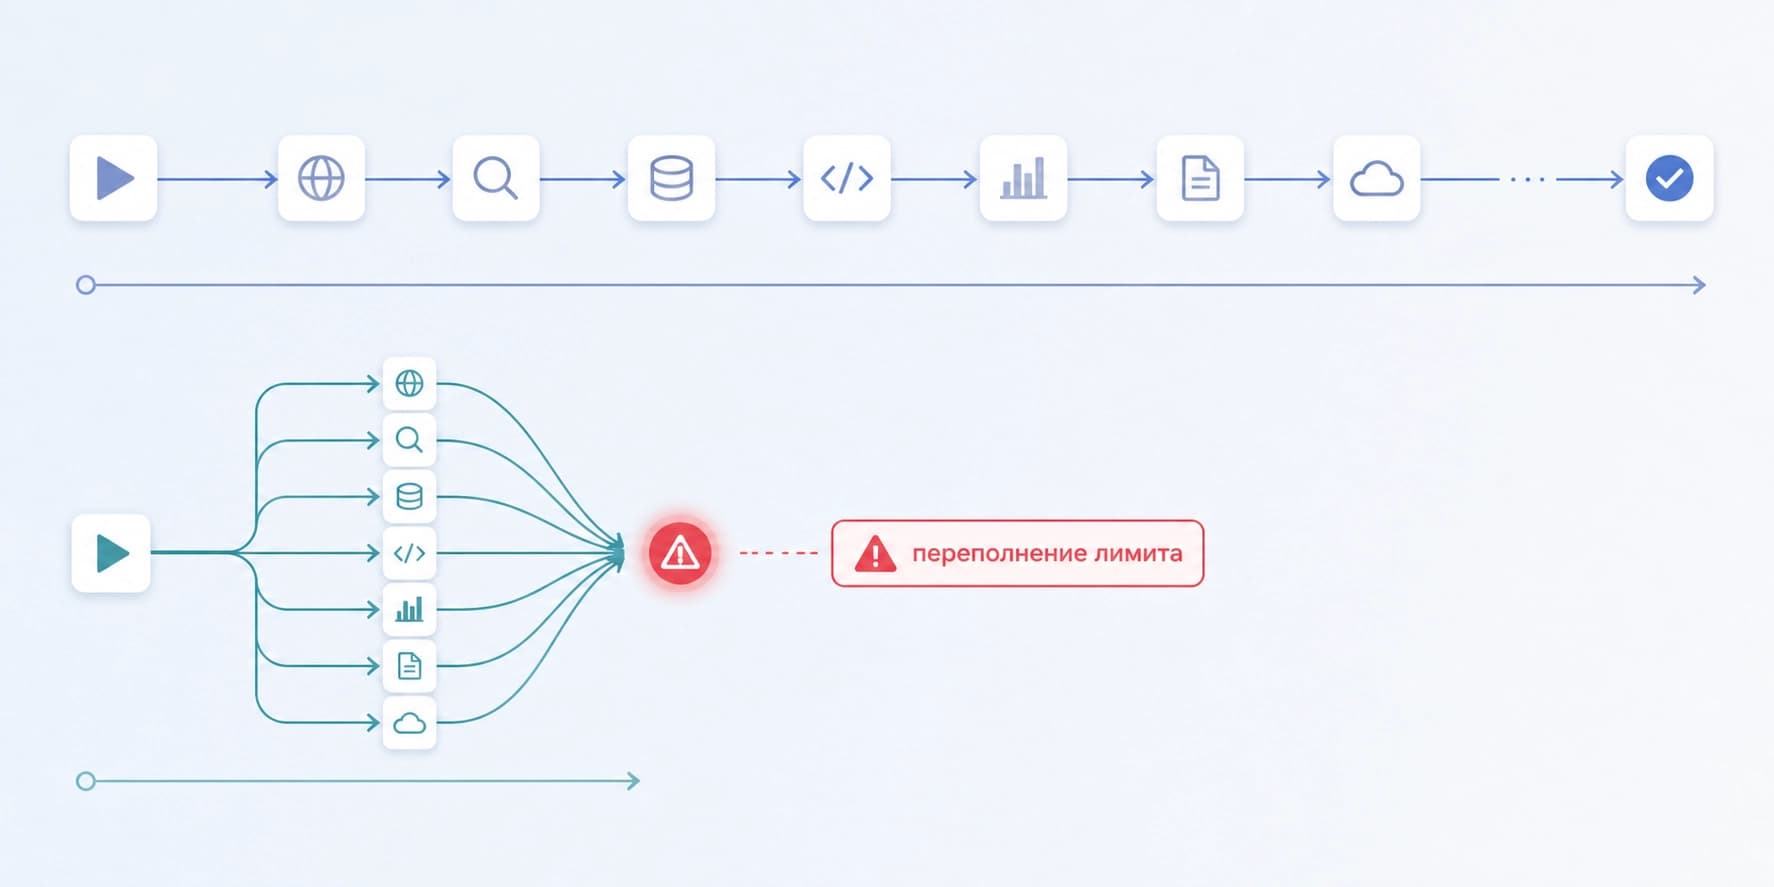
A operação real é diferente. Para caber em uma latência aceitável, o agente precisa disparar chamadas independentes em paralelo. Mas o paralelismo sem considerar os limites esbarra em outra parede: cotas esgotadas, memória sobrecarregada, serviço externo fora do ar.
O PeakBench trata justamente dessa zona cega. Os autores Zhi-Kai Chen, Xu-Xiang Zhong, Song-Yan Li, De-Chuan Zhan e Han-Jia Ye a descrevem no preprint arXiv:2608.24509 (v1 de 25 de agosto de 2026, categorias cs.AI e cs.SE); o código promete ser disponibilizado junto com o artigo.
A ideia central da qual todo o trabalho nasce: um agente tem duas formas de falhar, e elas são opostas. A execução sequencial é segura, mas lenta — os limites não são excedidos simplesmente porque nada acontece ao mesmo tempo. O paralelismo sem considerar recursos é rápido, mas leva a sobrecargas que poderiam ser facilmente evitadas. É entre esses polos que está aquilo que ninguém mediu de verdade.
O que é o benchmark
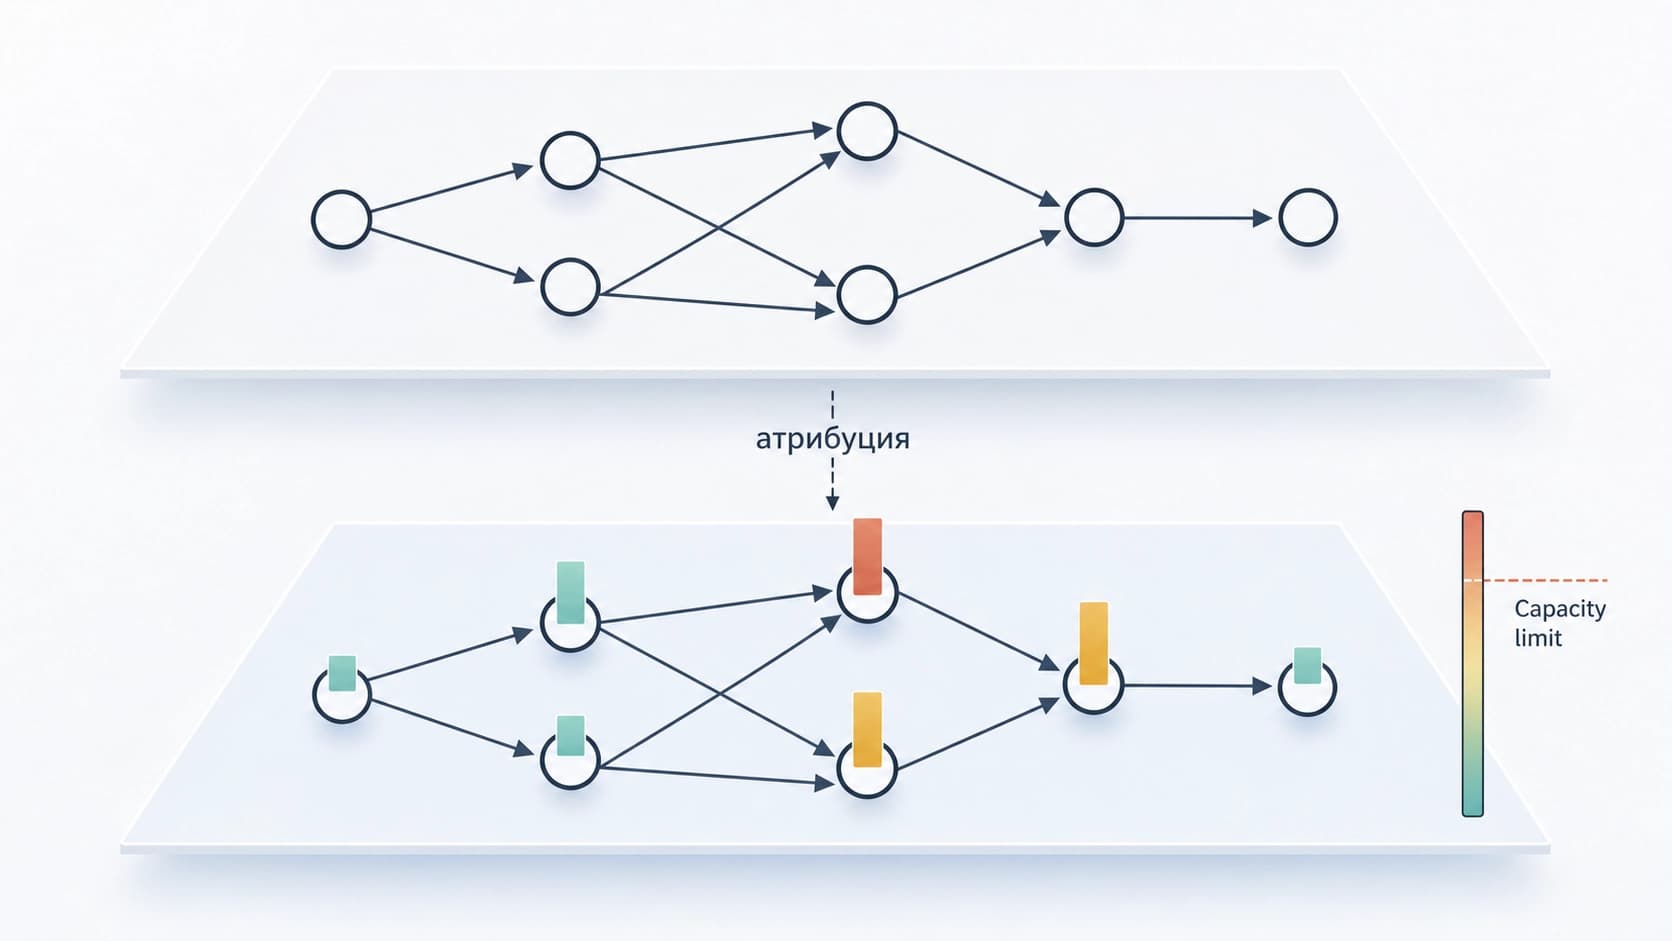
Em vez de tarefas estáticas com respostas de referência, aqui são usados fluxos de trabalho executáveis com múltiplas ferramentas. Cada um tem dois anexos importantes: anotações de dependências, mostrando quais etapas estão de fato conectadas entre si, e perfis de recursos medidos — quanta memória, tempo ou cota uma chamada específica consome.
Essa construção muda o próprio objeto da avaliação. A pergunta "a resposta saiu correta" passa para segundo plano, e a pergunta "como o agente distribuiu o trabalho no tempo e não estourou o orçamento" ganha destaque.
Planejamento lógico versus físico
A dificuldade central ao avaliar esses processos é a atribuição. Quando uma execução desanda, não fica claro o que exatamente é o culpado: o agente interpretou as dependências incorretamente, ou as interpretou corretamente mas não considerou os recursos disponíveis, ou ambas as coisas ao mesmo tempo. Jogar tudo em uma única métrica de sucesso significa perder o mais útil.
Por isso a avaliação é dividida em duas partes. Uma dimensão responde pelo planejamento lógico: a ordem das etapas, a correção das dependências, a ausência de conexões inventadas. A outra — pelo planejamento físico, ou seja, pelo cronograma considerando as restrições reais. As métricas dessas dimensões são próprias, e uma falha em uma não mascara o sucesso na outra.
Ordem errada e orçamento errado são doenças diferentes
O esquema em duas partes não serve para uma taxonomia bonita, mas para o diagnóstico. Se o agente errou no nível da lógica, não adianta falar sobre o tamanho da cota — ele não entendeu o que depende do quê. Se a lógica está em ordem e a execução falha, o problema está no planejador ou em como os recursos disponíveis foram comunicados ao agente.
A conclusão prática para quem desenvolve sistemas de agentes: antes de consertar qualquer coisa, vale entender a qual das duas camadas pertence a falha. Engenharia de prompt, treinamento em trajetórias e ajuste de ferramentas vão tratar problemas completamente diferentes.
Resultado principal: lógica impecável não salva da sobrecarga
A conclusão mais incômoda do trabalho soa assim: um planejamento lógico forte não garante nem execução segura, nem eficiente em condições de restrição de recursos. O agente pode construir um grafo de dependências impecável — e ainda assim derrubar o sistema, disparando de uma vez tudo o que não está ligado por arestas.
A transparência sobre recursos reduz o número de sobrecargas evitáveis
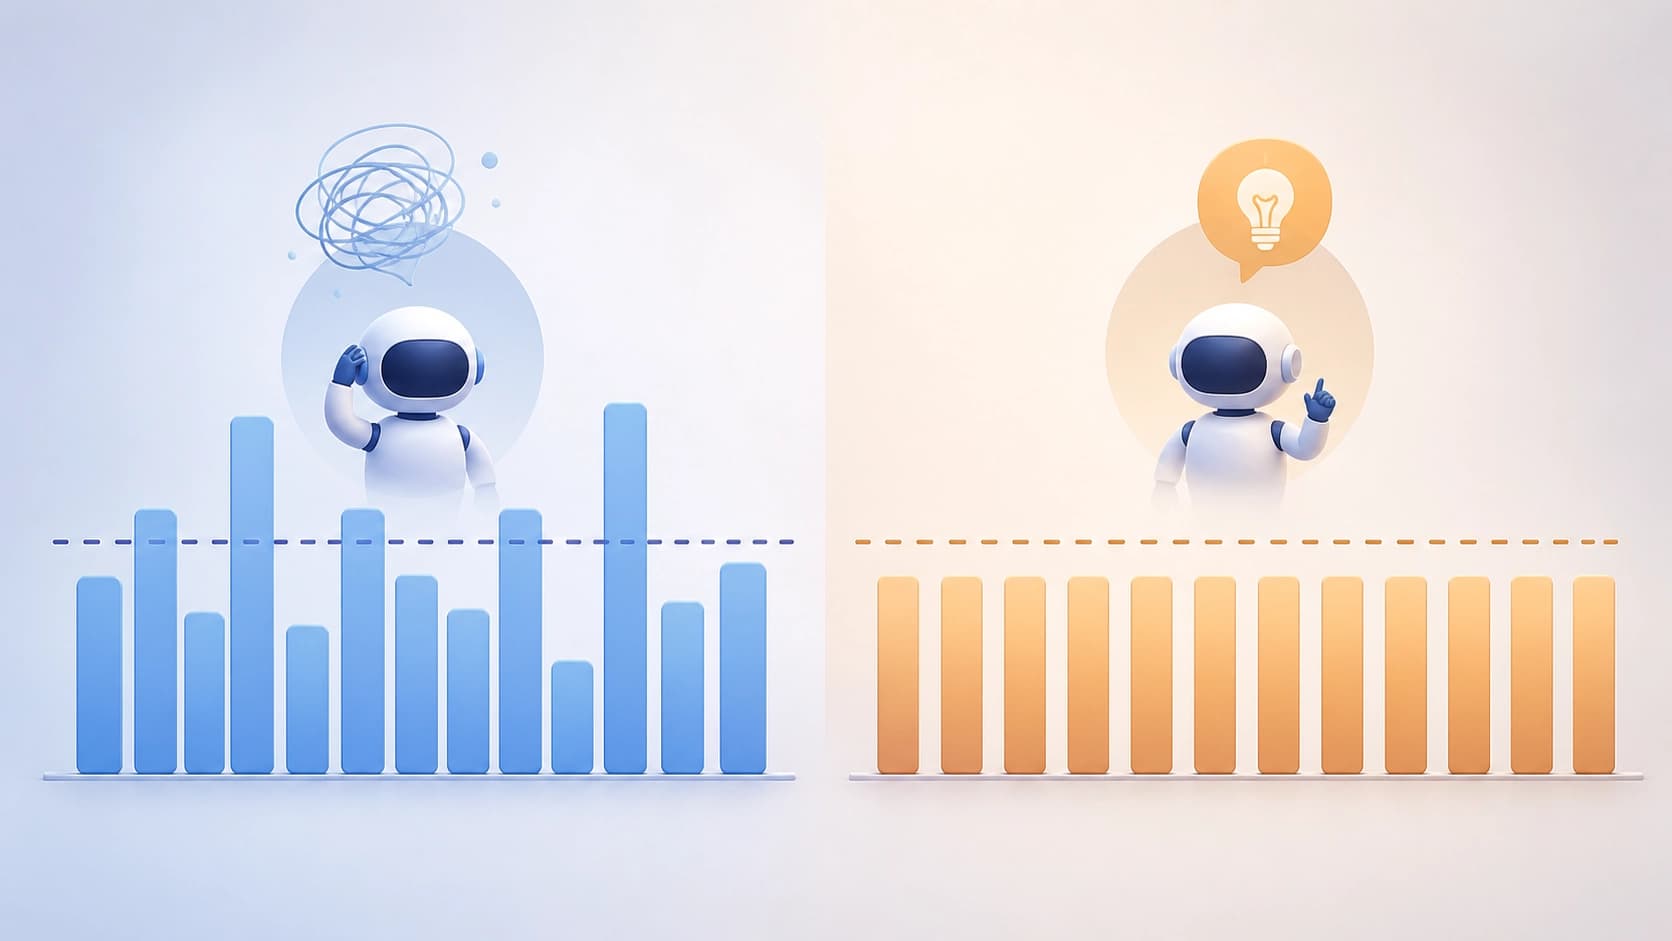
A segunda observação: se o agente receber informações sobre os recursos disponíveis, o número de sobrecargas evitáveis cai e a utilização aumenta. Isso não é mágica nem uma nova arquitetura — simplesmente entram no contexto não apenas as descrições das ferramentas, mas também os orçamentos que precisam ser respeitados.
Aqui é importante não superestimar o efeito. Trata-se de que a transparência sobre recursos é uma intervenção barata e funcional, e não de que ela resolve o problema por completo: o agente ainda precisa usar essa informação com competência.
Para quem isso é útil
O benchmark foi concebido como uma bancada para diagnosticar o comportamento de agentes ciente de recursos, e esse é seu propósito principal. Ele não tanto atribui uma nota final, mas mostra onde exatamente o modelo quebra: na compreensão das dependências ou na disciplina de gastos.
Daí surgem vários cenários de uso. Para desenvolvedores de frameworks de agentes — uma forma de testar o planejador antes da produção, e não depois do incidente. Para pesquisadores — uma configuração reproduzível para experimentos com orçamentos no contexto. Para quem escolhe um modelo para uma tarefa com limites rígidos — a possibilidade de ver a diferença entre modelos que os testes comuns de sucesso simplesmente não mostram.
O que vale ter em mente
A abordagem tem um custo de entrada óbvio: os perfis de recursos precisam ser medidos, e as dependências — anotadas. Em sistemas reais, os limites são ruidosos, os serviços externos mudam de comportamento sob carga, e o custo de uma chamada nem sempre é conhecido de antemão. O rigor de laboratório aqui é maior do que em campo, e não vale transferir as conclusões diretamente para a produção.
Mas o próprio arcabouço é útil mesmo sem o benchmark. Duas perguntas — "o agente entendeu corretamente o que depende do quê" e "ele respeitou o orçamento" — é razoável fazer a qualquer sistema de agentes, mesmo que não se tenha à mão uma bancada pronta para verificá-las.