为什么“告诉我它在哪”是个错误的问题
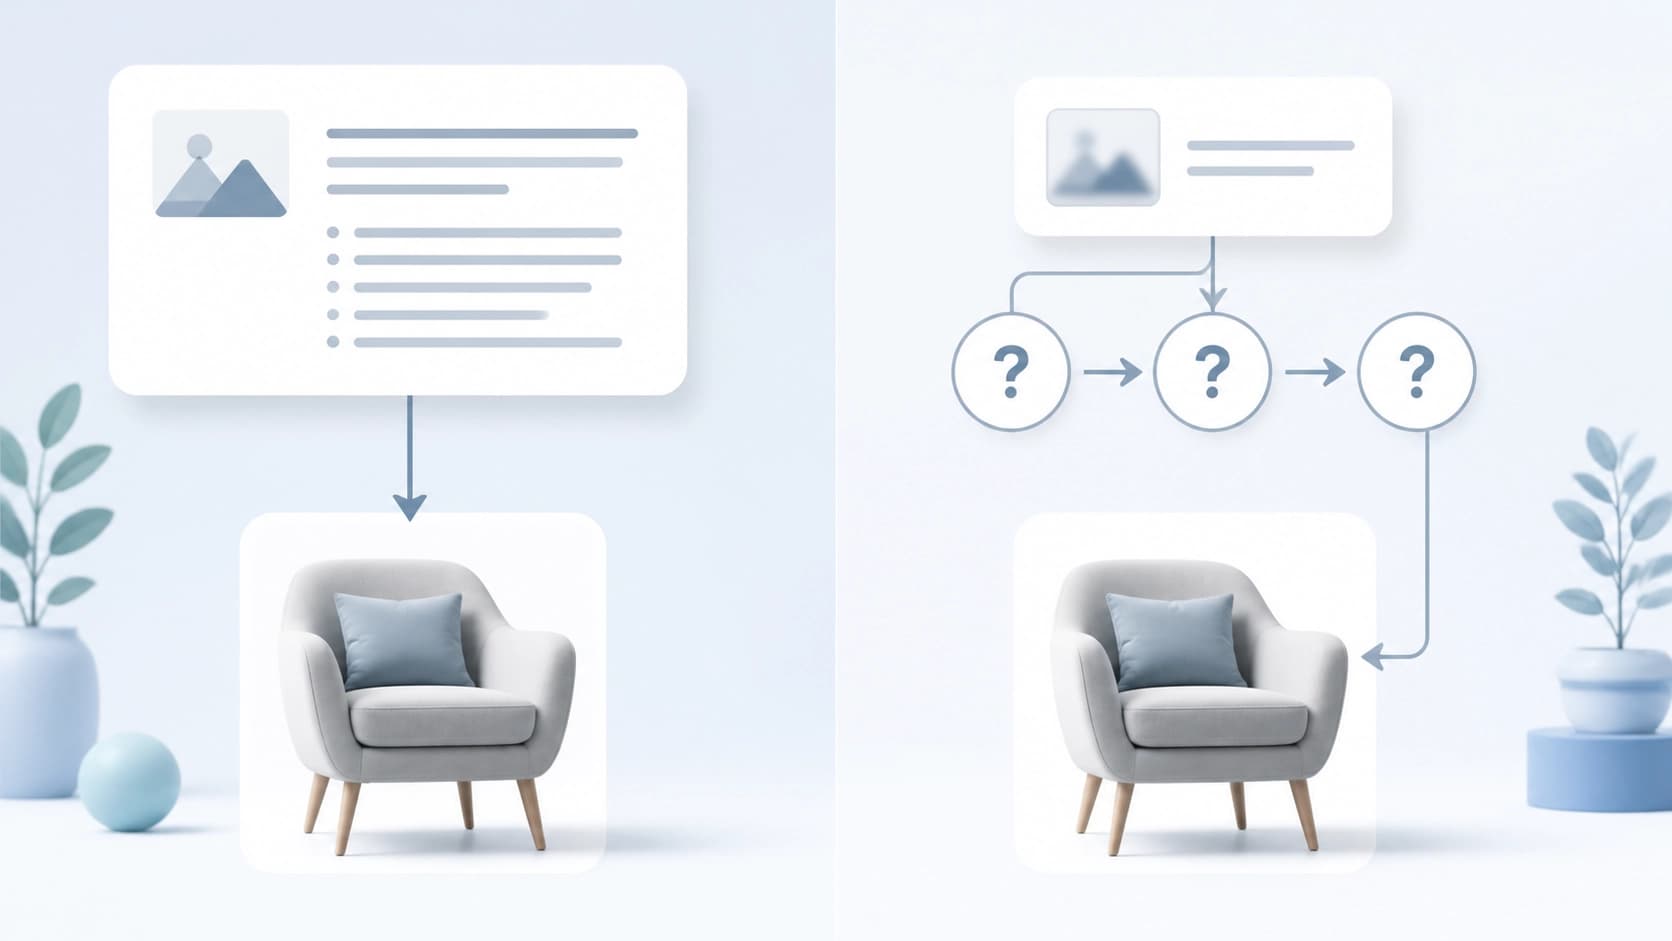
经典的视觉定位测试看起来几乎像小学题目:给出一张图片和一句类似“下层架子上的蓝色文件夹”的话,模型需要指出目标物体所在的位置。一次提问,一次回答,指标——找对了还是没找对。
这个方案很方便,但它描述的不是对话,而是命令。在真实的交流中,人很少第一次就给出详尽无遗的描述。他会说“就是窗户旁边那个东西”,并指望对方要么猜出来,要么追问。相互理解是在对话过程中逐步建立起来的——有时两轮就够,有时要五轮。
arXiv:2608.23978 这篇论文的作者(Zhengxiang Wang 和 Owen Rambow,文章已被 EMNLP 2026 接收)提议把这个被忽略的环节本身作为测量对象。他们的问题是:当图片和词语不足以得出唯一结论时,模型是否不仅会看,还会提问。
实验是如何设计的
可控的信息缺失
核心思路不是测量“平均”准确率,而是平滑地调节:关于目标的信息事先给出了多少,又有多少必须由模型自己获取。在标尺的一端,任务与普通的单步测试几乎无异:描述详细,目标显而易见。在另一端,则完全没有初始表述,模型关于目标物体所知道的一切,都必须从它自己提出的追问中挖掘出来。
这样的设计能够把识别能力与对话能力区分开来。一个能根据精确提示完美找到物体的模型,当提示需要一点一点拼凑出来时,可能会彻底失败。
四种情境与四种协议
实验环境依托于四种贴近人类场景的视觉情境,以及四种不同的交互协议。这一点很重要:结果不能归结为某一种成功或失败的配置。同时还检验了描述究竟由谁来表述——是人还是另一个模型,以及推理量、重试次数和更换描述提供方会带来怎样的影响。下文提到的规律在所有这些变体中都得到了复现。
究竟在哪里出问题
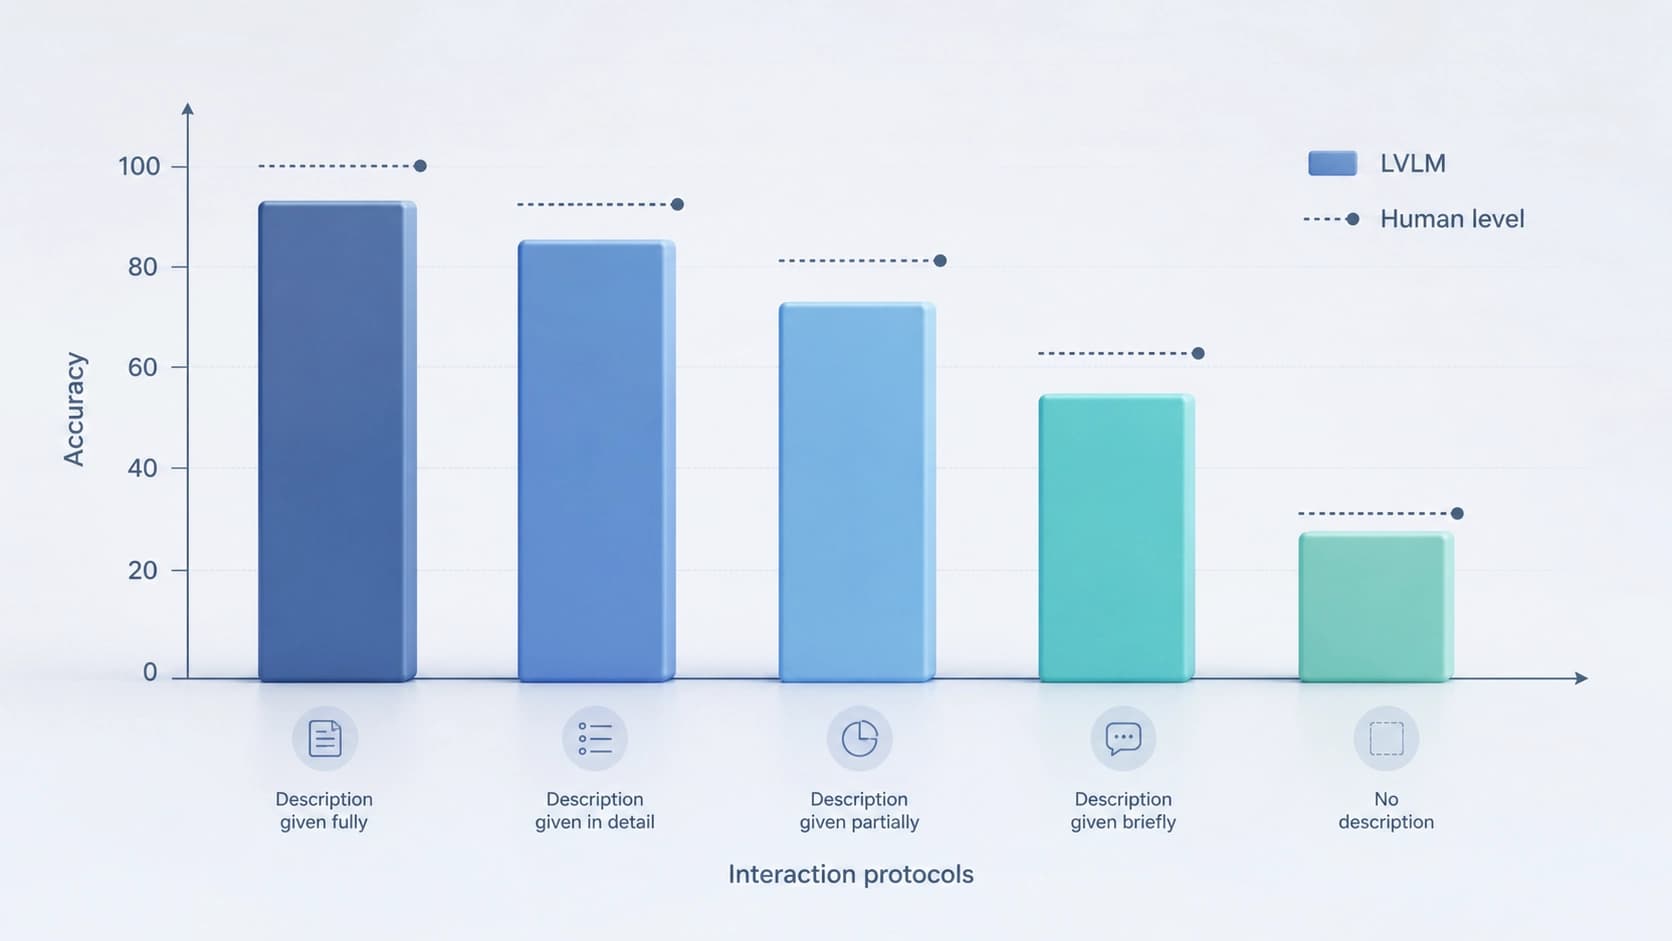
与人类的差距在所有协议中都存在
主要结论并不乐观:在任何一种模式下,当前的大型视觉语言模型都未能接近人类基线水平。无论任务看起来几乎微不足道,还是需要真正的对话,差距都依然存在。这不是几个百分点的差距,而是可靠性上的质的差异。
最糟的情况——完全没有描述时
最低的结果出现在目标初始表述缺失的场景中。模型必须自己构建关于要找什么的假设,提出问题,并根据回答缩小搜索范围。这已经不是识别,而是主动行为:需要自己判断信息不足,并组织出一个能填补这一缺口的请求。
正是在这里,暴露出论文标题所指出的失败:模型会看,却不会问。它要么押注于猜测,要么提出一些什么也澄清不了的问题。
追问有效,但并非总是有效
交互并非毫无用处。当追问对初始描述进行修正或补充时,准确率会明显上升。也就是说,模型中的对话机制是存在的,并且能带来好处——但仅限于充当他人表述的编辑者这一角色。一旦表述需要从零开始创建,这一优势就消失了。
信心跑在准确率前面
另一条分析线索是校准。模型系统性地宣称高于其实际准确率所支持的信心。实际而言,这意味着无法根据模型的回答判断是否值得信任它:正确和错误的选择都伴随着同样笃定的语气。
对应用来说,这比单纯的错误更危险。如果系统会犯错,但诚实地发出不确定的信号,还可以追问它或叫人来处理。如果它带着确信的样子犯错——就无法嵌入这样的保险机制。
为什么这个任务比看起来更难
交互式视觉定位需要三种机制同时运作:
- 视觉匹配——把词语与图像中的物体联系起来,包括空间关系和属性;
- 信息检索——弄清缺少哪些信息,并通过提问而非穷举来获取它们;
- 综合——把零散的回答汇聚成一个统一的假设,并且中途不丢失它。
每一项技能单独来看,现代模型或多或少都具备。出问题的是它们之间的衔接:看到的东西没有转化为问题,而对问题的回答也没有重塑对世界的认知。
这在实践中意味着什么
如果你正在基于多模态模型构建产品——比如 GPT-4o 或任何其他支持图像的 API——这篇论文的结论很容易转化为工程方案:
- 不要依赖第一次描述。 如果用户的表述含糊,就应设计一个追问循环,而不是单次问答。
- 不要相信模型宣称的信心。 校准最好基于针对具体任务的自行标注,而不是模型的自我评估。
- 替模型设计问题。 如果系统自己无法判断缺少什么,那么提问者的角色就得由外部逻辑层来承担。
- 在自身的信息缺失场景中测试。 值得检验一下,流水线在作者数据所显示准确率会崩掉的那些模式下表现如何。
结语
这篇论文记录的不是能力的缺失,而是技能之间的不匹配。模型看得足够清楚,能够回答提得好的问题,但对情境的理解还不足以自己提出问题。在这个差距被弥合之前,交互式视觉定位仍将是一项人类始终是对话中最可靠一环的任务。