为什么不存在放之四海而皆准的单一策略
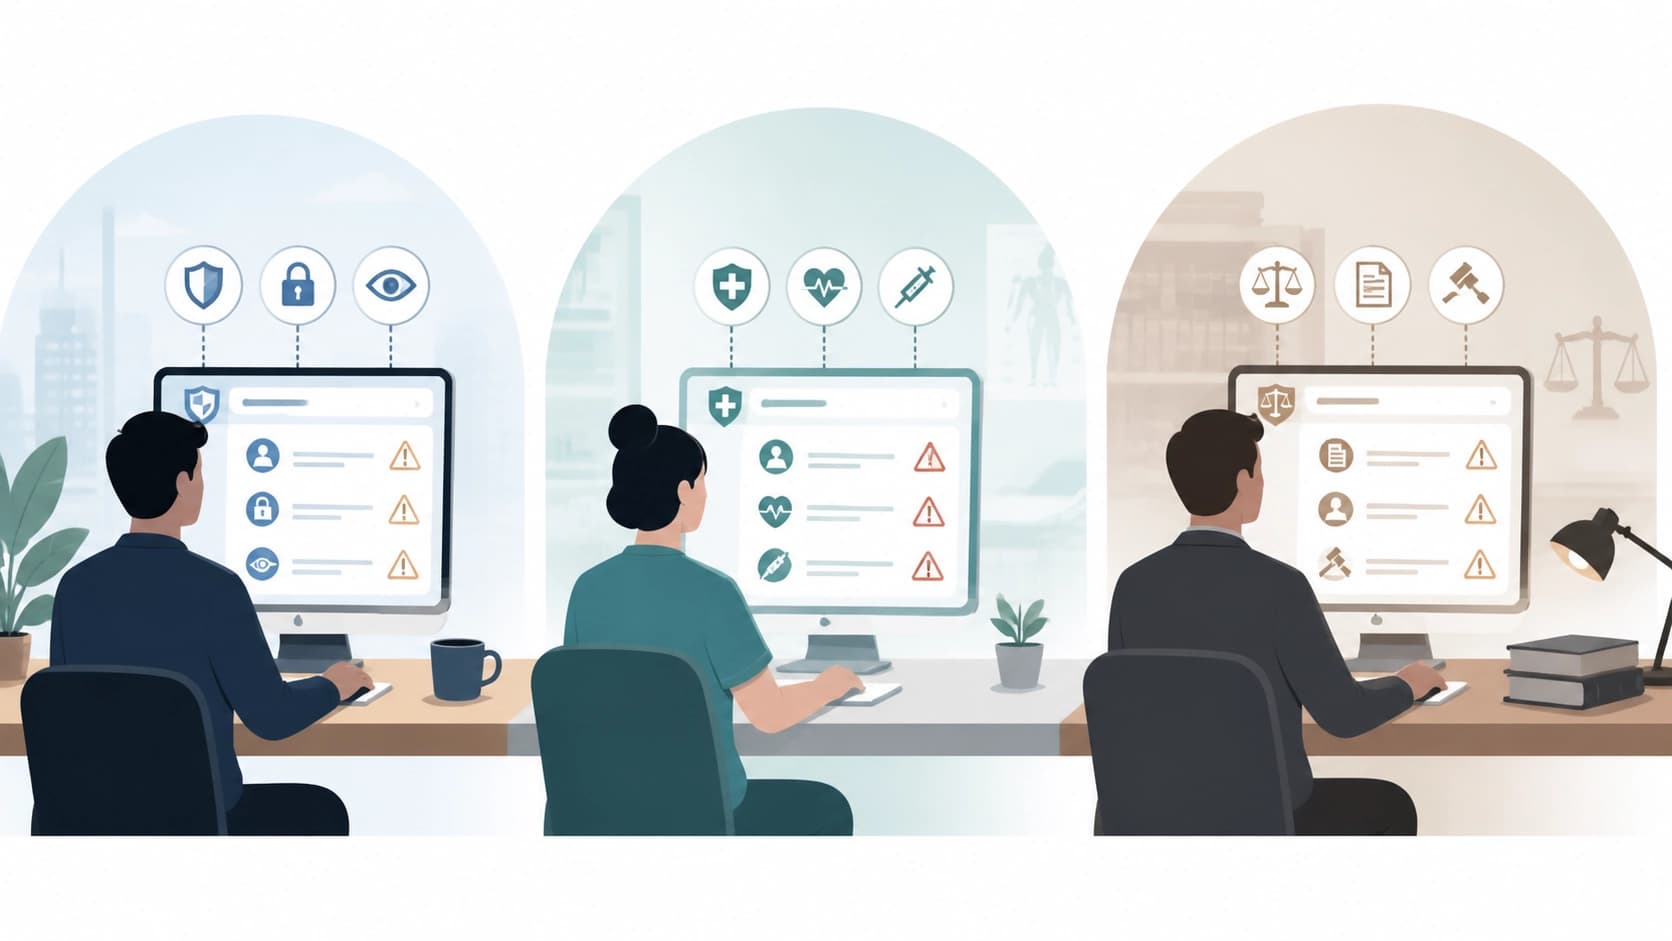
生成式AI进入的机构千差万别,各自面临的风险也不尽相同。银行担心客户数据泄露和错误的财务建议,诊所担心不准确的医疗建议,学校担心与青少年对话中出现不良内容。再加上行业的监管要求、公司内部的价值观,以及坐在聊天窗口另一端的究竟是谁:普通员工、承包商还是外部用户。
由此得出一个不太方便的结论:针对GenAI的统一安全模板行不通。配置必须针对具体场景来调整,而不能照搬手册。
第二个问题是工具层面的。以往的策略规范机制都是围绕访问控制发展起来的:它们回答的是"谁有权访问哪些资源"。但在使用生成式模型的应用中,另一个问题重要得多——回答里究竟可能出现什么内容。与内容相关的限制,很难用角色和权限的术语来描述,而正是在这个衔接处,通常就开始出现无法规模化的人工操作。
Granite.Trust 提出了什么
这套工具集在 arXiv:2608.23870 预印本中有所描述,属于 cs.AI 分类。材料于2026年8月24日提交,作者包括 Nathalie Baracaldo、Nicolas Mello、Kush R. Varshney、Heiko Ludwig、Kate Soule 和 David Cox,共六人。源文件体积约为2.7 MB,对于一篇带有工具的文章来说,这说明背后有相当实在的代码库,而不仅仅是一个概念。
作者主要提出了两点。
Actionable Policy:将策略作为可编辑文档
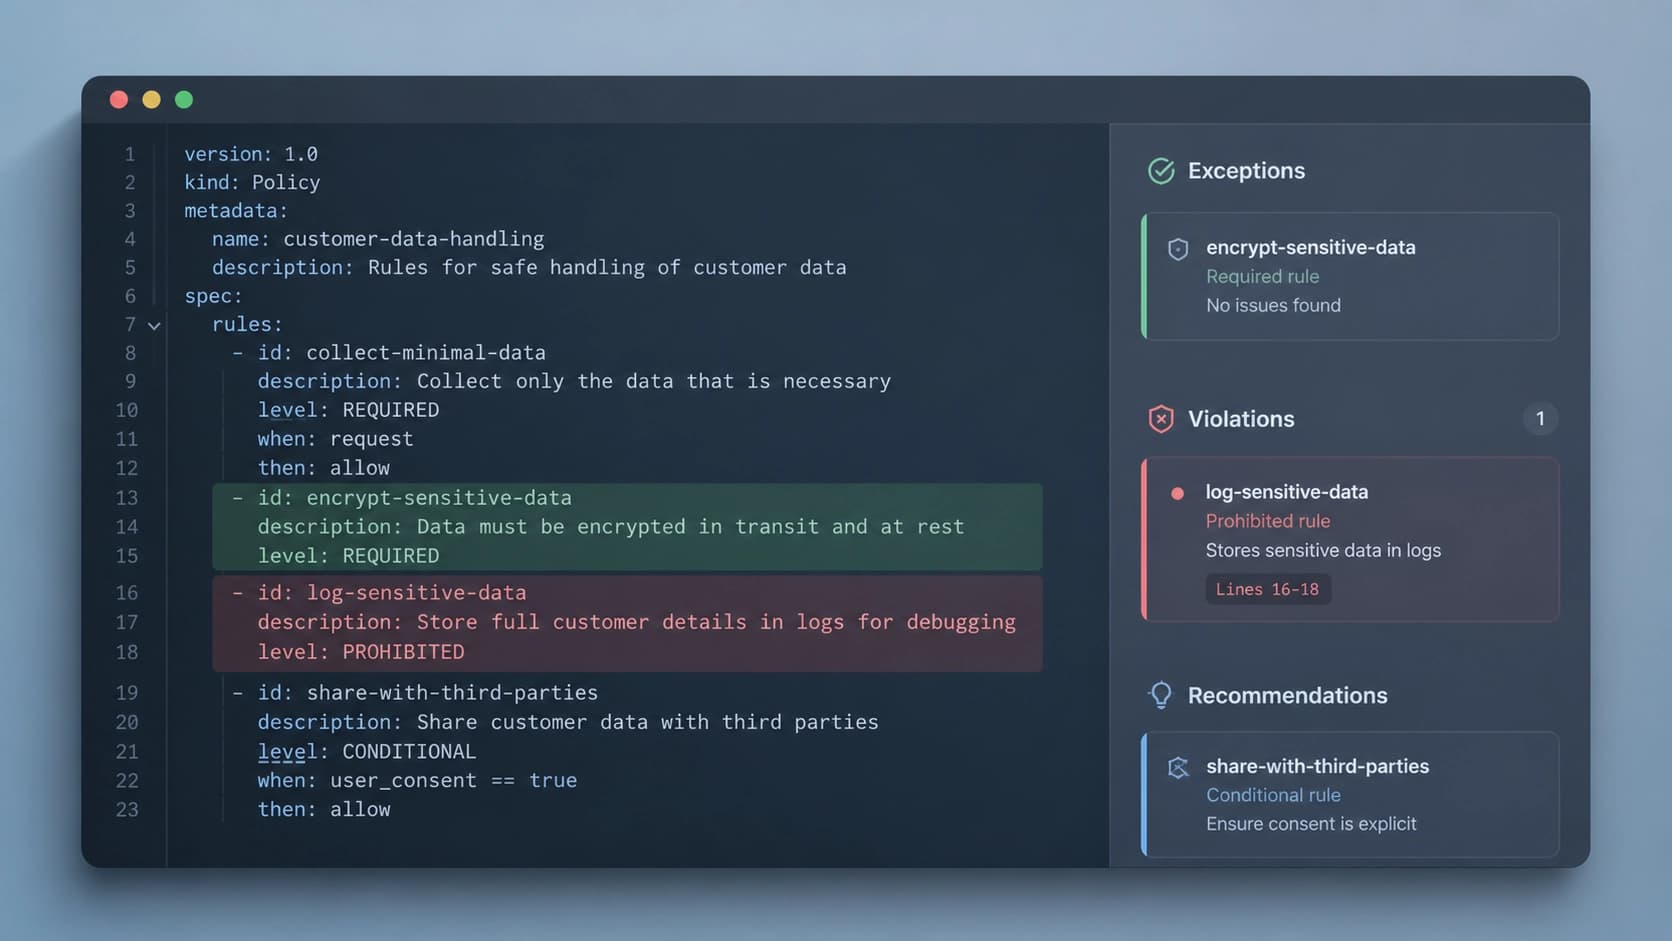
第一点是 Actionable Policy 方案,一种基于 YAML 的格式。它不是抽象的"安全指南",而是对模型哪些回答可接受、哪些不可接受的机器可读描述。关键细节在于基于例外的管理:规则带有明确的例外条款,正是这些条款让违规情况可以被追踪。简而言之,团队不仅得到了一份禁止清单,还获得了一种机制,用来弄清模型究竟在哪里越了界、以及为什么。
用于验证策略的合成数据
第二点是合成数据生成流水线。它会生成与前述策略相一致的学习样本,这些样本有两个用途:模型对齐和模型测试。此外还有一套工具,帮助设计策略方案本身,并在之后监控规则的遵守情况。
这里的逻辑是合理的:如果策略独立于训练模型所用的数据而存在,它就只是一纸声明。而当"可以这样"和"不可以这样"的样本从策略中自动生成出来时,要求就变成了可验证的东西。
一次设定,贯穿整个生命周期
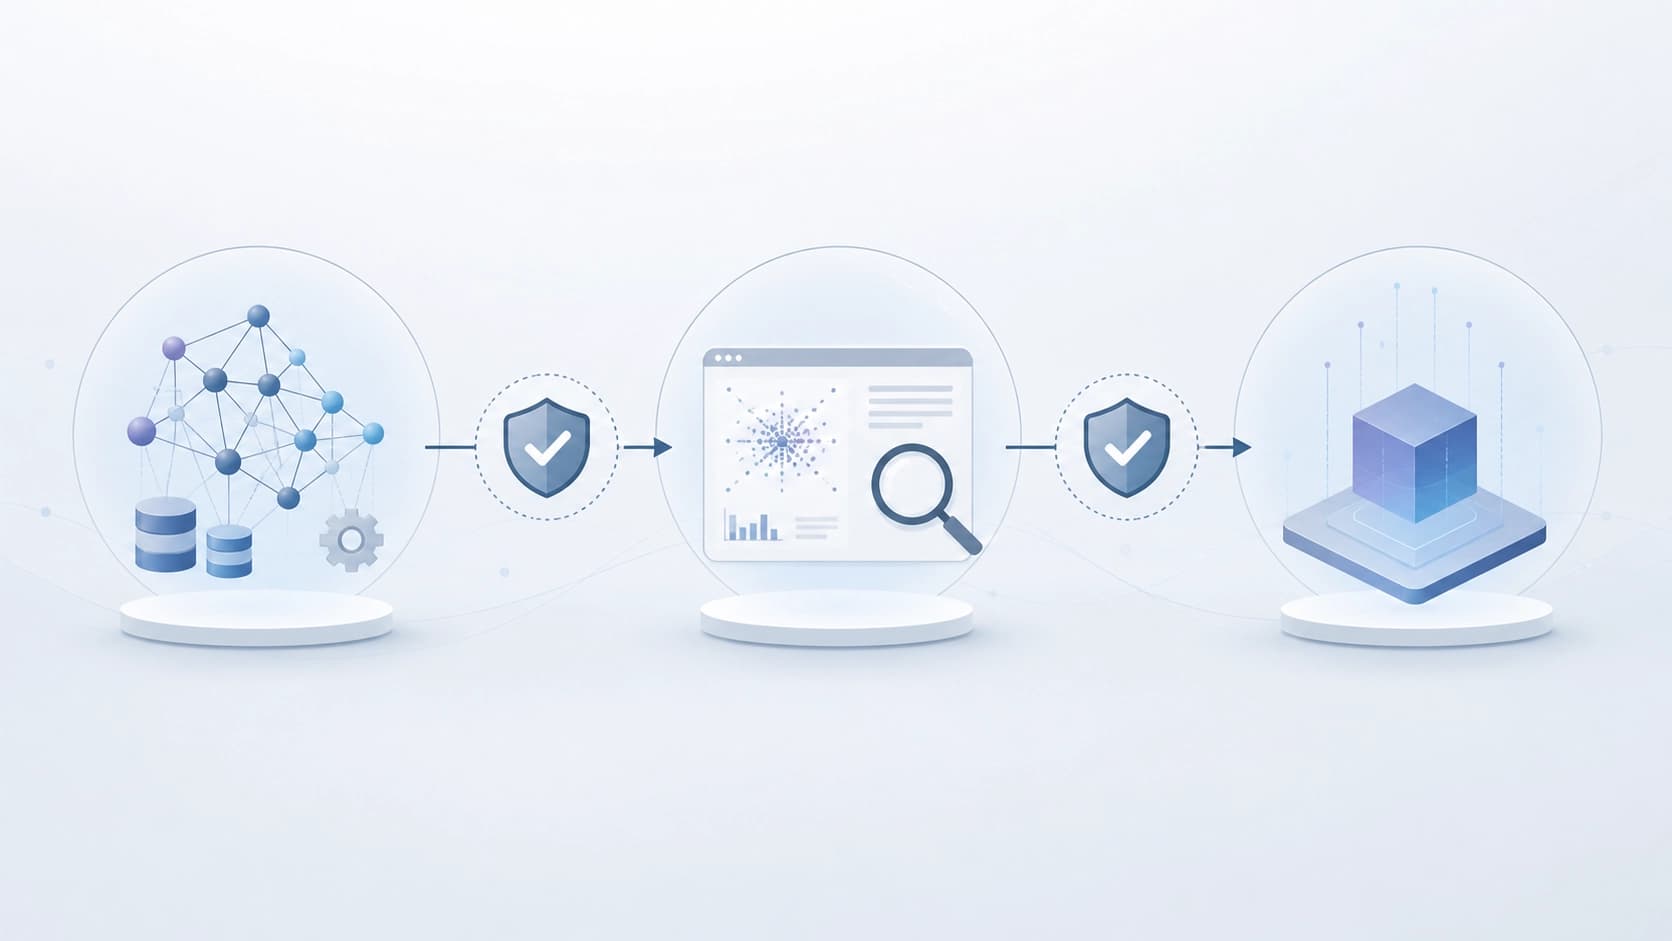
这套组合的主要实用价值在于,策略不再是一次性的文档。机构只需制定一次,然后将其贯穿应用的整个生命周期:从模型对齐阶段一直到对已上线产品的监控。
这明显改变了团队的日常工作。通常安全要求放在一个地方,测试放在第二个地方,生产日志放在第三个地方,还得靠人工去同步它们。而在这里,设想的是一个统一的规则来源,训练、发布前检查和对实时流量的观测都依赖于它。
需要说明的是:这套工具集并不会替机构决定哪些风险对它而言是关键的。它提供的是描述策略的语言和执行策略的基础设施——但规则的内容本身,仍然要由那些了解自己产品、行业和受众的人来定。
开源以及接下来该看什么
方案、策略示例以及工具本身都已公开。作者明确邀请大家提交想法、改进和反馈——这类项目通常押注于社区能比研究团队更快地发现那些尚未被触及的场景。
全文有多种格式可供获取:PDF、实验性 HTML 版本以及 TeX 源文件。文章有 DOI——10.48550/arXiv.2608.23870,因此在企业文档中引用它时,无需再附加"没有标识符的预印本"之类的说明。
如果你正试图把内部对 GenAI 的要求从"给董事会的演示文稿"格式,转变为能在流水线中真正发挥作用的格式——这正是值得亲自看一看的那类解决方案。从策略示例开始:它们能很好地展示出,作者对现实限制的理解有多细致,而不只是停留在学术层面的问题设定。