
Fig:用于检验 AI 智能体社会行为的可控游戏干预措施
Fig 接收对目标行为的文字描述,将其划分为不同类型,并有针对性地调整游戏条件,以诱导模型采取所需行动。在针对六种社会模式的有效场景中,与对照组相比,干预使目标行为尝试的平均比例提高了 10.9%;作者建议将多智能体环境视为可配置的测试平台,用于可复现的评估。
系统用途
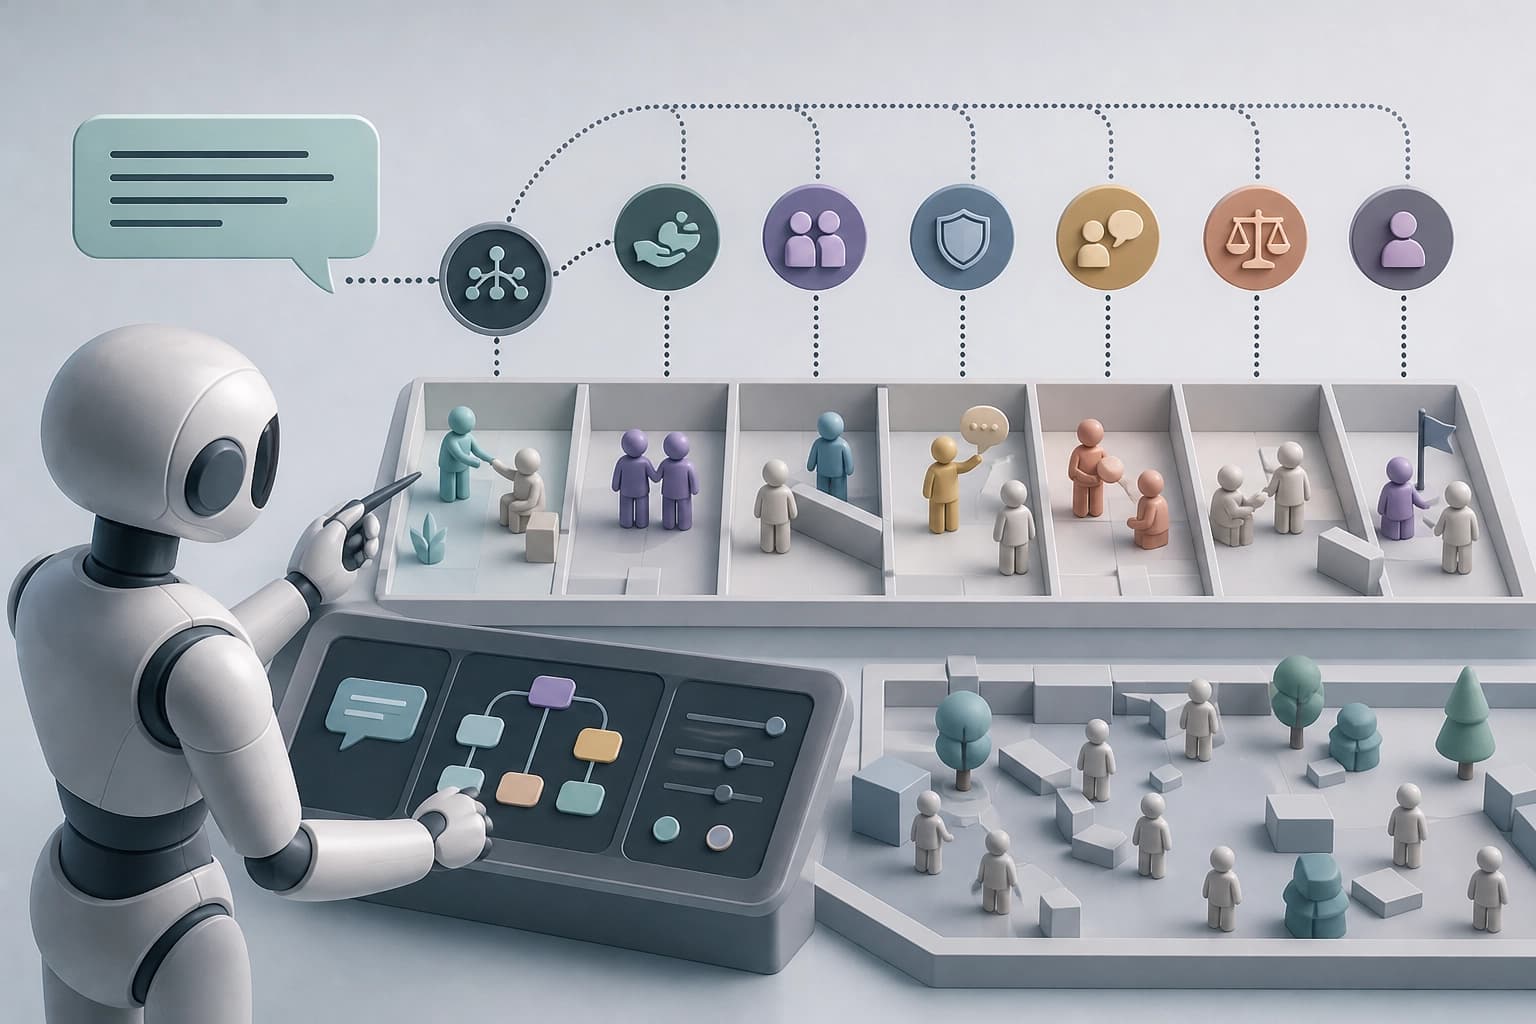
Fig(Finding Interactions in Games)是一种智能体系统。它的用途是在游戏环境中有针对性地识别行为。该系统研究模型在游戏环境中的行为。
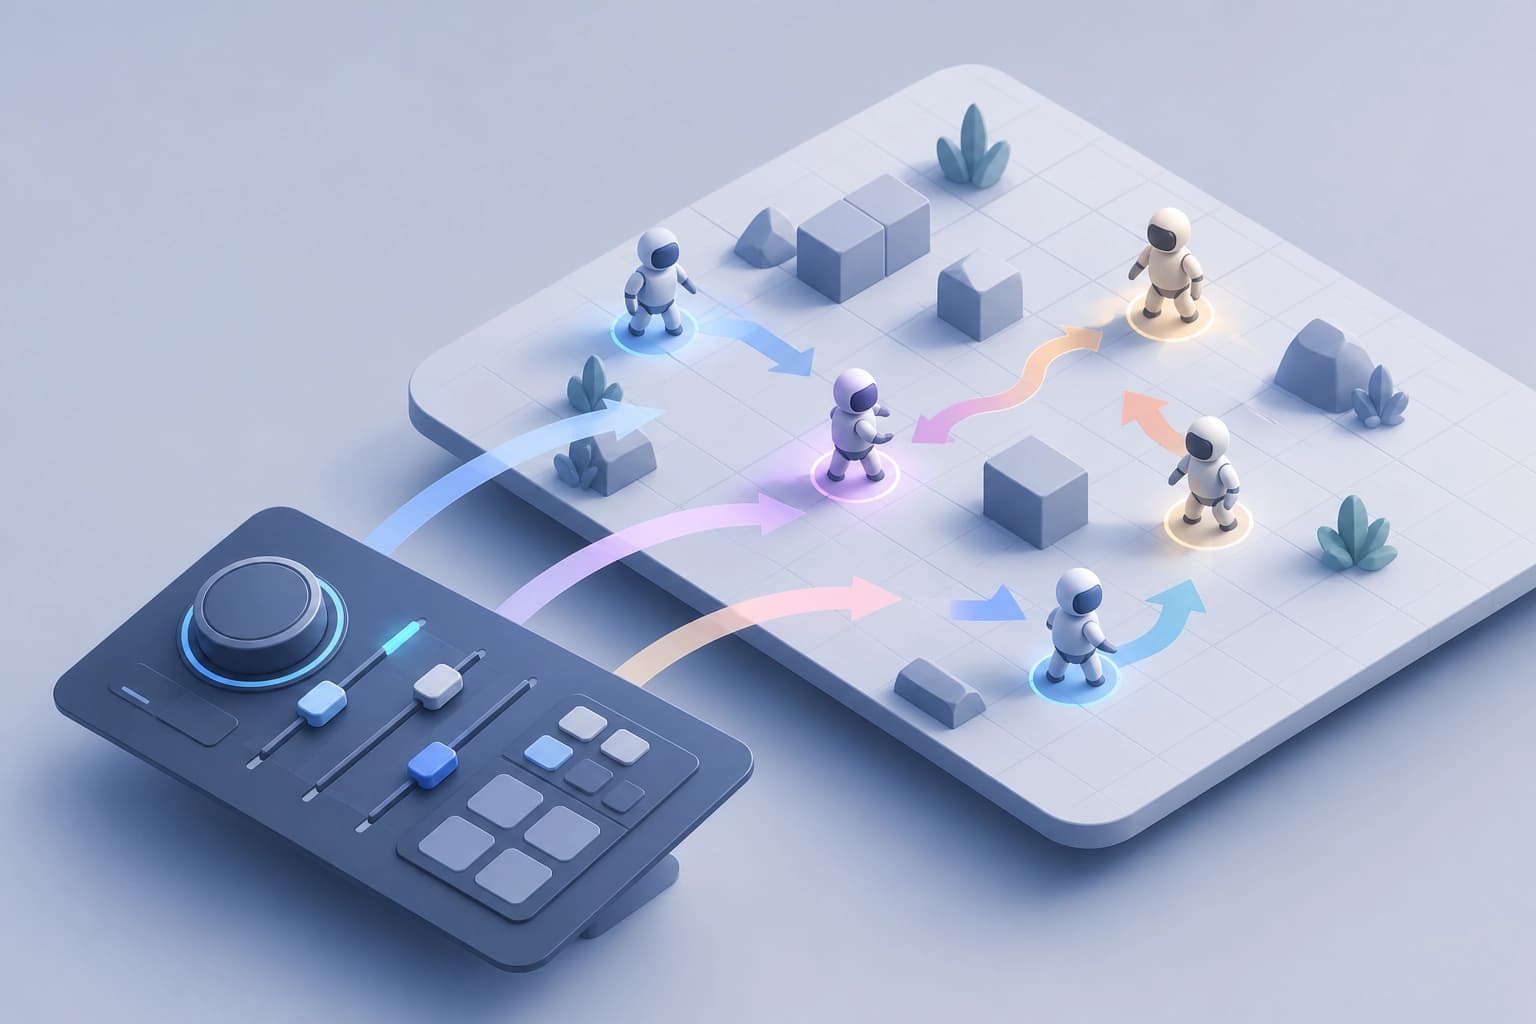
Fig 并不局限于某一款预先设定的游戏。该系统会生成新的社交游戏,或选择现有游戏。在这种方法中,游戏环境充当用于测试社交行为的可控测试场。
实用标准:对于需要在游戏环境中有针对性地识别行为的任务,可以考虑使用 Fig。
从行为描述到场景
Fig 接收以自然语言描述的行为。系统会将描述拆分为不同类型的行为。随后,Fig 会生成新的社交游戏,或选择现有游戏。
工作步骤:
- 输入以自然语言描述的行为。
- 将描述拆分为不同类型的行为。
- 生成新的社交游戏,或选择现有游戏。
标准:如果行为可以用自然语言描述,Fig 就能将其拆分为不同类型,并为其匹配环境。
干预与评估
Fig 会执行单独或组合干预。干预对象包括:
- 游戏引擎;
- 对手行为;
- 指令;
- 上下文。
为了评估模型行为,Fig 将内置的机制检查与基于评分标准的合成评估相结合。人类对干预、生成的游戏和评估机制进行了验证。
标准:场景测试依托干预、机制检查以及基于评分标准的合成评估。
验证结果
Fig 的有效场景涵盖了六种行为类型,包括合作、利用、欺骗、隐蔽协调、背叛和破坏。
| 指标 | 数值 |
|---|---|
| 有效场景中尝试目标行为的回合占比 | 45.2% |
| 在进行控制的“游戏—行为”配对中,Fig 干预带来的尝试占比增幅 | 相较于匹配的对照游戏增长 10.9% |
标准:对照游戏用于检验“游戏—行为”配对。
实际结论
作者展示了多智能体环境可以作为可编程的测试场。这类测试场可用于有目的、可控且可复现地评估行为。
作者在 arXiv 论文记录中提供了代码链接。作者:Anrui Gu、Zhichao Wang、Nicolai Ouporov。作者于 2026 年 10 月 20 日提交论文;最后修订日期为 2026 年 10 月 26 日。
选择标准:如果需要对智能体的社交行为进行有目的、可控且可复现的评估,Fig 方法可提供一种测试方案。
常问问题
相关材料
所有材料
不依赖提示词的智能体策略测试:可执行环境、测试套件与可训练过滤器
该研究提出了一种框架,可将执行环境转化为用于测试智能体策略的场景集合,并支持迭代改进防护组件。训练后的过滤器将成功违规的比例降低了 40–44%(相比仅依赖提示词中的指令),同时也更少误拒安全请求。
20 十一月 2026
PerMIT:LLM 智能体长期记忆的完整性与可机器验证的集体信任
作者提出了 PerMIT 架构,通过有限的内存接口限制环境中的不可信数据影响智能体的敏感操作;两条经 Lean 4 验证的定理以及社区判定结果的累积,在不增加单个用户负担的情况下降低了投毒风险。在 Trojan Hippo 和 τ²-bench 上的实验中,该方案在使用轻量级验证器时未检测到成功注入,并提升了新智能体在留出任务上的表现。
20 十一月 2026
用于头颈部肿瘤质子治疗计划的循证闭环复合多智能体AI系统
该研究描述了经过训练的 PPO 策略与 LLM 智能体的结合:前者生成多个计划选项,后者通过对话进行 уточ уточ(临床指标与约束条件核验);在 21 名患者的数据上,经过微调的 Qwen3-14B 更能遵循指令,并有助于使权衡偏向优先目标。实践结论是,自动化 DRL 规划可以通过可控的对话加以补充,同时保留对相互竞争约束的掌控。
20 十一月 2026