
人类可理解,LLM不可理解:专家无法解释模型的逻辑
研究人员比较了人类与六种语言模型在定量推理和化学任务中回答背后的隐藏因素。专家成功解读了从人类回答中提取的因素,而大多数模型构造对他们来说则难以理解。
人容易理解,LLM却不然:专家无法解释模型逻辑
当我们看到测试结果时,自然会认为人工智能“像人一样”解决问题:使用相同的概念、规则和推理方式。然而,一项新研究对这一假设提出了质疑。科学家发现,决定LLM回答的隐藏结构在大多数情况下无法被人类解释——即使是领域专家也不行。
具体验证了什么
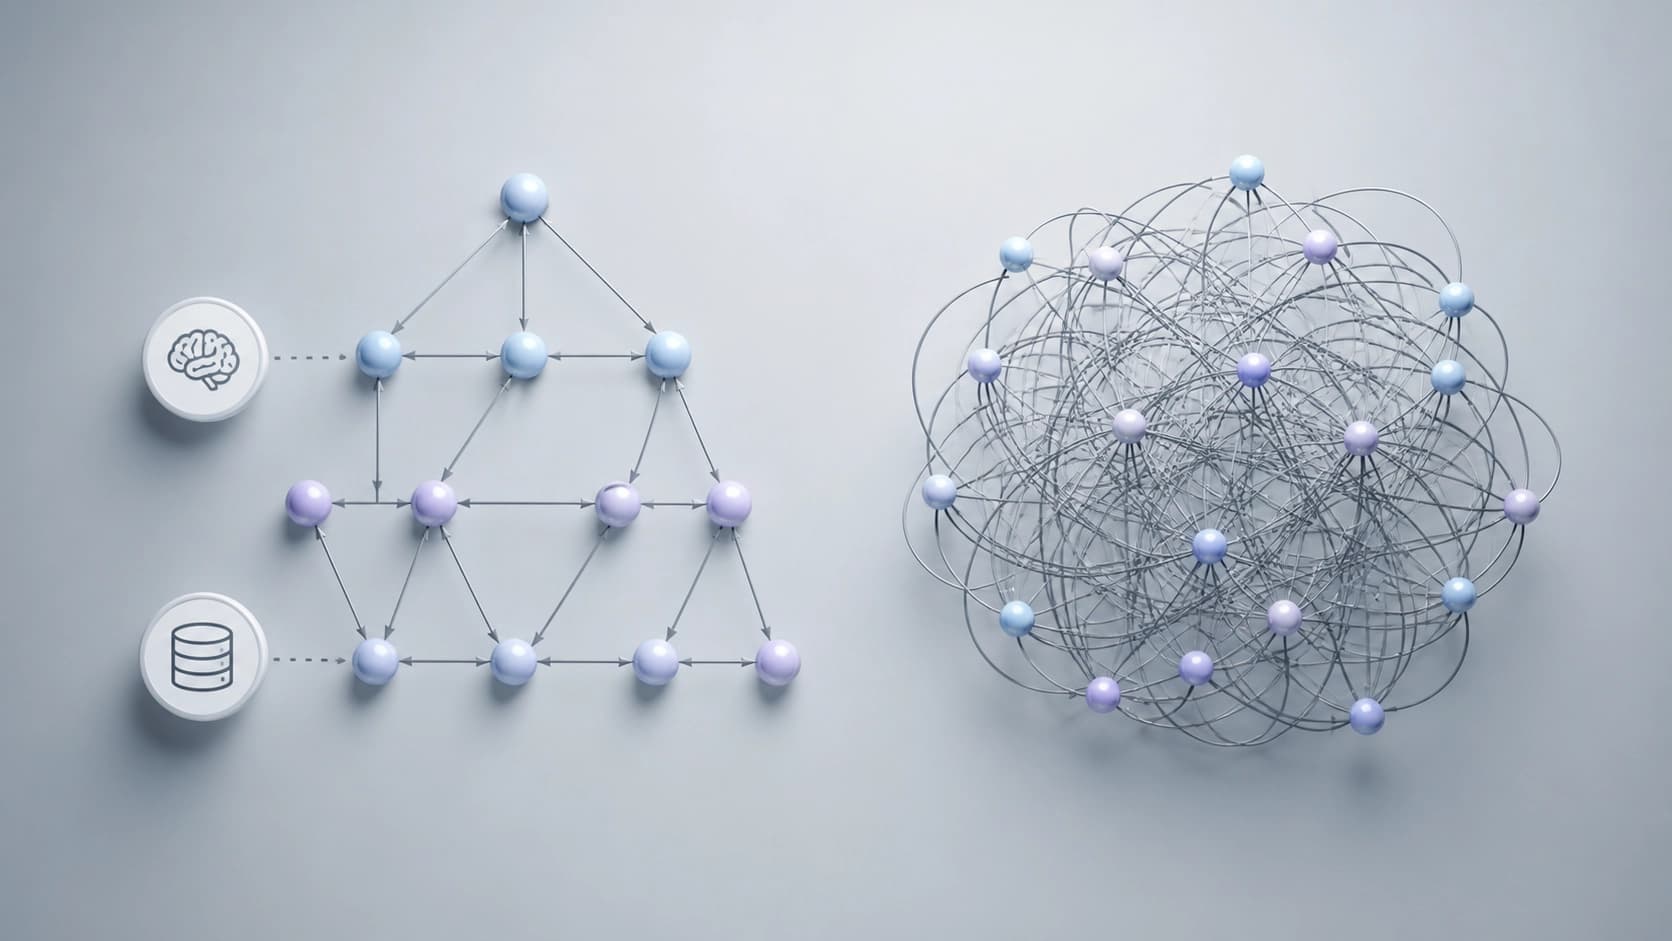
该研究的作者(arXiv:2608.17810)——阿洛娜·斯特鲁加茨基、利科尔·泽因费尔德、杰森·库珀及其同事——选取了人类和六种不同LLM在定量推理和化学任务上的回答。通过探索性因子分析,他们为每组提取了隐藏的潜在因子,这些因子被认为与任务完成表现相关。
随后,领域专家以盲评方式研究所得结构,并尝试为因子赋予教学意义:例如“运用公式的能力”或“对化学计量学的理解”。盲评格式排除了提示——专家不知道这些图谱对应的是人类还是模型。
结果:可解释性的鸿沟
专家几乎毫无困难地理解了基于人类回答提取的因子。大多数构念得到了有意义的解释,并能轻松转化为教学或诊断建议。
而LLM的情况则截然不同:
- 在定量推理中,专家无法对模型提取的任何因子做出有意义的解释。
- 在化学领域,情况稍好一些,但仍远非理想:仅能解释约一半的结构。
这意味着什么
作者得出一个重要结论:当LLM在测试中表现优异时,并不意味着它们以我们所熟悉的方式推理。模型可能找到统计上高效、但对人类而言完全“陌生”的解题路径。其内部机制运作在模式层面,不承载可理解的教学或认知意义。
这一发现对一种常见做法提出了挑战:即试图根据AI的结果推断其知识或能力水平。如果我们无法解释回答背后究竟是哪些构念,就可能给模型赋予并不存在的能力——或者反过来,忽略其真实局限。
未来方向
该研究并不认为LLM在原则上无法被解释。它只是表明,为研究人类认知而设计的经典方法无法直接迁移到模型上。或许需要开发全新的分析方法——那些能考虑潜在结构“非人类”本质的方法。
目前仍有一个悬而未决的问题:如果专家无法解释模型的逻辑,我们还能放心在教育与知识评估中使用它们吗?答案或许需要我们重新审视AI的检验方法,以及我们对机器“智能”的期待。
常问问题
相关材料
所有材料
验证候选项比生成候选项更昂贵:对抗 LLM 漏洞搜索的诱饵
本文剖析了智能体缺陷搜索中的成本不对称:生成候选版本成本低廉,而通过可达性分析、执行和 PoC 对其进行确认却要耗费主要预算,因此可以将验证本身作为独立的防御目标。本文提出的 RedHerring 是一套针对代码仓库定制、带有隐藏证书的诱饵;在投入相同成本的情况下,它使 33 个 OSS-Fuzz 项目中发现的真实漏洞数量减少了 38.7–60.4%;即使提前告知智能体,降幅仍达 37.2%。
9 十一月 2026
通过 SQL 视图检查 LLM 幻觉,无需微调
这项研究考察了 LLM 能否运用一项基础的符号技能——根据源文档构建 SQL 数据库——在幻觉检测中实现无监督的来源归因。在 RAGTruth 和 DiaHalu 上,这种神经符号流程比直接预测更准确,且性能可与先进方法相媲美,无需针对特定领域进行微调。
9 十一月 2026
MathAdv:机器证明的最终准确率隐藏着什么
这套涵盖大学及研究生阶段 13 个数学分支的诊断性任务集,不仅根据最终结果评估 Lean 4 中的机器证明系统,还考察其学科知识、非正式推理质量以及对题目改写的适应能力。分项分析显示,将题目转化为形式化表达仍然是主要障碍,而成功与否在很大程度上取决于数学领域和题目的表述方式。
9 十一月 2026