
VLA 模型 VLALight 控制交通信号灯:直接从路侧摄像头视频端到端输出动作
作者提出了 VLALight,这是一种端到端的“视觉—语言—动作”模型,可将路口摄像头的多视角记录直接转换为信号灯切换操作,无需人工定义交通流状态。该方案融合了考虑路口拓扑的联合感知、城市路网级强化学习,以及在快速推理和深度推理之间自适应选择的能力;在三个城市的七个真实数据集上,其表现优于基于交通模型、强化学习和 LLM/VLM 的基线方法。
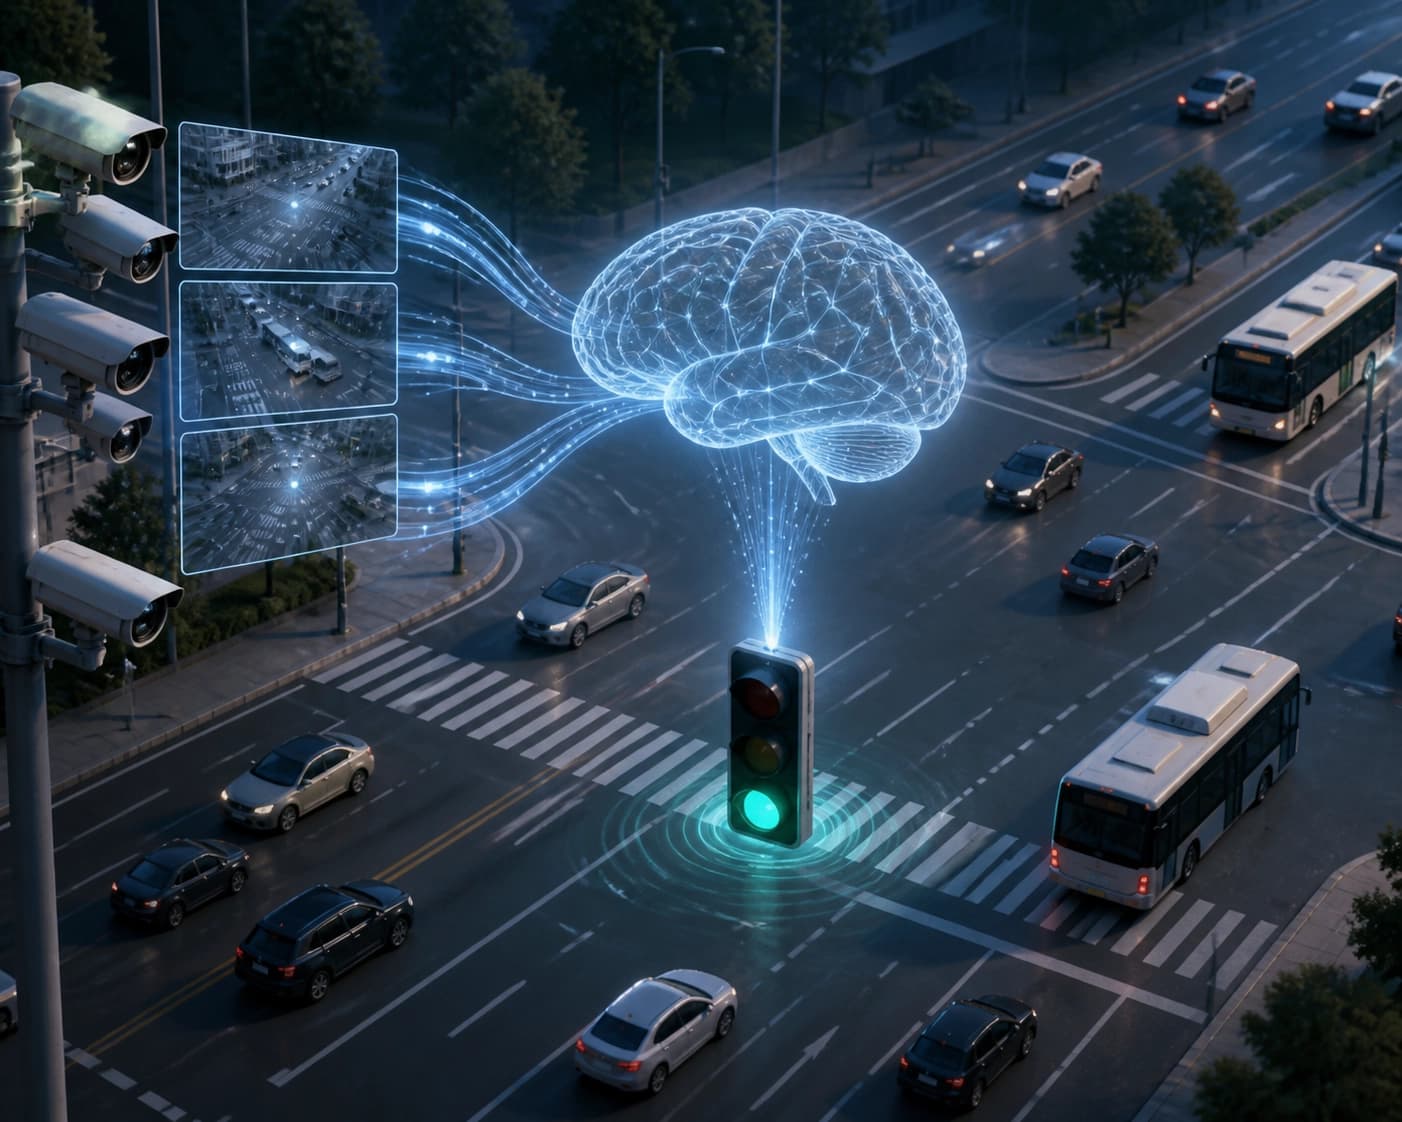
什么是用于交通信号灯控制的 VLA 模型
VLALight 是一种用于交通信号灯控制的视觉-语言-动作模型。作者:Pan Zhang、Siqi Lai、Kemu Dong、Hao Liu。论文于 2026 年 9 月 29 日提交。这是首个基于路侧摄像头多视角视频进行端到端交通信号灯控制的 VLA 模型。
该模型直接将视觉观测转换为协调一致的交通信号灯动作。它运用时空推理处理多个目标,并在拓扑层面考虑交叉路口的协同感知。
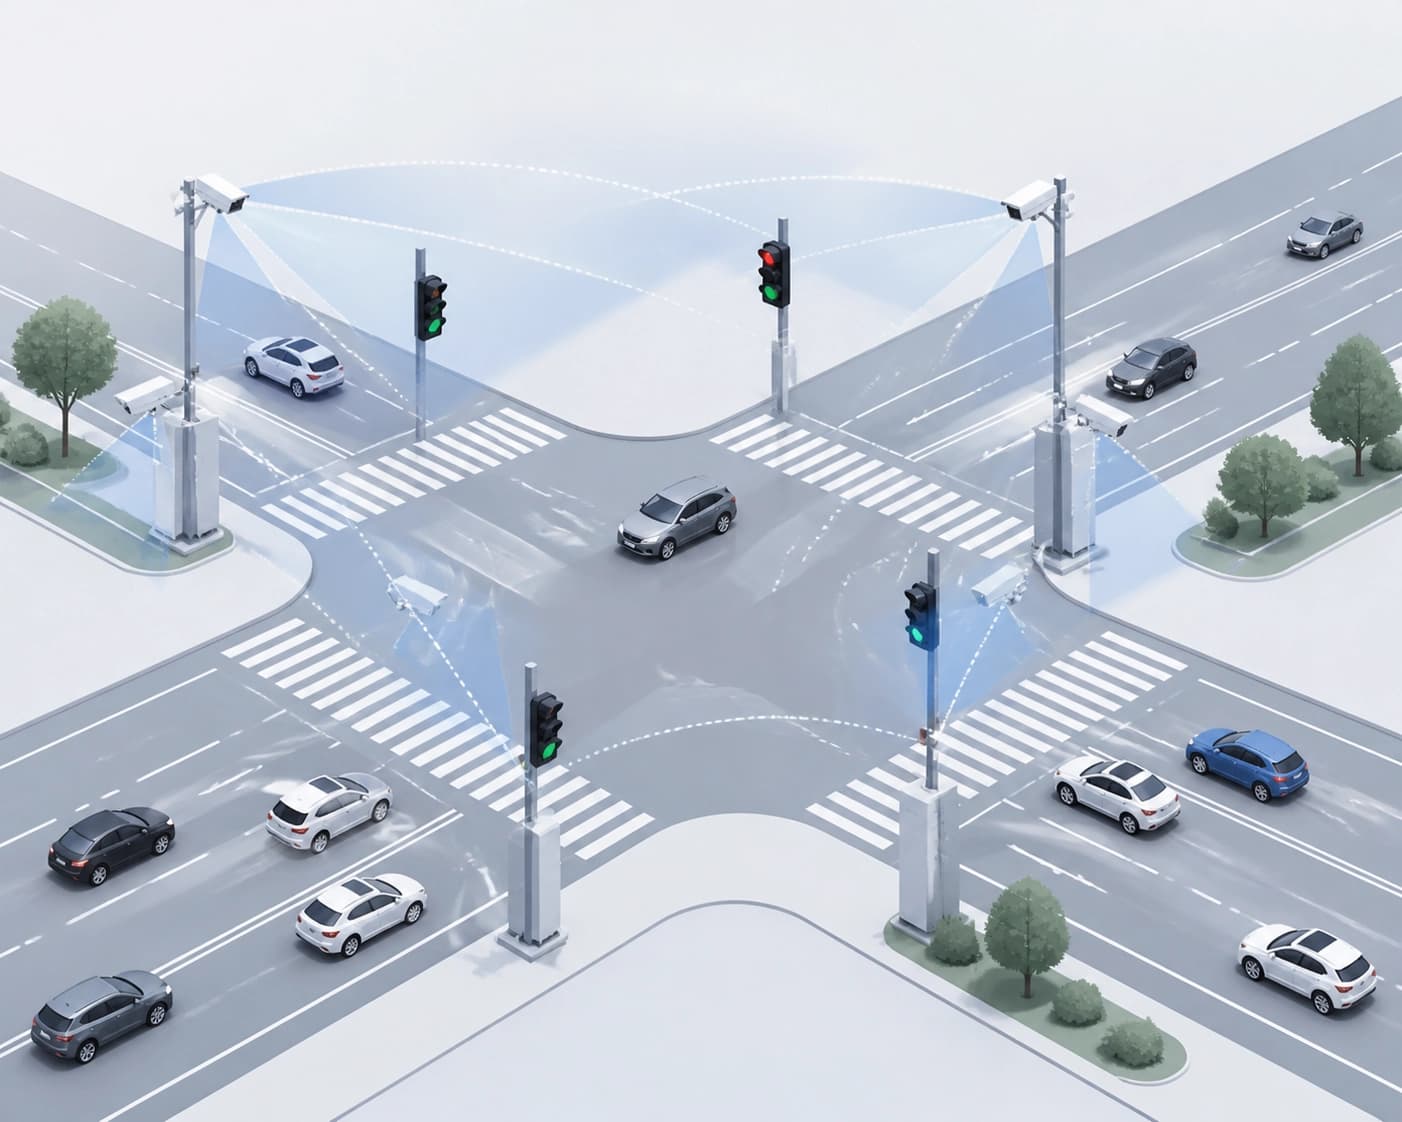
该方法的关键特性:
- 端到端推理:将视觉观测转化为交通信号灯动作。
- 多视角视频:数据来自路侧摄像头。
- 时空推理:模型会考虑多个目标。
- 拓扑层面的考量:交叉路口的协同感知。
选择标准:VLA 方法将感知与控制整合到同一个模型中。这使其区别于将这两项任务分开的方案。视频与动作之间的端到端关联是关键标准。
VLALight 如何训练:两个阶段
VLALight 的训练采用两阶段策略。首先进行监督式冷启动,以培养对道路交通状况的视觉理解能力以及交通信号决策能力。随后进行协作式智能体强化学习。
第二阶段联合优化局部控制和整个交通网络的效率。第一阶段负责理解场景和交通信号。第二阶段则优化局部控制和交通网络。
| 阶段 | 任务 | 优化目标 |
|---|---|---|
| 监督式冷启动 | 对道路交通状况进行视觉理解并做出交通信号决策 | 模型的初始能力 |
| 协作式智能体强化学习 | 联合优化 | 局部控制和网络效率 |
选择标准:关注方法是否包含网络层面的联合优化。缺乏网络背景的局部决策会限制效果。两阶段设计将感知训练与交互调优分开。
自适应推理模式与推理成本
VLALight 采用快速和慢速两种自适应推理模式。只有在更深入的推理能为控制带来足够收益时,才会启用该模式。模型采用均衡的模式感知 rollout 和相对优势优化。模型学会在决策质量与推理成本之间取得平衡。
| 模式 | 启用条件 | 效果 |
|---|---|---|
| 快速 | 深度推理无法带来足够收益 | 推理成本更低 |
| 慢速 | 深度推理能够带来足够收益 | 决策质量更高 |
选择标准:在决策质量与推理成本之间取得平衡。模式应根据其对控制的收益进行切换。始终以最大推理深度运行会增加成本。
实验结果
实验使用了七个真实交通流数据集,涵盖三个城市的交通网络。VLALight 的表现优于基线方法,包括交通模型、强化学习以及 LLM/VLM。
| 基线方法类别 | 对比中的作用 |
|---|---|
| 交通模型 | 基线 |
| 强化学习 | 基线 |
| LLM/VLM | 基线 |
消融研究证实了协同感知、网络层面优化和自适应推理的有效性。作者指出,VLA 模型有望用于控制真实的物理交通系统。
选择标准:检查基线方法的构成以及是否进行了消融实验。实验涵盖真实交通流和三个城市的交通网络。每个组件的贡献都应单独得到验证。
常问问题
相关材料
所有材料
转向概率单纯形可缩小对比式多模态模型中的模态差距
在论文 arXiv:2610.32890 中,作者提出用概率单纯形替代球面嵌入,并加入轻量级 softmax 适配器和总变差相似度。在五个检索基准测试中,模态间的质心 ℓ2 距离降低了 97–99%,同时检索质量保持不变或有所提升。
3 十一月 2026
ActionRAG 如何在 LLM 智能体的记忆图扩散过程中重新审视证据
提出了一种图式记忆架构,在索引阶段谨慎协调实体,并在查询时依据局部结构重新评估关联。在 MemoryAgentBench 上,该方法的平均准确率达到 55.1,比最强检索基线高 5.4 个百分点,且每次查询的合成成本很低。
3 十一月 2026
十五家公司支持 MDK Tether,实现挖矿自动化
设备制造商、矿池和运营商已着手基于 Tether 开放工具集开发集成,以统一设备监控和管理;AI 代理 QVAC 已在此基础上运行。目前尚未发布有关降低电力成本或提高效率的独立验证。
2 十一月 2026