ИИ должен планировать именно что
Городское планирование здесь — задача пространственной оптимизации: нужно выбирать допустимые действия из большого пространства кандидатов。
实际目标包括成本和服务质量。
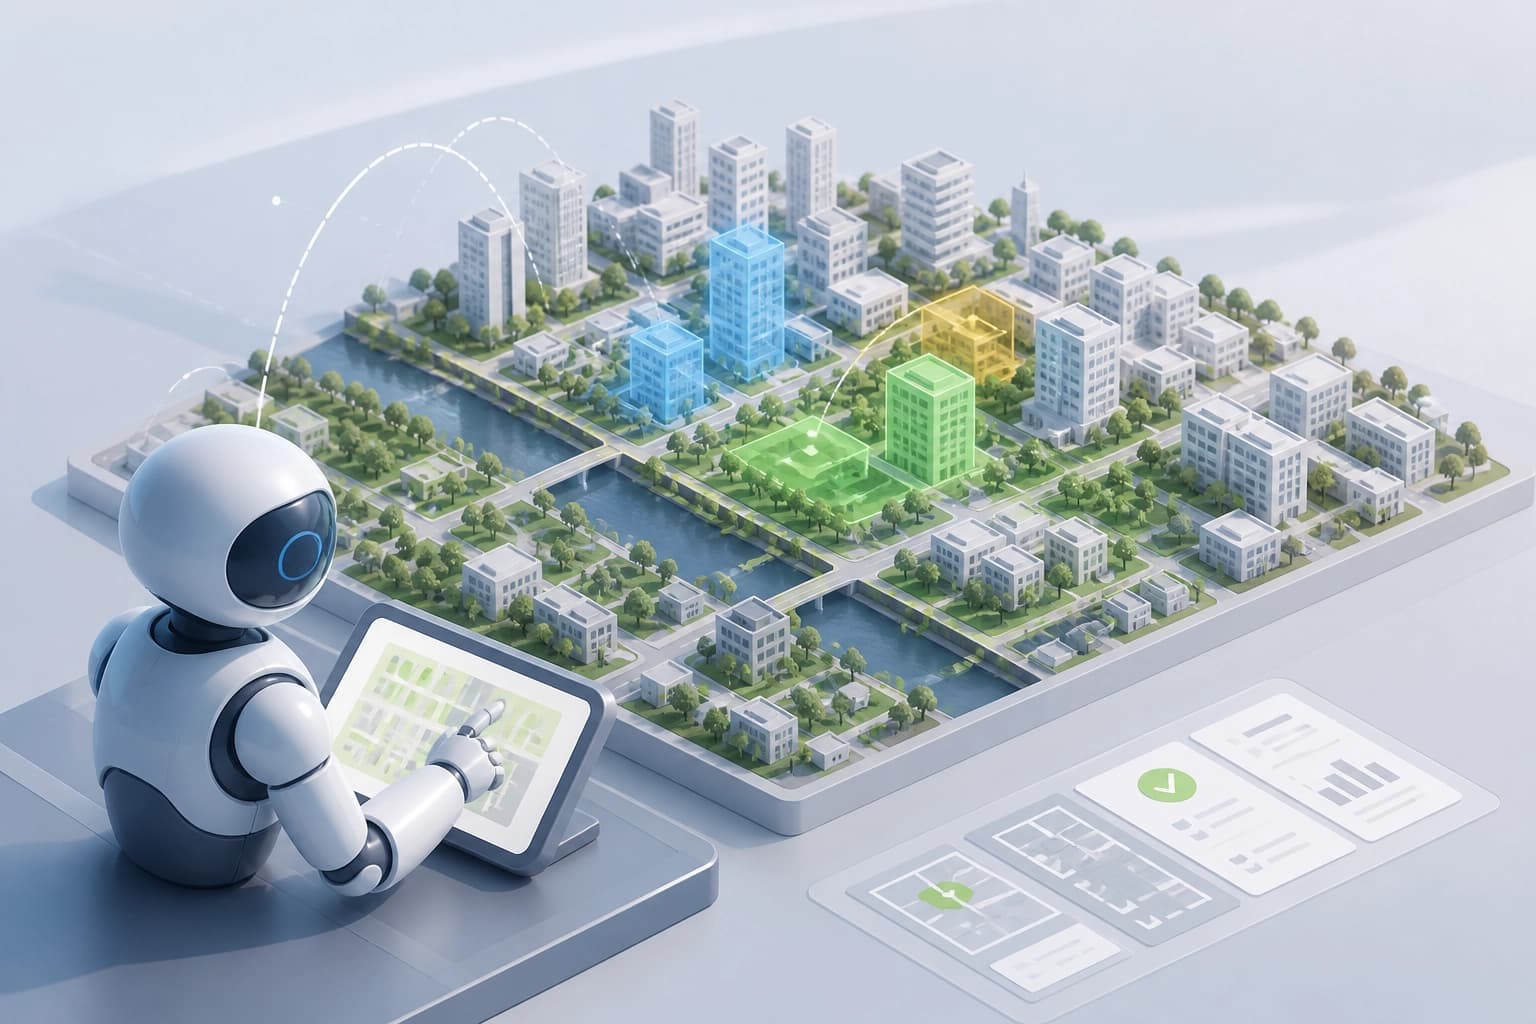
CityPlanner 的工作介绍了一种用于可执行城市规划的 sandbox 代理。
可验证的场景将计划与评估联系起来:系统运行评估器并获得可执行的反馈。
在这种设定中,关键要素包括 допустимые действия、实际目标以及评估结果的能力。
可验证性的标准是:环境能够评估生成的计划。
运行环境如何运作
在 UrbanSandbox 中,代理在统一的文件环境中运行。
它会检查任务文件、创建计划、运行评估器,并根据反馈修订方案。
这一循环将处理任务数据与验证计划结合起来。
代理的主要操作:
- 检查任务文件;
- 创建计划;
- 运行评估器;
- 根据可执行反馈修订方案。
如果代理能够在环境中完成从了解任务到修订计划的整个循环,那么该环境就适用于这一场景。
如何拆分训练
作者提出了原子任务强化学习(atomic-task reinforcement learning):将沙盒中的长轨迹拆分为两个任务。
这种拆分简化了训练,将最初构建计划与后续改进计划分开。
每个任务负责计划处理流程中的一个独立阶段。
- BuildPlan — 初步构建计划。
- ImprovePlan — 根据反馈改进计划。
当训练同时涉及创建计划以及随后根据评估结果对其进行调整时,这种拆分就很有用。
实验结果
在真实基准测试中,CityPlanner 稳定地优于三类对照方法:
| 对比对象 | 结果 |
|---|---|
| 启发式方法 | 代理表现更好 |
| 特定任务的 RL 方法 | 代理表现更好 |
| 通用 LLM 代理基线模型 | 代理表现更好 |
消融研究证实了 UrbanSandbox、原子任务强化学习和迭代部署的作用。
作者表示将发布代码和数据集。
该研究于 2026 年 9 月 9 日提交,目前正在 EMNLP 审稿中。
实践结论仅限于该基准测试的结果:这些结果支持所提出的方案,但并不能证明它在所有城市任务中都更具优势。
来源:arXiv:2609.09578.