模拟评估检查什么
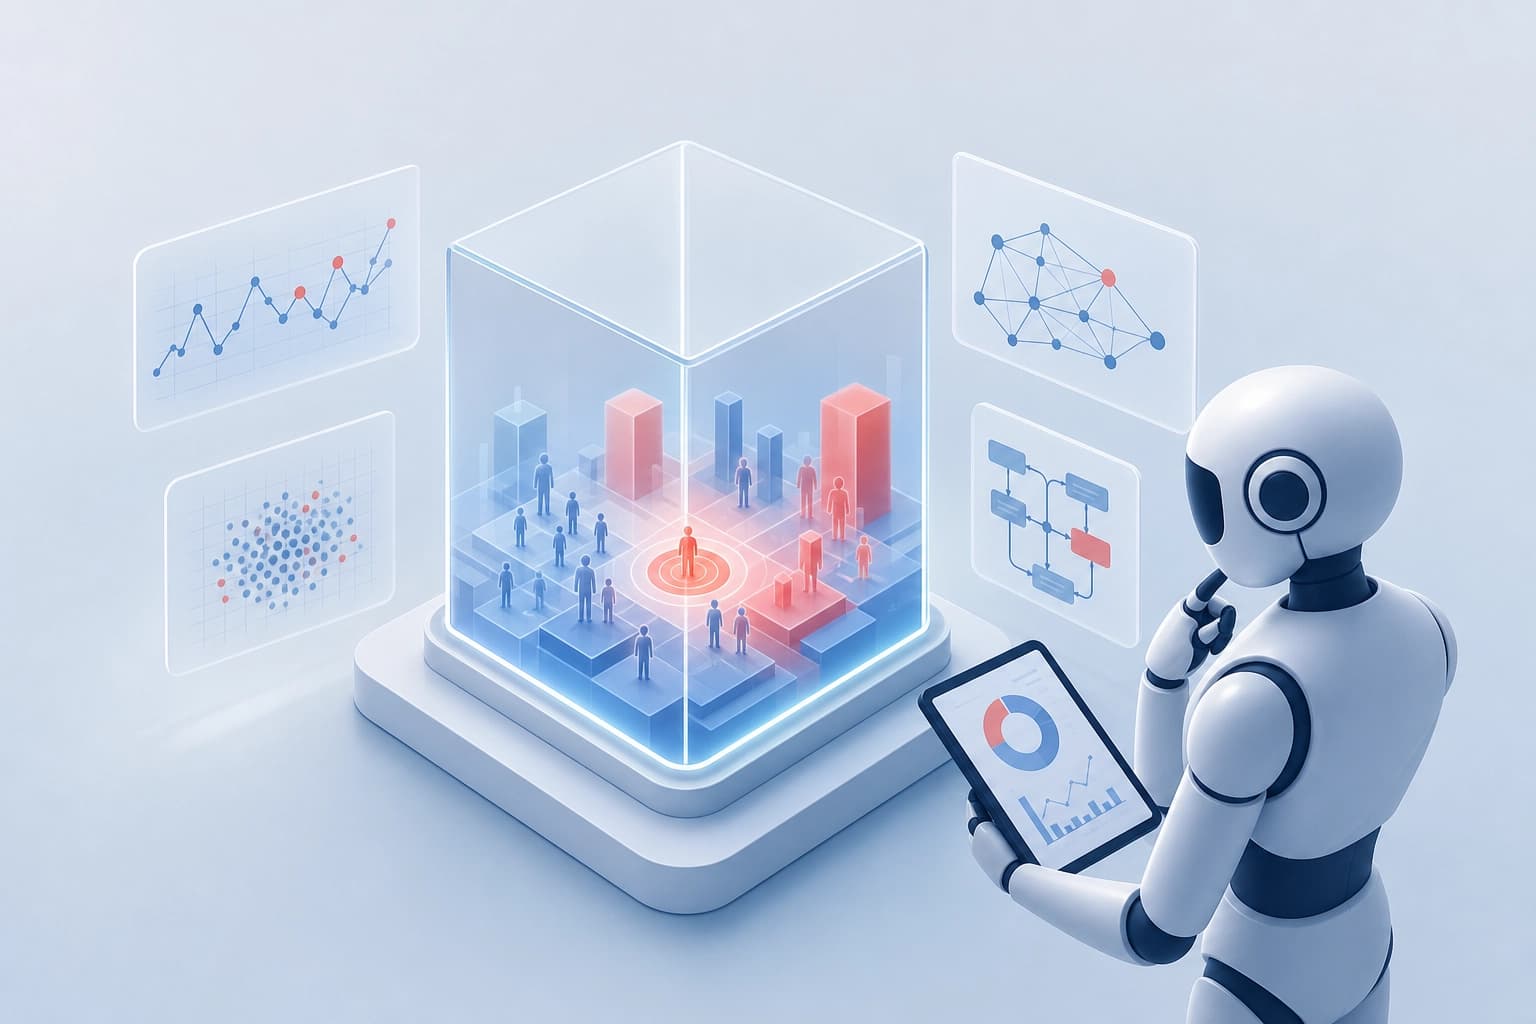
TRACE 是一个用于数字广告的诊断环境。它涵盖 12 种根本原因和细粒度的细分归因。在每个情节中,智能体都会使用 Python 和 SQL 探索数据。随后,它会确定根本原因,并在适用时确定受影响的细分群体。
TRACE 由 Rui Sun、Zhan Shi 和 Bing He 在一篇论文中介绍,该论文于 2026 年 9 月 9 日提交至 arXiv。论文标识符为 arXiv:2609.10315。
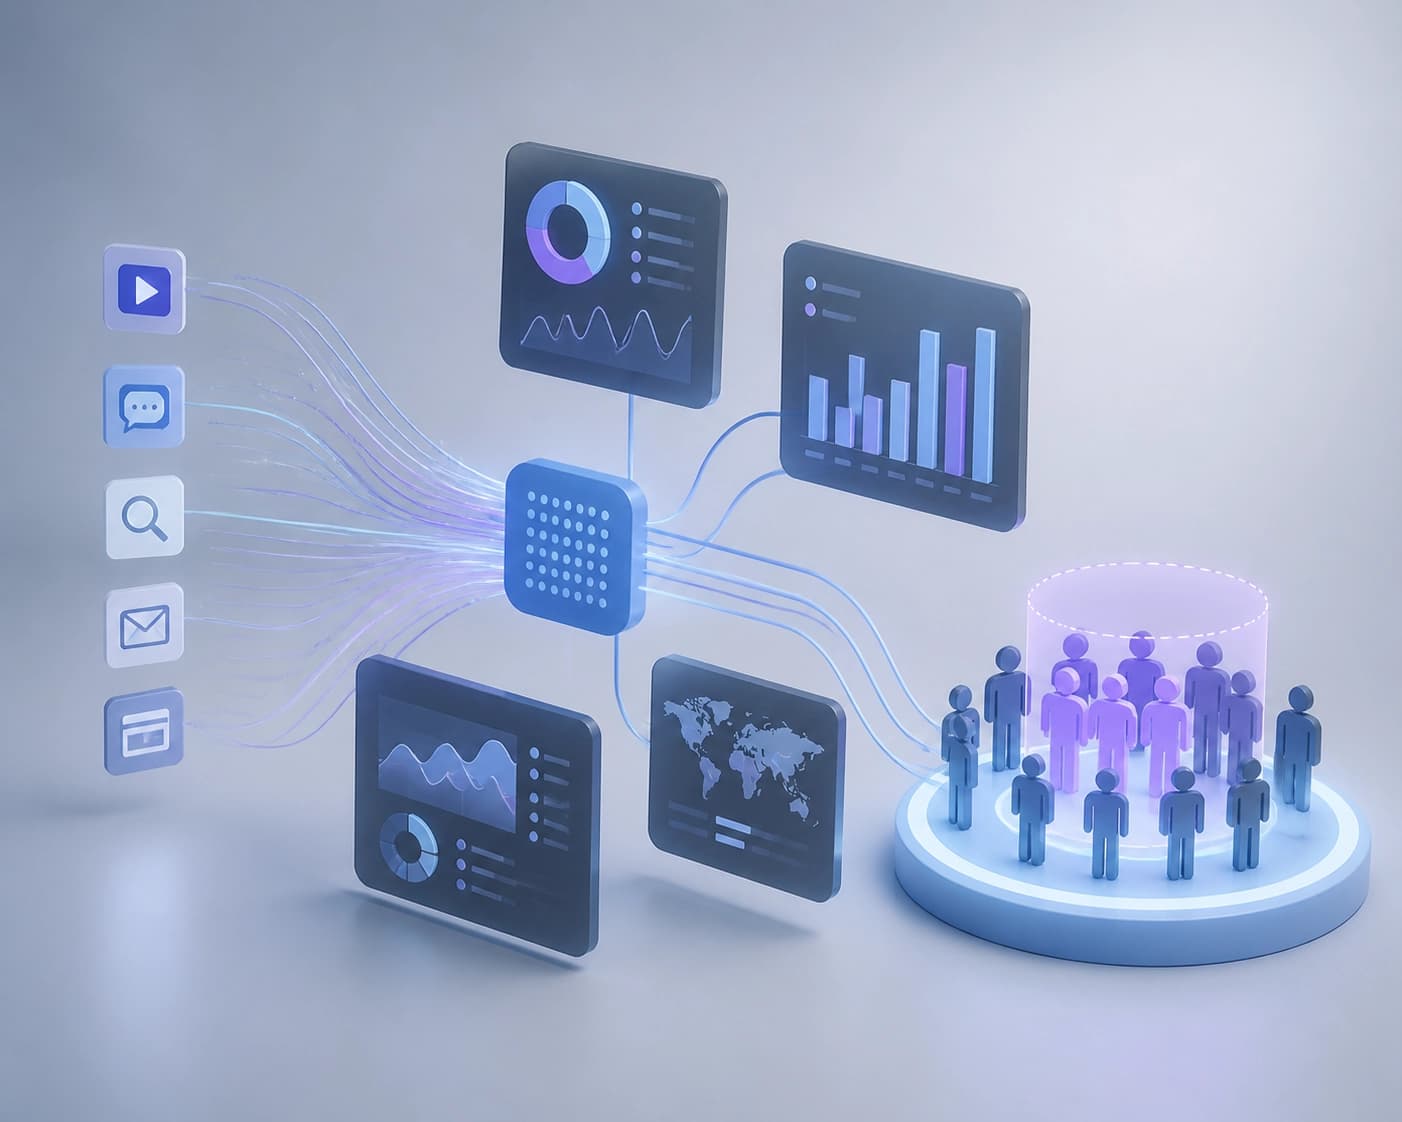
评估如何进行
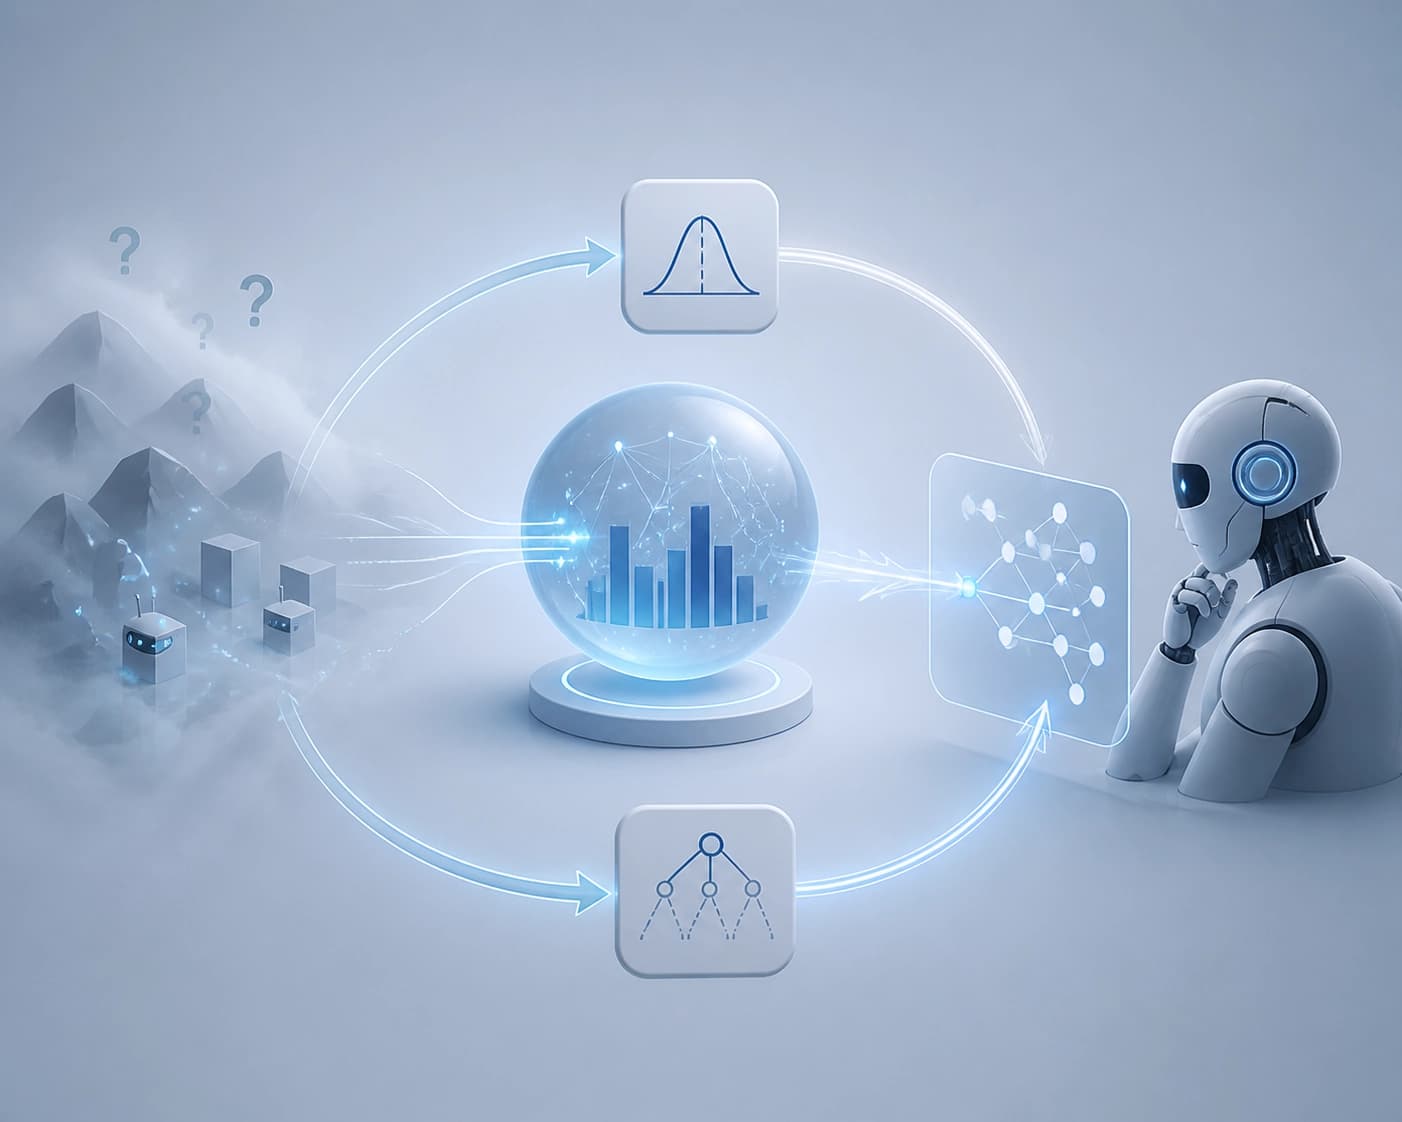
评估围绕干预及其引发的观察结果展开:
- 选择一项干预,并将其输入受控模拟器。
- 模拟器生成相应的观察结果。
- 智能体探索数据并寻找故障原因。
- 隐藏的干预作为标准标签,用于计算客观奖励。
智能体不会收到现成的解释。它必须将嘈杂、混杂且分散在数据中的证据联系起来。因此,这项模拟评估检验的是因果推理,而不只是识别预先设定的答案。
如何解读结果
作者在包含 235 个情节的留出测试集上评估了模型。表现最强的 prompting baseline 是 Claude Opus 5,FullAttr@1 得分为 0.686。
| 模型或阶段 | 结果 |
|---|---|
| Qwen3.5-35B-A3B 经监督微调后 | 0.159 → 0.637 |
| 同一模型经基于合成奖励的 RL 后 | 0.757 |
| Qwen3.5-122B-A10B 的 prompting baseline | 低于 0.757 |
0.757 的成绩超过了所有受评估的 prompting baselines,包括闭源前沿模型。作者还报告称,训练得到的策略所需的工具调用次数显著少于 35B 基础模型的 prompting 版本。
结果对智能体训练的启示
作者认为,获取可扩展的客观训练信号,可能比单纯扩大模型规模更具制约性。这是基于所述任务结果得出的结论,并非适用于所有 AI 系统的普遍规律。
模拟评估可以使模糊的诊断推理任务适用于可扩展的强化学习。关键前提是能够将智能体的推断与隐藏干预进行比对,并计算客观奖励。
何时适用这种方法
如果问题设定允许以下操作,模拟就适合用于检验因果推断:
- 设定干预并将其引入受控环境;
- 生成与该干预相关的观察结果;
- 将干预保留为隐藏的标准标签;
- 在适用时同时评估根本原因和受影响的细分群体。
如果任务无法与标准标签进行这样的比对,所述客观奖励机制就无法得到保障。实际的选择标准是:能否在分析过程中不揭示隐藏原因,同时根据该原因检验智能体的推断。