
Linkup 的 SPARSEUP:拥有 1.49 亿参数的稀疏编码器
本文探讨了 SPARSEUP 的架构及其成果:在 BEIR-13 上达到 56.4 nDCG@10,并且与 Seismic 索引结合时,召回率超过 97%,每次查询耗时约 380 微秒。文章还分析了保持向量稀疏性的技巧、与其他模型的比较,以及 Apache 2.0 许可下的分发条件。
什么是该模型,如何获取
SPARSEUP 是 Linkup Research 推出的开源稀疏编码器,拥有 1.49 亿个参数。它以 ModernBERT 为骨干网络,采用 Apache 2.0 许可证。
权重可在 Hugging Face 上获取。通过 Transformers 或 Sentence Transformers 加载模型时,可设置 trust_remote_code=True。
Linkup 称,这是该公司所知的、参数量少于 1.5 亿的模型中最强的公开词项级稀疏编码器。
稀疏表示的工作原理
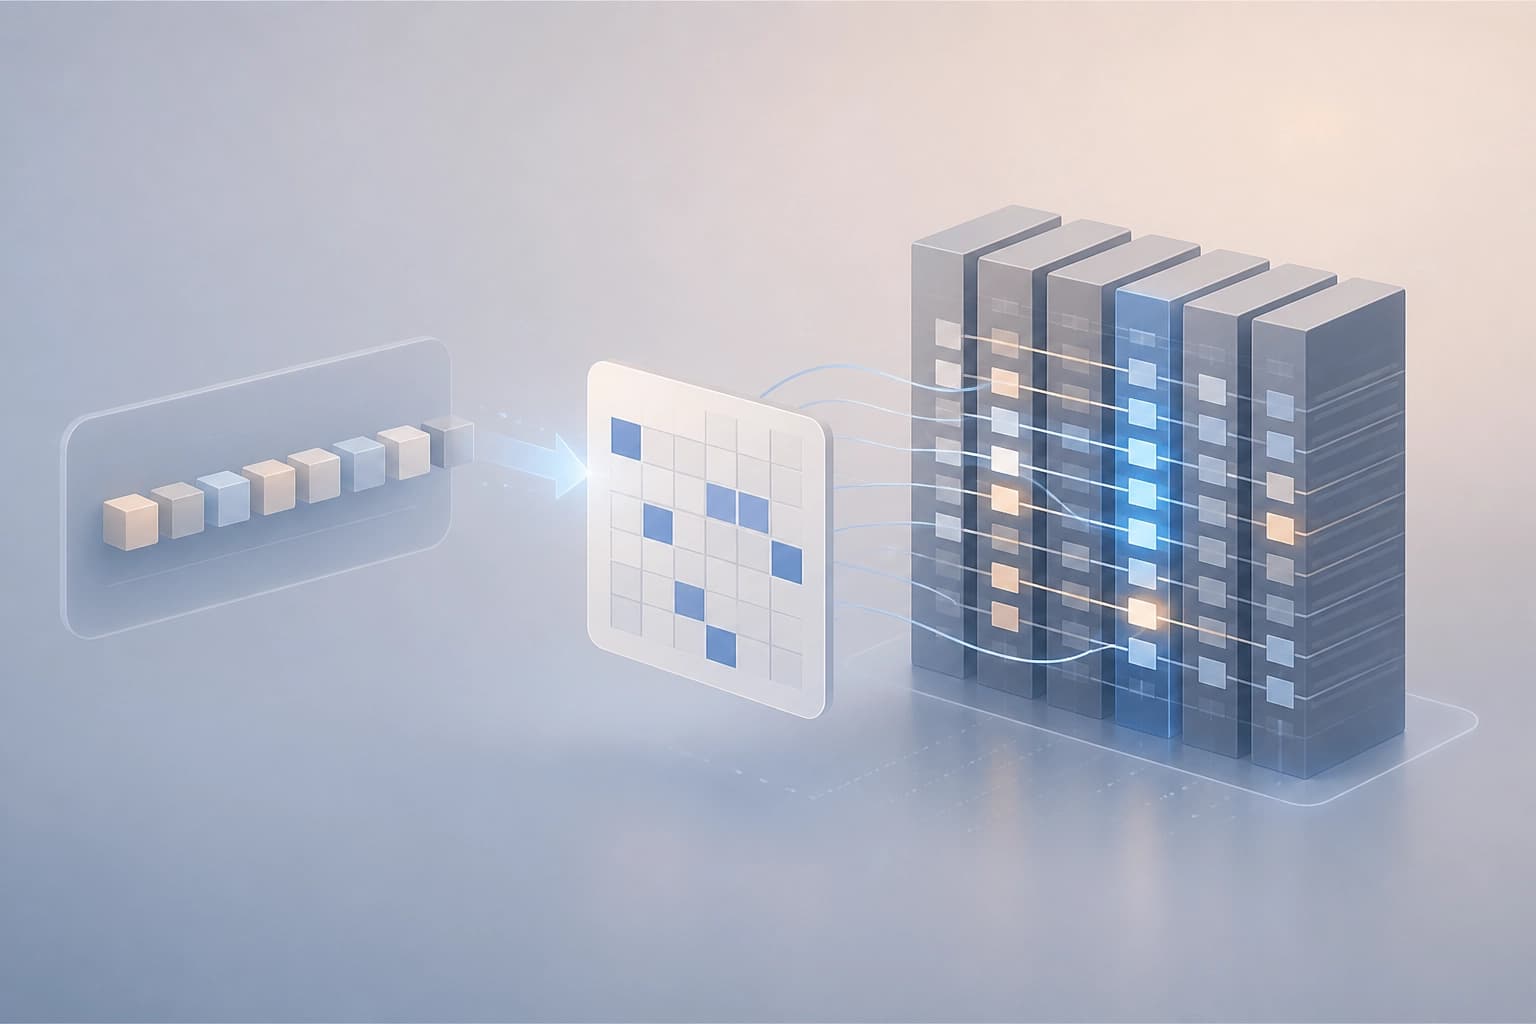
在 SPARSEUP 中,向量的每个维度都对应词汇表中的一个词元。这类向量适用于倒排索引,也更善于匹配罕见词。
模型按公式 log(1 + ReLU(x - 15)) 计算激活值。然后在 max pooling 之前,为每个输入词元保留 12 个最强的维度。
这限制的是每个词元激活的维度数量,而不是向量的总大小。大小写折叠会合并 Byte-level BPE 的不同形式,例如 heat、Heat、Ġheat 和 ĠHeat,并保留权重最大的形式。
合并后,输出维度数量从约 5 万降至约 3.4 万。查询和文档分别添加前缀 [Q] 和 [D];评分通过点积计算。
评分时,查询的最大长度为 128 个词元,文档的最大长度为 512 个词元。在配置输入处理时,这些限制十分重要。
模型的训练方式
SPARSEUP 的训练从 LateOn-unsupervised 检查点开始。团队恢复了 ModernBERT 原有的 MLM 头。
微调使用了 LightOn 数据混合,并且只采用对比学习。每个查询从 50 个候选项中选取 7 个 hard negative,同时也使用批内负例。
团队没有使用 cross-encoder 蒸馏。训练仅使用了一张 H100。
对比结果
SPARSEUP 在 BEIR-13(不含 MS MARCO)上的平均得分为 56.4 nDCG@10。模型卡中列出了以下稀疏编码器的结果:
| 模型 | BEIR-13,nDCG@10 |
|---|---|
| SPARSEUP | 56,4 |
| opensearch-neural-sparse-encoding-doc-v3-gte | 54,6 |
| opensearch-neural-sparse-encoding-v1 | 52,44 |
| ModernBERT-VT | 52,4 |
| splade-v3 | 51,7 |
| granite-embedding-30m-sparse | 50,6 |
LACONIC-1B 得分为 58.7,但属于另一参数规模组:该模型有 10 亿个参数。
在骨干网络和数据相同的受控比较中,LateOn 得分为 58.9,DenseOn 为 57.9,SPARSEUP 为 56.4。论文总结指出,SPARSEUP 分别落后 DenseOn 1.52 分、落后 LateOn 2.5 分。
SPARSEUP 在 ArguAna 和 HotpotQA 上领先 DenseOn,在 Touché 上也表现更好。在语义性更强的数据集上,该模型表现较弱;FiQA 上尤为明显。DBPedia 也被指出是其弱项。
在去污染的 BEIR 上,与 DenseOn 的差距缩小至 0.17 分。去污染的 NQ 和 MS MARCO 分别只使用了 21 个和 46 个查询,因此 Linkup 提醒,这些结果可能存在较大噪声。
稀疏度与选择标准
在 MS MARCO 上,SPARSEUP 平均每个查询使用 47 个非零词项,每个文档使用 190 个。SPLADE-v3 对应的数据分别是每个查询 25 个词项、每个文档 170 个。
搭配倒排索引 Seismic 使用时,该模型在单线程下每个查询约耗时 380 微秒,recall 达到 exact search 的 97% 以上。
如果稀疏表示和基于倒排索引的搜索很重要,可以考虑 SPARSEUP。评估时还应关注模型在目标数据集上的表现:它在语义性较强的查询、FiQA 和 DBPedia 上表现较弱。
Linkup 认为,增大向量规模或许能让 BEIR 得分提高 1–2 分。团队决定保留模型的稀疏性。
常问问题
相关材料
所有材料
交互式 XR 开发中的编码智能体评测:GenXR-Bench 结果
GenXR-Bench 已发布,这是一个包含 112 项专家级任务的基准测试套件,用于端到端评估 coding agent 在交互式 XR 开发中的表现:从功能完善和缺陷修复,到创建可在消费级设备上进行行为验证的应用。在受测的十个模型中,最佳 Pass@1 成绩为 50.9%;反复出现的失败包括处理传感器异步事件、将对象锚定到真实空间,以及理解物理情境中的交互。
5 十一月 2026
从标量奖励到帕累托前沿:基于多目标强化学习的 LLM RTL 综合
提出了一种训练语言模型的方法,使其生成一组 RTL 候选方案,在面积、延迟和功耗之间实现不同的权衡;奖励根据各方案对帕累托前沿超体积的贡献构建。在 RTLLM v2 上,相对超体积较未进行 PPA 优化的基线版本提高了 13.3 个百分点,较单目标强化学习提高了 14.4 个百分点。
5 十一月 2026
医疗 LLM 能获知指南更新,却常常仍按旧规则回答
ChronoEvo 对 1709 项临床指南变更的研究显示:在基础模型中,90.8% 的回答记录了新变化,但只有 58.5% 完整应用了这些变化;这一差距达 32.3 个百分点,并且在 14 个模型中均存在。即使提高更新内容的显著性,也未能显著提升将新规则完整纳入临床指南的比例。
4 十一月 2026