
从标量奖励到帕累托前沿:基于多目标强化学习的 LLM RTL 综合
提出了一种训练语言模型的方法,使其生成一组 RTL 候选方案,在面积、延迟和功耗之间实现不同的权衡;奖励根据各方案对帕累托前沿超体积的贡献构建。在 RTLLM v2 上,相对超体积较未进行 PPA 优化的基线版本提高了 13.3 个百分点,较单目标强化学习提高了 14.4 个百分点。
工作与状态
- 标题:基于大语言模型的多目标强化学习帕累托最优 RTL 代码生成。
- 作者:Koki Takeshita, Kenji Uebayashi, Hikaru Tomonari, Masaya Tsunokake, Koichiro Yawata, Tatsuya Sasaki, Yusuke Ohtsubo, Kota Dohi, Yasuhiro Sogawa。
- 提交日期:2026年10月16日。
- 状态:评论中注明,该论文已被 COLM 2026 接收。
预印本可通过 arXiv:2610.26904 查阅。该论文属于利用大语言模型生成 RTL 的研究。该方法训练模型输出的不是单个电路,而是一组候选方案。该组方案在 PPA 空间中进行评估。
结论:该论文已被 COLM 2026 接收,并提出了一种用于 LLM RTL 合成的多目标方法。选择方法时,关键在于目标本身的转变——从单个电路转向一组电路。
标量奖励的问题
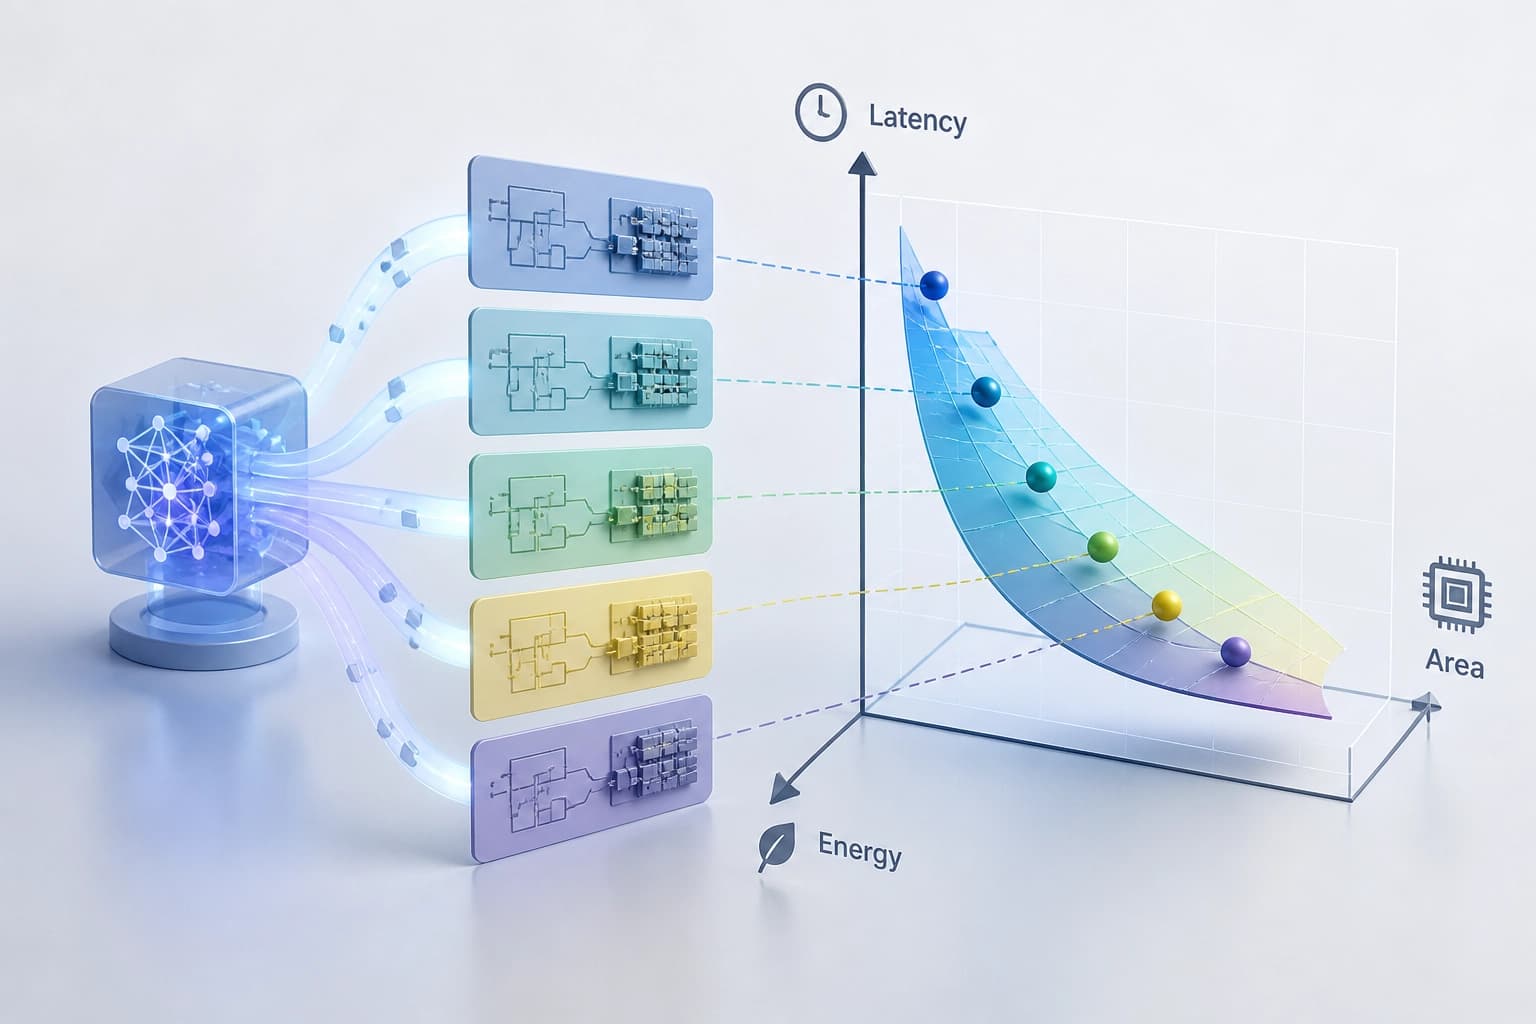
现有方法将多个目标合并为一个标量奖励。因此,很难同时获得多样且帕累托最优的解决方案。低功耗、低延迟和小面积之间的不同折中难以实现。标量奖励会在生成之前就固定各目标的重要性。
目标的相对重要性取决于产品需求和项目约束。预先合并的奖励无法随这些需求变化。因此,需要一组具有不同折中的候选方案。
| 方法 | 优化内容 | 何时选择折中方案 |
|---|---|---|
| 标量奖励 | 根据目标总和优化单个电路 | 生成前 |
| 多目标方法 | 帕累托前沿上的一组电路 | 生成后 |
结论:标量奖励会在生成前固定折中方案。多目标设定则将选择推迟到生成之后。
该方法优化什么
该方法优化整组电路的质量和多样性。通过多次生成得到这组方案。评估在 PPA 目标空间中进行:功耗(Power)、性能(Performance)、面积(Area)。该方法并非针对单个电路的质量进行优化。
PPA 目标之间存在折中。不同电路会带来低功耗、低延迟和小面积的不同组合。因此,该方法训练模型覆盖帕累托前沿上的不同点。设计人员可以获得多个候选方案。
结论:该方法的目标是覆盖前沿,而非给出一个最佳答案。
该方法的两个要素
基于生成的训练流程
该流程将提升整个帕累托解集覆盖度的问题,转化为逐步生成电路的任务。训练按步骤进行。生成任务因此具有了序列结构。
基于 Hypervolume Contribution 的奖励
HVC 奖励函数衡量生成的电路对帕累托前沿的贡献。奖励反映的不是单个电路的绝对质量,而是覆盖度的增量。HVC 将训练与前沿覆盖度联系起来。
结论:训练流程规定了序列,HVC 则提供了体现覆盖贡献的信号。
RTLLM v2 上的结果
在 RTLLM v2 基准测试上的评估显示,相对 Hypervolume 有所提升。相较于未进行 PPA 优化的基线,提升了 +13.3 个百分点;相较于单目标 RL 方法,提升了 +14.4 个百分点。作者还报告称,该方法在电路多样性方面表现更优。
| 对比对象 | 相对 Hypervolume 提升 |
|---|---|
| 未进行 PPA 优化的基线 | +13.3 个百分点 |
| 单目标 RL 方法 | +14.4 个百分点 |
结论:在 RTLLM v2 上,该方法提升了前沿覆盖度和多样性。上述数字针对的是相对 Hypervolume,而非每个电路的绝对质量。
实际选择标准
选择方法时,应看折中方案在何时确定。标量奖励要求在生成前设定 PPA 各目标的重要性。多目标方法则将选择推迟到生成之后,并提供一组具有不同折中的候选方案。
该方法的评估仅限于 RTLLM v2 基准测试。应用于其他设计流程时,需要进行针对性验证。未经验证,不应将提升数据直接套用到其他条件下。
结论:如果不同产品和项目对 PPA 的要求各不相同,多目标方法适用于生成后再进行选择的任务。如果各目标的重要性已知且固定,那么标量奖励适用于预先设定折中方案的情况。
常问问题
相关材料
所有材料
交互式 XR 开发中的编码智能体评测:GenXR-Bench 结果
GenXR-Bench 已发布,这是一个包含 112 项专家级任务的基准测试套件,用于端到端评估 coding agent 在交互式 XR 开发中的表现:从功能完善和缺陷修复,到创建可在消费级设备上进行行为验证的应用。在受测的十个模型中,最佳 Pass@1 成绩为 50.9%;反复出现的失败包括处理传感器异步事件、将对象锚定到真实空间,以及理解物理情境中的交互。
5 十一月 2026
医疗 LLM 能获知指南更新,却常常仍按旧规则回答
ChronoEvo 对 1709 项临床指南变更的研究显示:在基础模型中,90.8% 的回答记录了新变化,但只有 58.5% 完整应用了这些变化;这一差距达 32.3 个百分点,并且在 14 个模型中均存在。即使提高更新内容的显著性,也未能显著提升将新规则完整纳入临床指南的比例。
4 十一月 2026
封闭式 LLM 智能体的世界模型:在风险点进行校正
提出了 PAWM——一种外部预测器,不会重复逐步观察,而是在可能发生故障时介入,引导智能体避开错误操作。经过基于合成场景的 SFT 和 GRPO 协同训练后,该方法使 Claude Sonnet 4.5 在 ScienceWorld 和 WebArena-Lite 上分别提升了 24.3% 和 7.7%。
4 十一月 2026