模拟器跟不上真实系统
部署一个真实集群来服务大语言模型既昂贵,往往也根本不可能:没有硬件、没有预算、没有时间等。因此,系统建模早已成为研究者的日常工具:先在模拟器上算,再上真机。
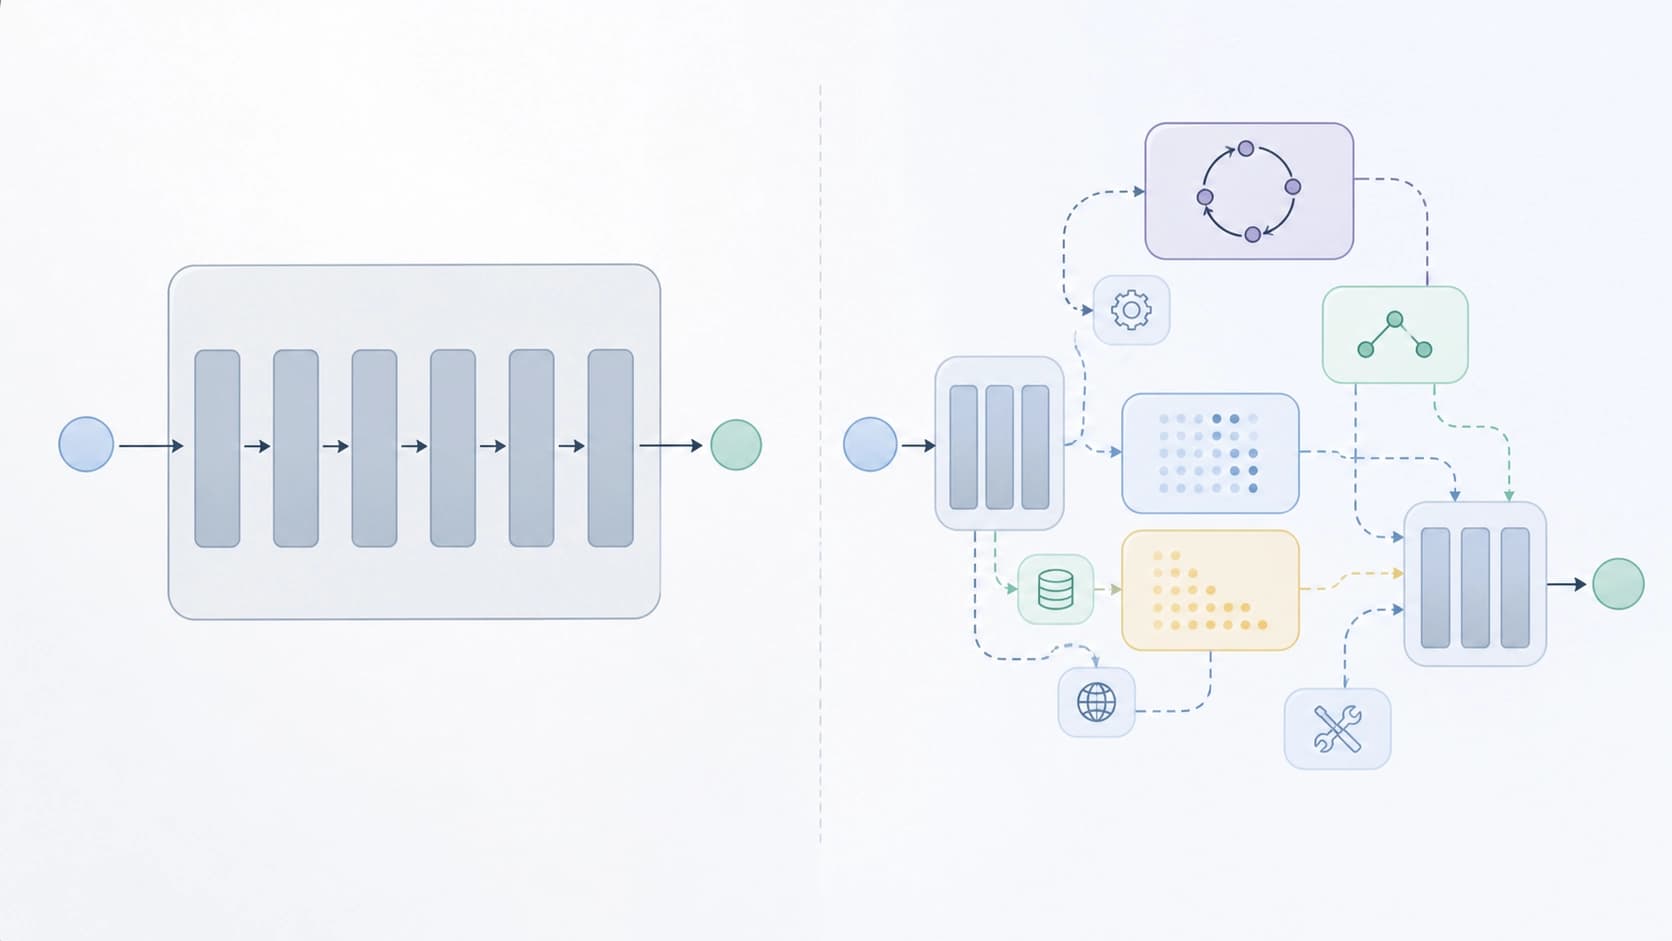
问题在于,这个领域本身的发展速度比模拟器的开发速度更快。新的工作负载——模型调用工具并循环运行的智能体场景、prefill 与 decode 阶段分离的方案——已经无法塞进现有模拟器所采用的单体式流水线。任何新机制都得靠痛苦地重写内核从侧面硬接上去。结果就是,生产环境里实际运行的东西与模拟器能复现的东西之间的差距只会越来越大。
思路:一个能自我扩展的模拟器
一个研究团队着手解决这个问题——Wonung Kim、Hyunmin Choi、Minsu Kim、Jaehong Cho、Yeongwook Kim 和 Jongse Park。他们的预印本 arXiv:2608.24650(cs.AR、cs.AI)名为《Simthesizer: An Agent-Driven Simulation Framework for LLM Serving Systems》。
这里的核心思路转折是这样的:不必再为当下这一套机制写一个新的模拟器——它会在发布之前就过时。需要把 Simthesizer 构建成能够随着新需求的出现而自我扩展。而且不是靠一个要花一个月读别人代码的程序员,而是靠一个能理解自然语言表述的需求、并能在模拟器内部处理它的智能体。
用一个动态图取代一组模块
这一思路的技术基础是可组合的基础设施。在 Simthesizer 中,整个服务流程被统一表达:不仅是计算本身,还有协调这一流程的控制决策——也就是调度器、处理顺序、资源分配。所有这些都被描述为一个动态图,并在模拟过程中不断变化。
实际好处显而易见:当新功能不需要硬接到子系统之间写死的接缝上,而只需在整体图景中添加一个节点时,扩展成本会下降几个数量级。此前正是这里出现了“侵入式重写”——所有逻辑散落在代码各处,任何新机制都会牵动半个模拟器。
合成器智能体:用语言提需求,而不是 fork 代码
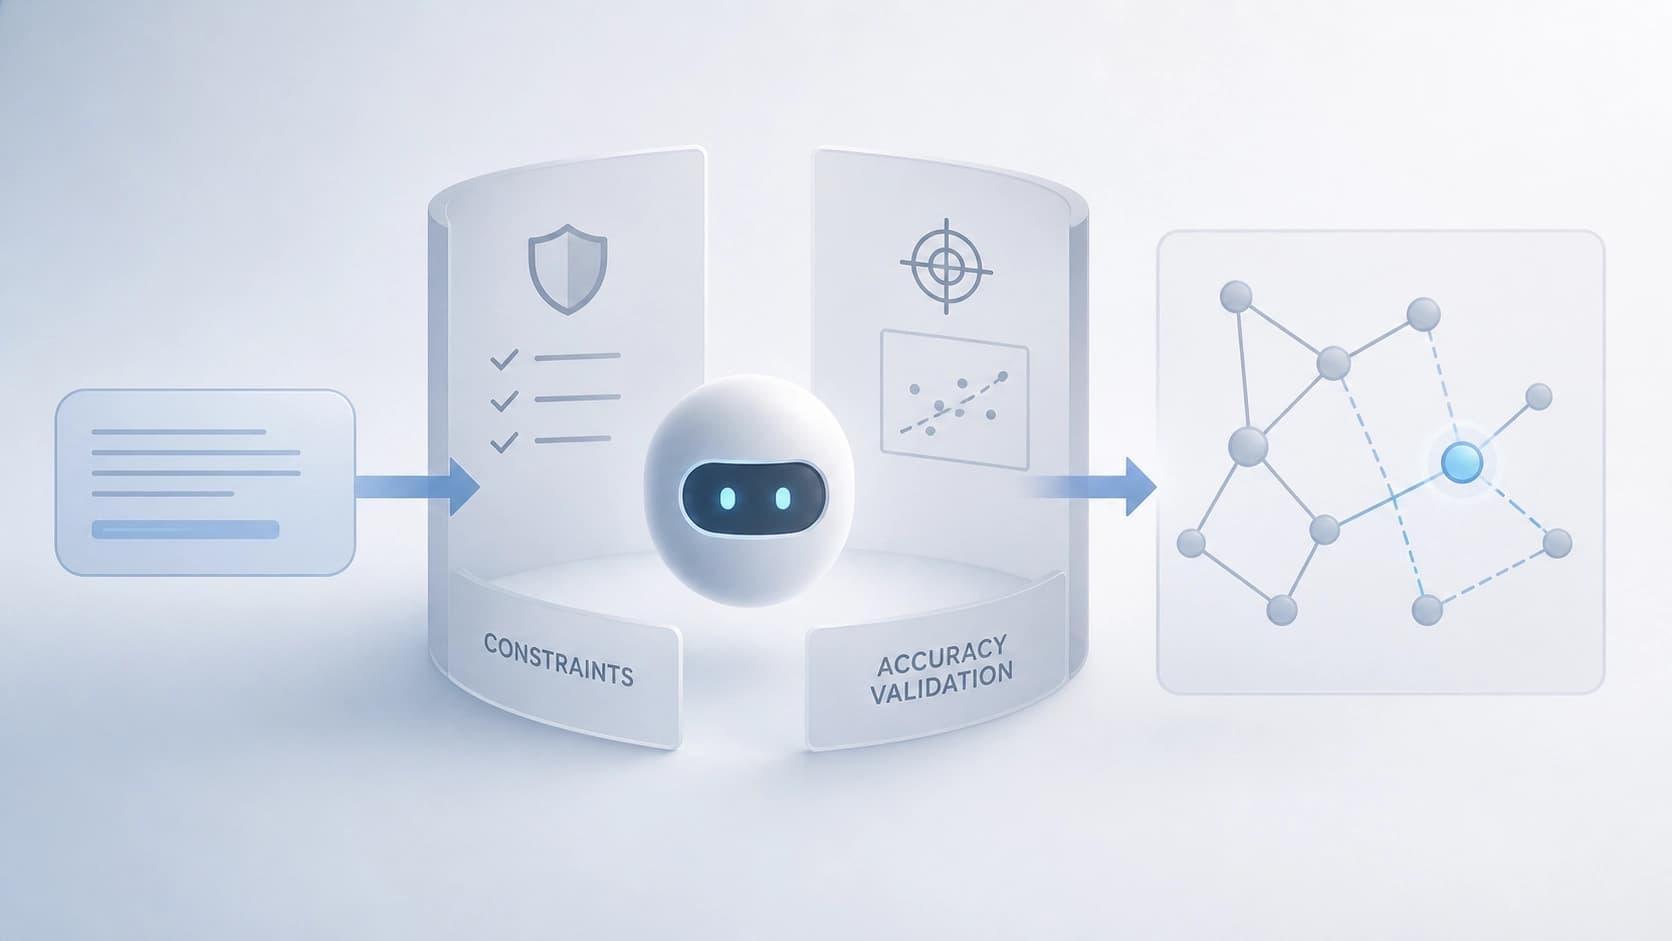
第二个要素是 Synthesizer agent,作者将其描述为“被套上缰绳的编码智能体”(harnessed coding agent)。它的任务是把用普通人类语言表述的功能需求,转换为模拟器内部的那套抽象表示。
这里的关键词是“被套上缰绳”。智能体不能想写什么就写什么:它在特定于该模拟器的约束内工作,其结果还要经过建模精度验证(fidelity validation)。没有这一步,整个构想就会变成一个生成看似合理、实则错误代码的生成器。还有一个重要细节:智能体是在发展同一个通用模拟器,而不是为每个功能都繁殖出一个新的——否则我们只会得到同一个互不兼容的 fork 动物园,只不过是由机器自动创建的。
效果如何
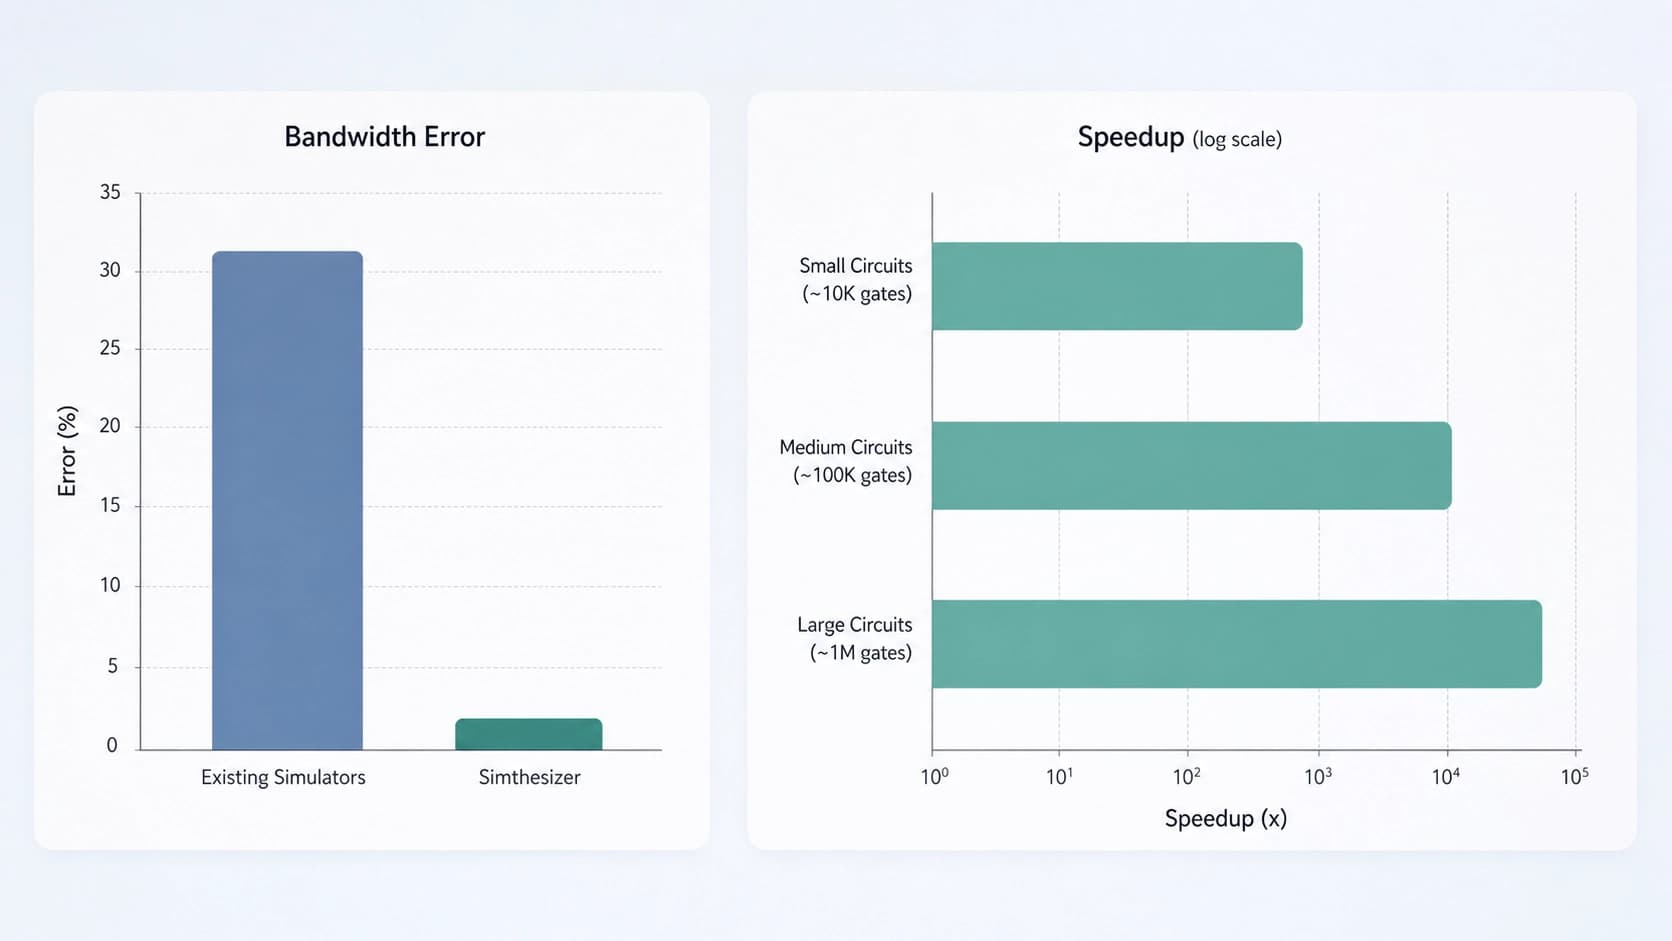
作者不是在合成数据上验证这一方法,而是与真实系统对比。基于 Simthesizer 构建的扩展复现了基于 vLLM 的系统,吞吐量平均误差为 2.51%。而基于现有模拟器的扩展,同一指标为 6.03%。差距超过两倍,而且使用的是同一个编码智能体、同样的外围封装:也就是说,带来优势的正是模拟器的架构,而不是碰巧选对了执行模型。
速度同样令人印象深刻。在相同工作负载下,Simthesizer 的建模速度比 LLMServingSim2.0 快达 284.96 倍,比 Vidur 快达 23.19 倍。这样的数量级改变了研究本身的性质:不再是“跑一次然后干等”,而是可以遍历数十种配置并相互比较场景。
这改变了什么,以及需要记住什么
如果这一方法流行起来,变化不仅体现在数字上,也体现在工具本身的角色上。模拟器将不再是那个落后现实一两年、苦苦追赶的冻结产物,而会成为一个可以通过一次对话就调整以适应新任务的系统。对于设计推理基础设施的人来说,这意味着更便宜的假设验证循环:不必先搭好测试台才能知道一个想法是否划算。
但也有一些作者留在括号之外的问题。精度验证能否可靠地捕捉智能体的细微错误——比如当新节点形式上能工作,却在某种负载与时序组合下悄悄改变了行为?这一方法如何迁移到硬件特定的东西上,比如非标准加速器?最后,信任问题仍然悬而未决:当模拟器越来越多地自己编写自己时,总得有人能读懂最终得到的东西。
而目前的结果简单明了:“可组合架构加上权限受限的智能体”这一组合,比上一代精心打磨但僵硬的模拟器,既能给出更精确、也明显更快的建模。这正是那种与其换模型、不如换工具构造本身的情形。