嵌套数据与因果推断的老问题
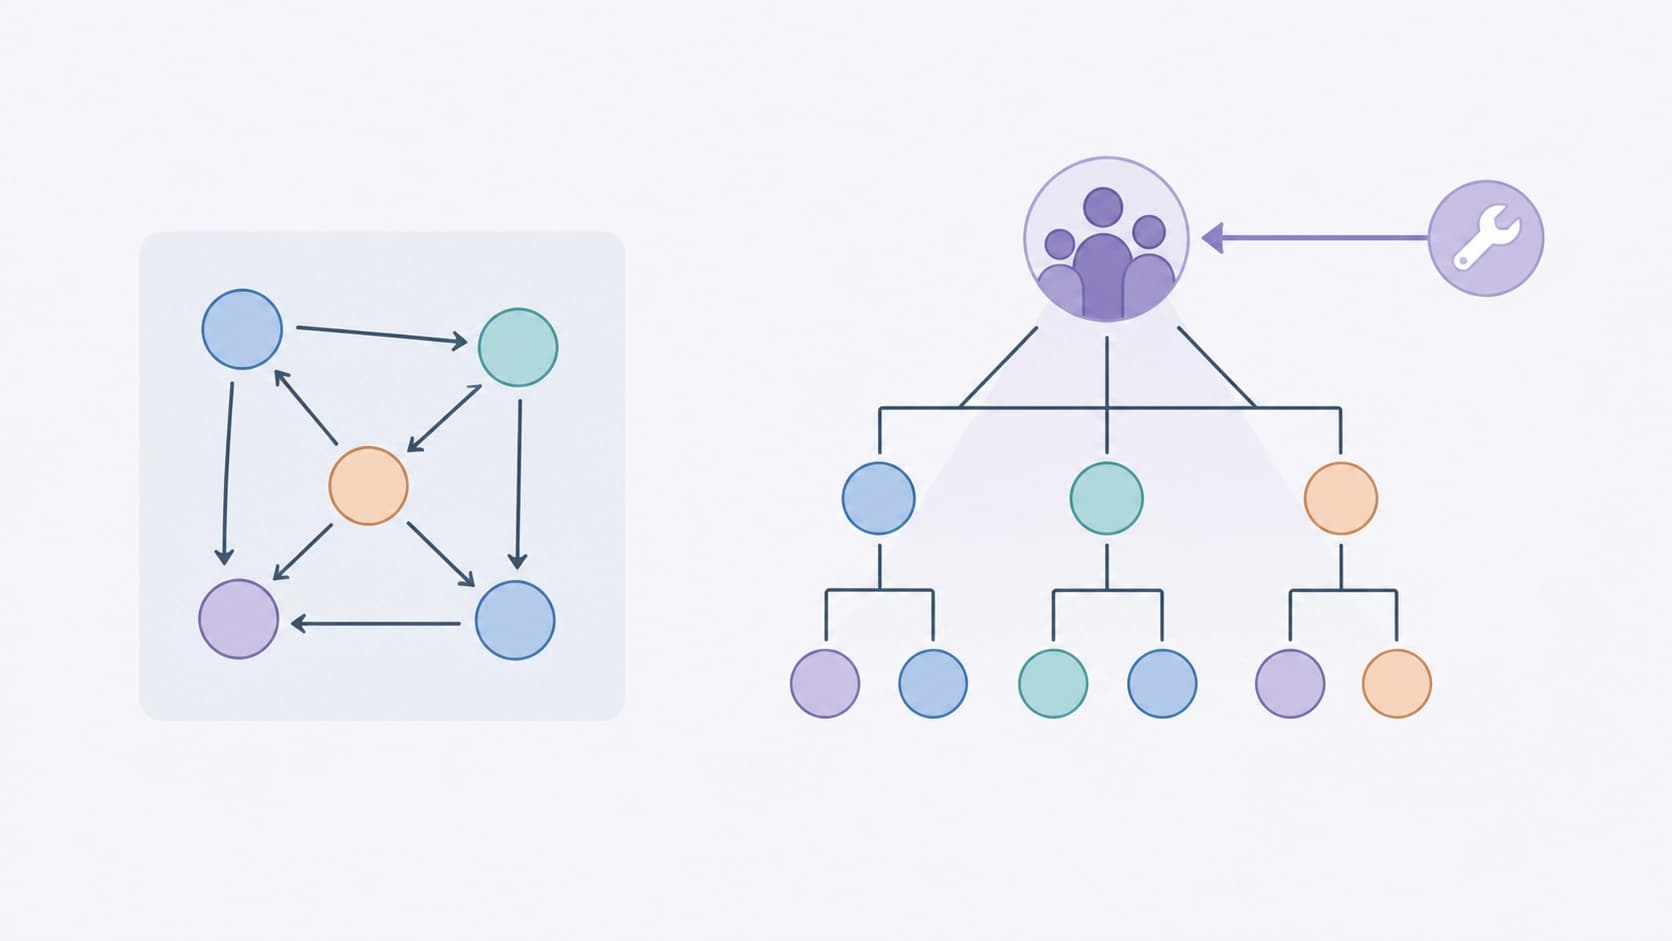
经典因果推断方法在观测彼此独立时表现良好。但一旦数据有了层级结构——班级里的学生、诊所里的患者、部门里的员工——朴素的做法就会开始骗人。共同的群组会在对象之间制造相关性,模型会错误地把它当作信号,而发生在高层的干预(比如改变整个班级的条件)根本无处"接入"。
这正是 stat.ML 板块新预印本 arXiv:2608.24500 所讨论的内容——《Scalable and Versatile Identification for Hierarchical Structural Causal Models: A New Look at Project STAR》。该工作于 2026 年 8 月 25 日发布,由九位作者共同完成——Janis Aiad、Aghiles Drali、Aymen El Ouadrhiri、Anass Ettahiri、Yasser Oufqir、Simon Patry、David Cortes、Marianne Clausel 和 Emilie Devijver。提供 PDF、HTML 版本和 TeX 源码;主题为机器学习与人工智能。
这份材料的有趣之处与其说在于又一个模型,不如说在于它试图搭建一条完整、可复现的流水线:从图的形式化表示,到可以在论文或给客户的报告中站得住脚的具体数字。
作者提出了什么
这里说的是面向层级结构因果模型(HSCM)的流水线。它是开放的,并且被设计为可扩展的:同一套逻辑既要能撑得住小小的教学示例,也要能处理群组数量庞大的数据。
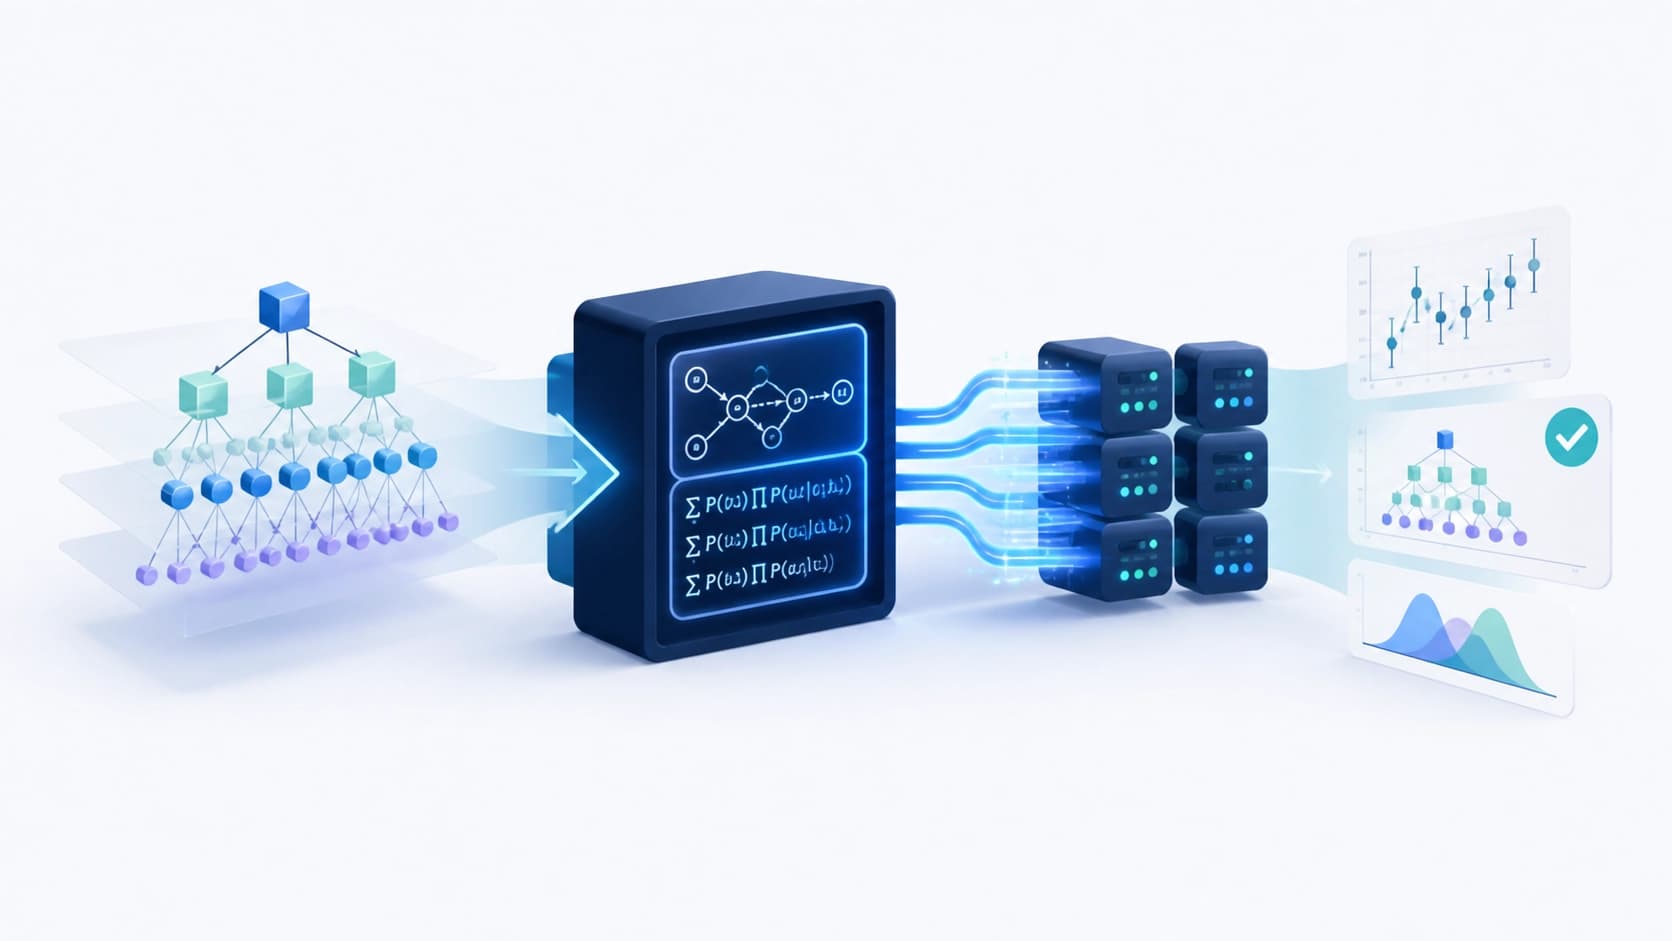
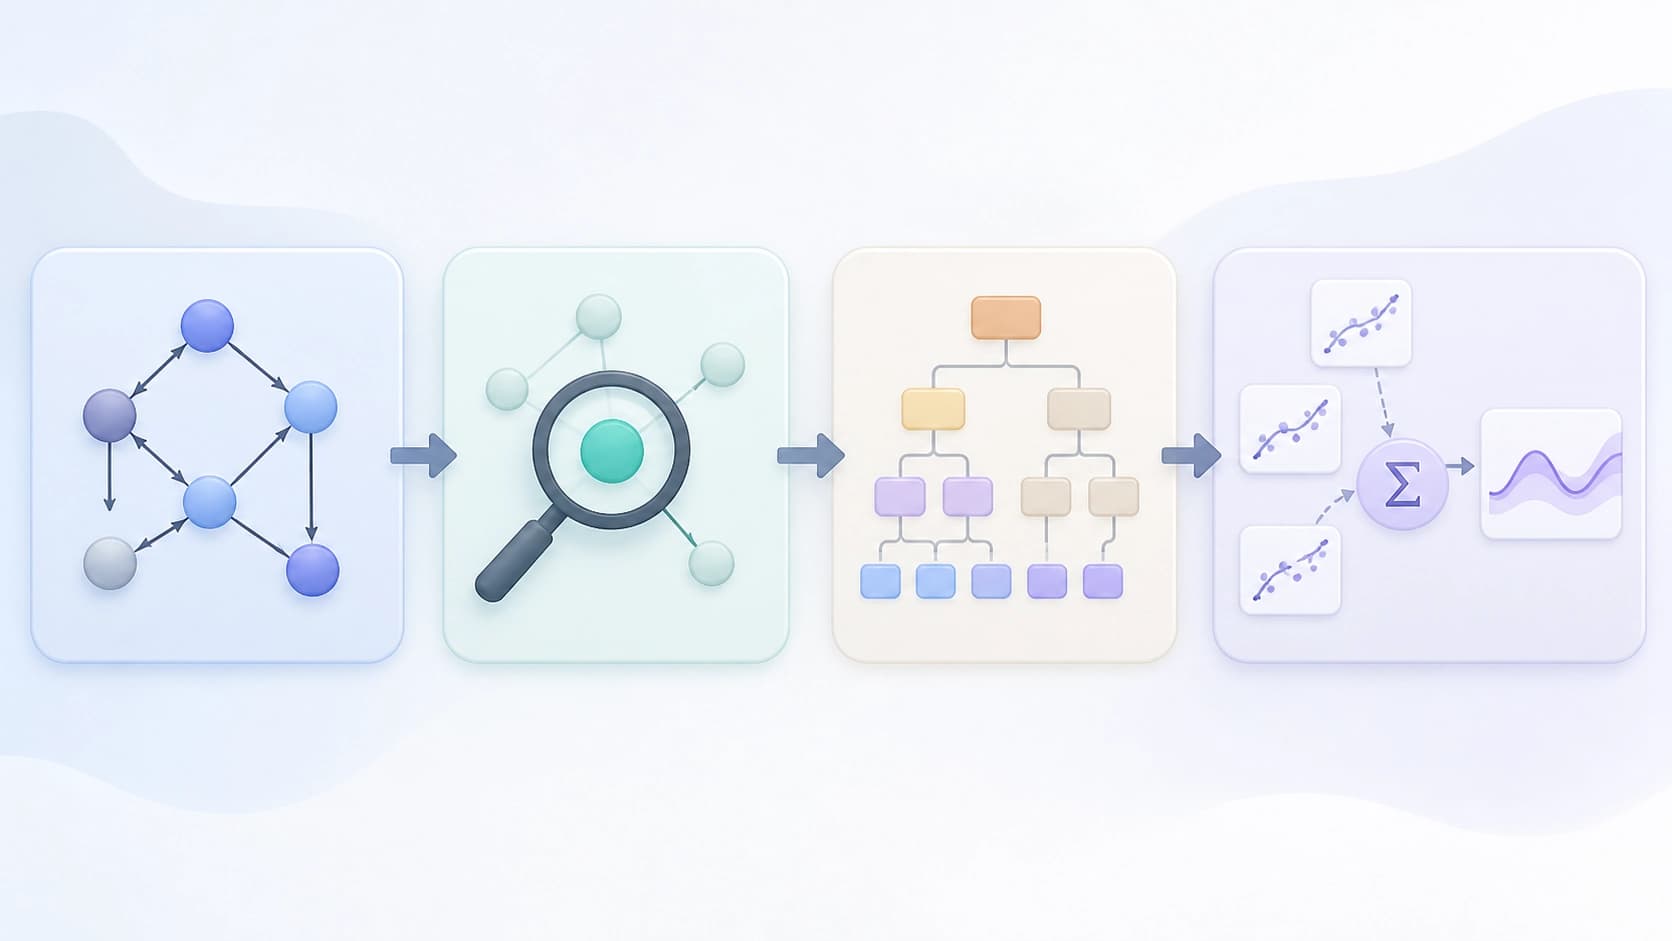
这套构造由四个层组成:
- 图变换——准备描述各层级之间依赖关系的结构;
- 通过 pyAgrum 库中的 do-calculus 进行符号识别——机器自行判断哪些效应原则上可以从现有数据中推断出来,并给出相应的表达式;
- 将该表达式转换为 HSCM 的闭式公式——符号结果被转化为在层级模型框架内可计算的东西;
- 基于已经拟合好的局部概率模型进行数值估计。
这里的逻辑本质上是两阶段的。首先弄清楚效应在原则上是否可识别——这是数学问题,不是数据问题。只有在此之后才轮到统计:估计、误差、稳健性。
抽象语法树作为扩展性的关键
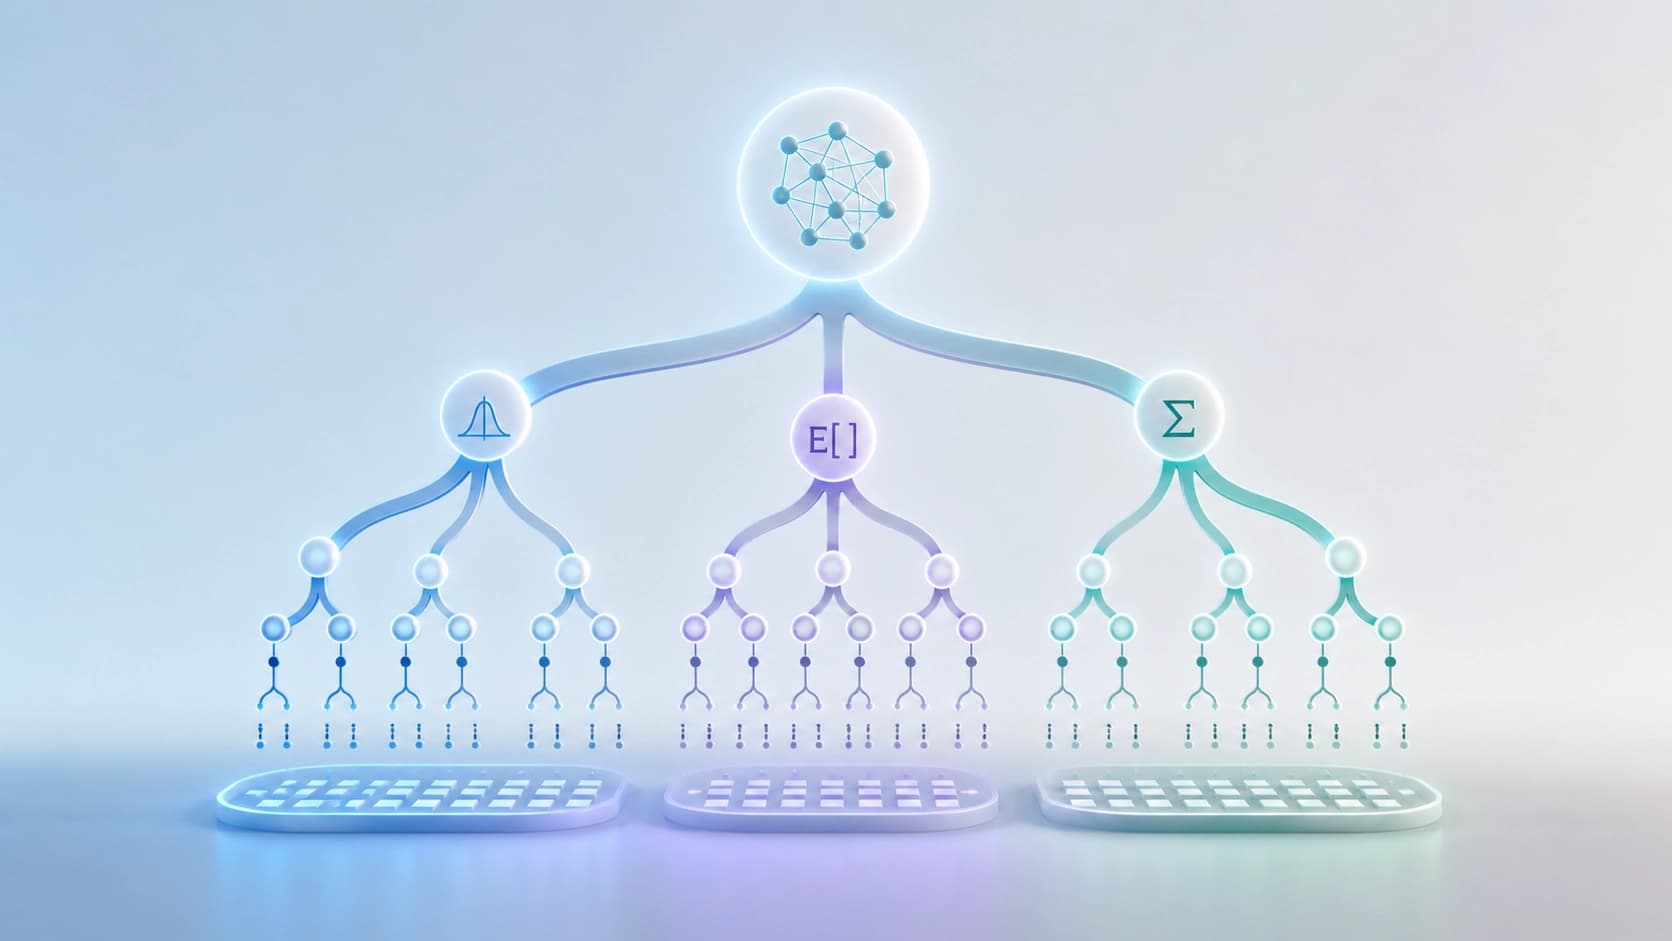
该工作的主要技术发现是经过改造的抽象语法树(AST)。从 pyAgrum 得到的已识别公式不会"硬算":它被拆解成一棵树,而树的叶子变成三类相互独立的子任务——密度计算、数学期望计算和边缘化。
为什么这很重要?得到的子任务可以并行计算,中间结果可以缓存。不再是单个庞大表达式(其中早期步骤的错误会一路毁掉后面的一切),而是出现了一组相互独立的片段,每一块都可以单独验证。本质上,作者把算力问题变成了计算组织问题。
在 Project STAR 上的验证
作为有实质内容的示例,选取了 1985 年在美国田纳西州开展的 STAR(Student-Teacher Achievement Ratio)实验。这是一个标杆性的层级数据集:它本就是为了评估班级规模对成绩的影响而创建的,其中的观测嵌套于班级之中。这种结构是 HSCM 的完美试验场,因为这里的干预天然发生在班级层面,而非单个孩子层面。
在转向真实数据之前,作者先在 HSCM 的经典 motif 和答案已知的基准场景上检验流水线。这是合理的顺序:先确认方法能在已知答案的地方找到正确答案,然后才应用到无从验证的数据上。最终的应用是 STAR 框架下幼儿园的数学成绩。
结果说明了什么
结论令人清醒,而这正是其价值所在。
第一,忽略层级结构的扁平基线模型能恢复出关联——但无法在班级层面编码干预。"班级越小、分数越高"的相关性与缩小班级带来的因果效应是两回事,前者不能替代后者。
第二,仅有符号识别是不够的。即使公式被正确推导出来,要用于实际的层级推断,还需要一个能运转的数值层。
由此引出第三个论点:可扩展的估计与数值稳健性检验不是方法的附加项,而是其核心部分。一个无法计算、或者数据稍有变动就崩溃的漂亮表达式,没有科学价值。因此流水线才如此重视计算的分解与稳健性的控制。
为什么这在 STAR 之外也有用
层级数据出现的频率远比想象中高。教育、医疗、带聚类的 A/B 测试、按地区的民意调查、按批次的工业测量——处处都有嵌套,也处处都有为了简单而忽略它的诱惑。
这项工作的价值在于,它提供的不是某个单独的技巧,而是一套可复现的流程。开放的代码、通过 pyAgrum 进行的自动识别、向可计算公式的形式化转换、相互独立的子任务——这些加在一起降低了门槛:研究者不必再为每一种新的图结构亲自推导公式。
局限与常识
需要记住,这是预印本,而非经过同行评审的出版物:arXiv:2608.24500 的 v1 版本,DOI 10.48550/arXiv.2608.24500。在经典 motif 和单一数据集上的结果是一次不错的检验,但不是普适的证明。
此外,任何因果推断都依赖于关于图结构的假设。流水线自动化了计算并使其更透明,但并不能取消"我们对世界的描述到底对不对"这个问题。如果图是错的,那么被精心计算出来的效应,终究只是一个被精心计算出来的谬误。
正因如此,这篇文章最主要的实践结论听起来很接地气:没有估计的识别毫无用处,没有稳健性的估计充满风险,而嵌套数据需要在模型中有一个单独的层级,否则群组层面的干预根本无从对应。