SEATauBench 是什么
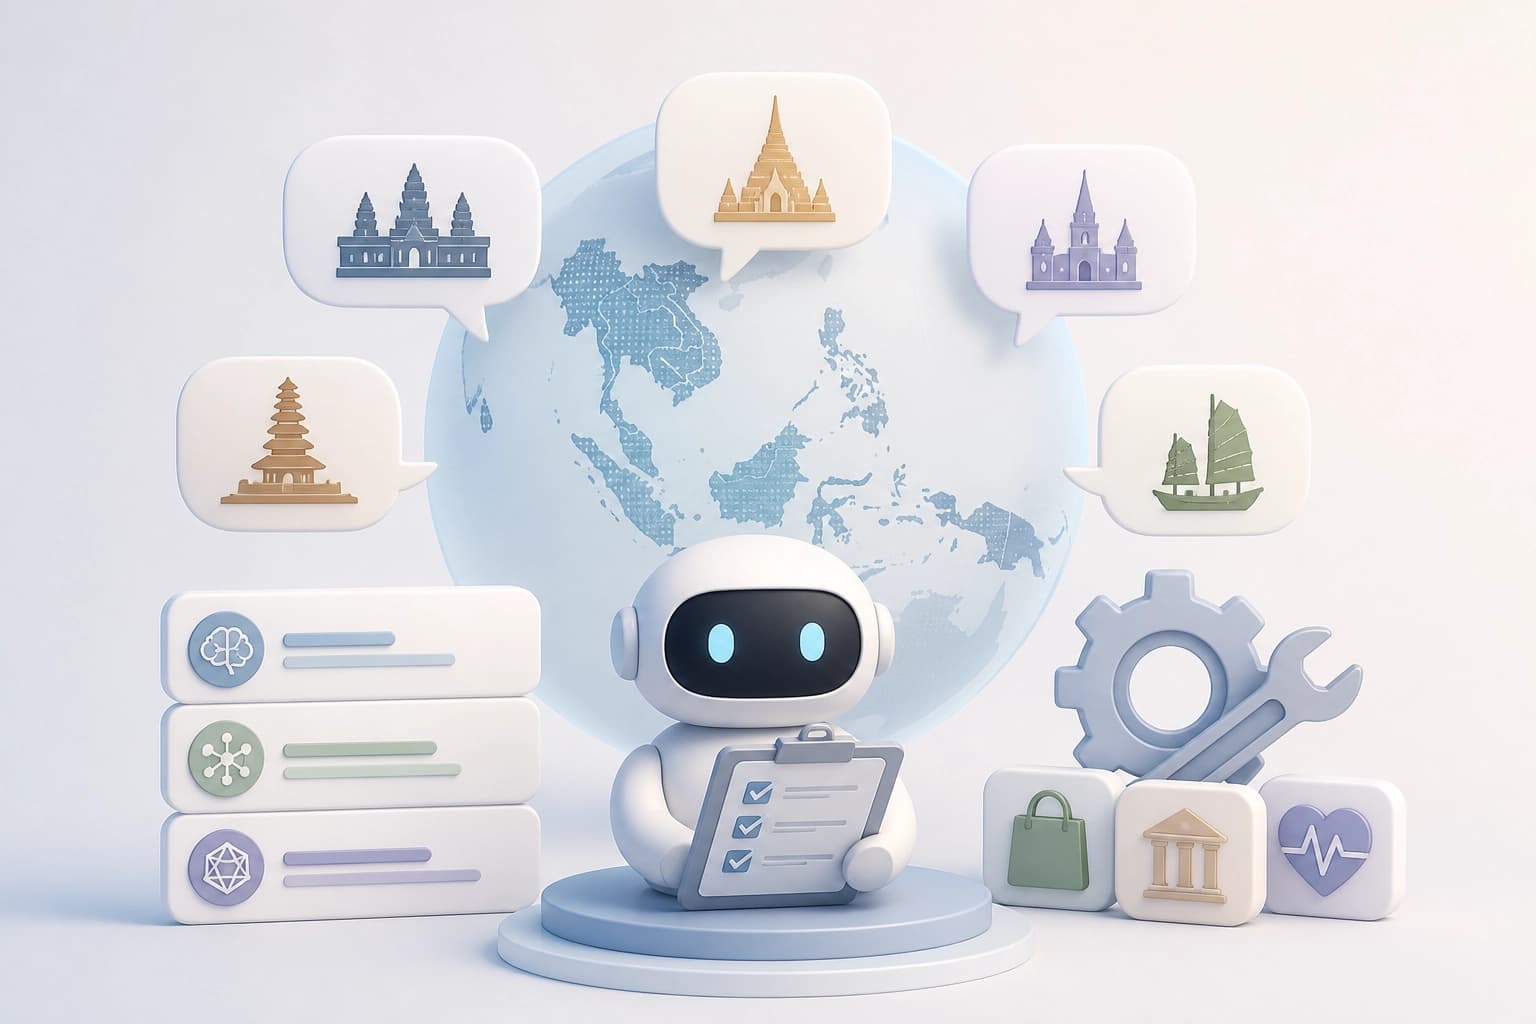
SEATauBench 是首个面向东南亚主权 AI 的智能体评测系统。它将 Tau2-Bench 适配到五种语言:中文(普通话)、越南语、泰语、印度尼西亚语和菲律宾语。
该基准旨在评估智能体在该地区的语言和领域语境中的表现。判断其是否适用的一项实用标准是:所测试的语言是否符合目标受众的语言。
评估中会改变哪些条件
研究人员逐步对智能体的工作语境进行本地化。他们会改变三个要素:
- 用户与智能体之间的交互语言;
- 工具规范;
- 任务领域。
这种设计不仅能检验对话语言的变化,还涵盖工具和任务主题的变化。
结果显示了什么
研究评估了三种模型。作者比较了智能体的能力在不同本地化程度下如何变化。
| 评估条件 | 结果 |
|---|---|
| 仅更改对话语言 | 英语能力的迁移效果较好 |
| 本地化额外语境 | 性能和稳健性大幅下降 |
| 完全适配领域 | 观察到的能力损失最大 |
作者指出,仅用英语进行评估,对预测智能体在东南亚语言中的能力作用有限。因此,英语测试结果不能取代在本地化条件下进行的测试。
基准的用途
SEATauBench 被定位为一个诊断性基准和可重复使用的适配流程,旨在构建可靠的多语言智能体。
选择评估方案时,本地化的覆盖范围十分重要:对话语言、工具规范和任务领域。仅测试语言变化无法反映语境全面适配后的结果。
发表信息和版本
论文发表于 EMNLP Findings 2026。v1 版本于 2026 年 6 月 27 日提交,最新的 v2 版本于 2026 年 9 月 5 日发布。
论文标识符:arXiv:2606.28715。