为什么智能体需要另一种测量方式
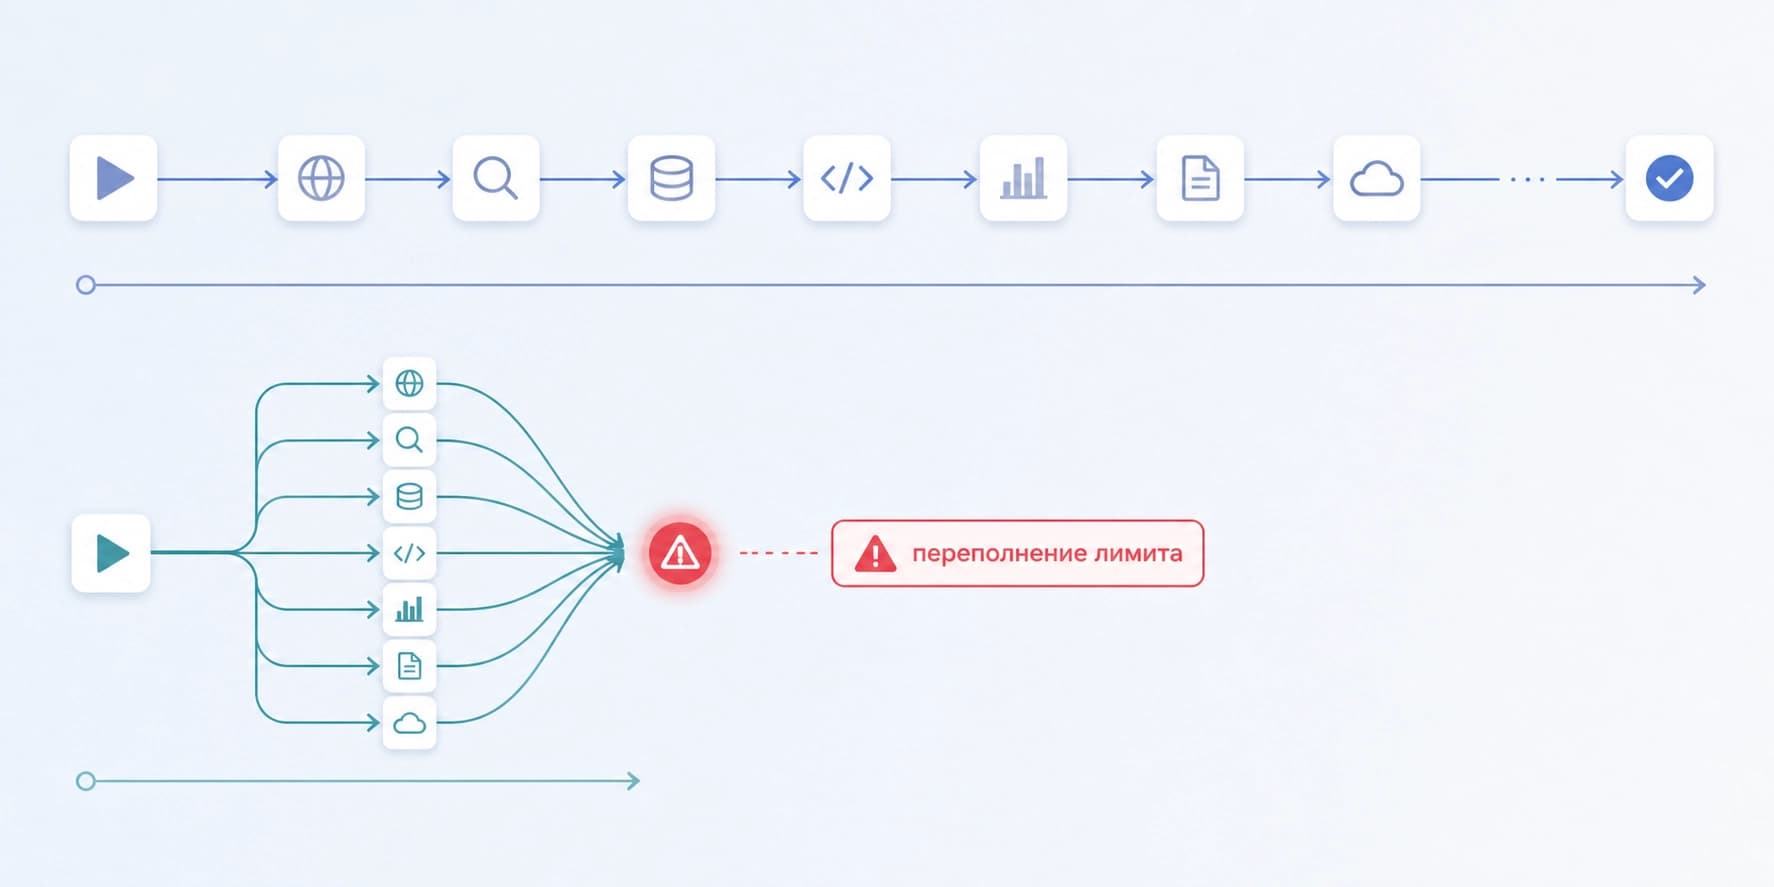
大多数智能体基准测试回答的是显而易见的问题:模型是否选择了正确的工具,是否正确收集了参数,是否达到了预期结果。几乎所有这类测量都围绕顺序执行构建——一次调用接着一次,不慌不忙,也不争抢资源。
实际运行却截然不同。为了将延迟控制在可接受范围内,智能体不得不并行发起相互独立的调用。但无视限制的并行会撞上另一堵墙:配额耗尽、内存溢出、外部服务掉线。
PeakBench 正是针对这一盲区。作者 Zhi-Kai Chen、Xu-Xiang Zhong、Song-Yan Li、De-Chuan Zhan 和 Han-Jia Ye 在 arXiv 预印本 arXiv:2608.24509(2026 年 8 月 25 日 v1 版,分类为 cs.AI 和 cs.SE)中对此进行了描述;代码承诺将随论文一同发布。
整项工作的出发点是一个核心观点:智能体有两种失败方式,而它们彼此相反。顺序执行安全但缓慢——之所以不会超出限制,仅仅是因为没有任何东西同时运行。不考虑资源的并行执行速度快,却会导致本可轻易避免的溢出。而在这两个极端之间,正是无人真正测量过的地带。
这个基准测试是什么
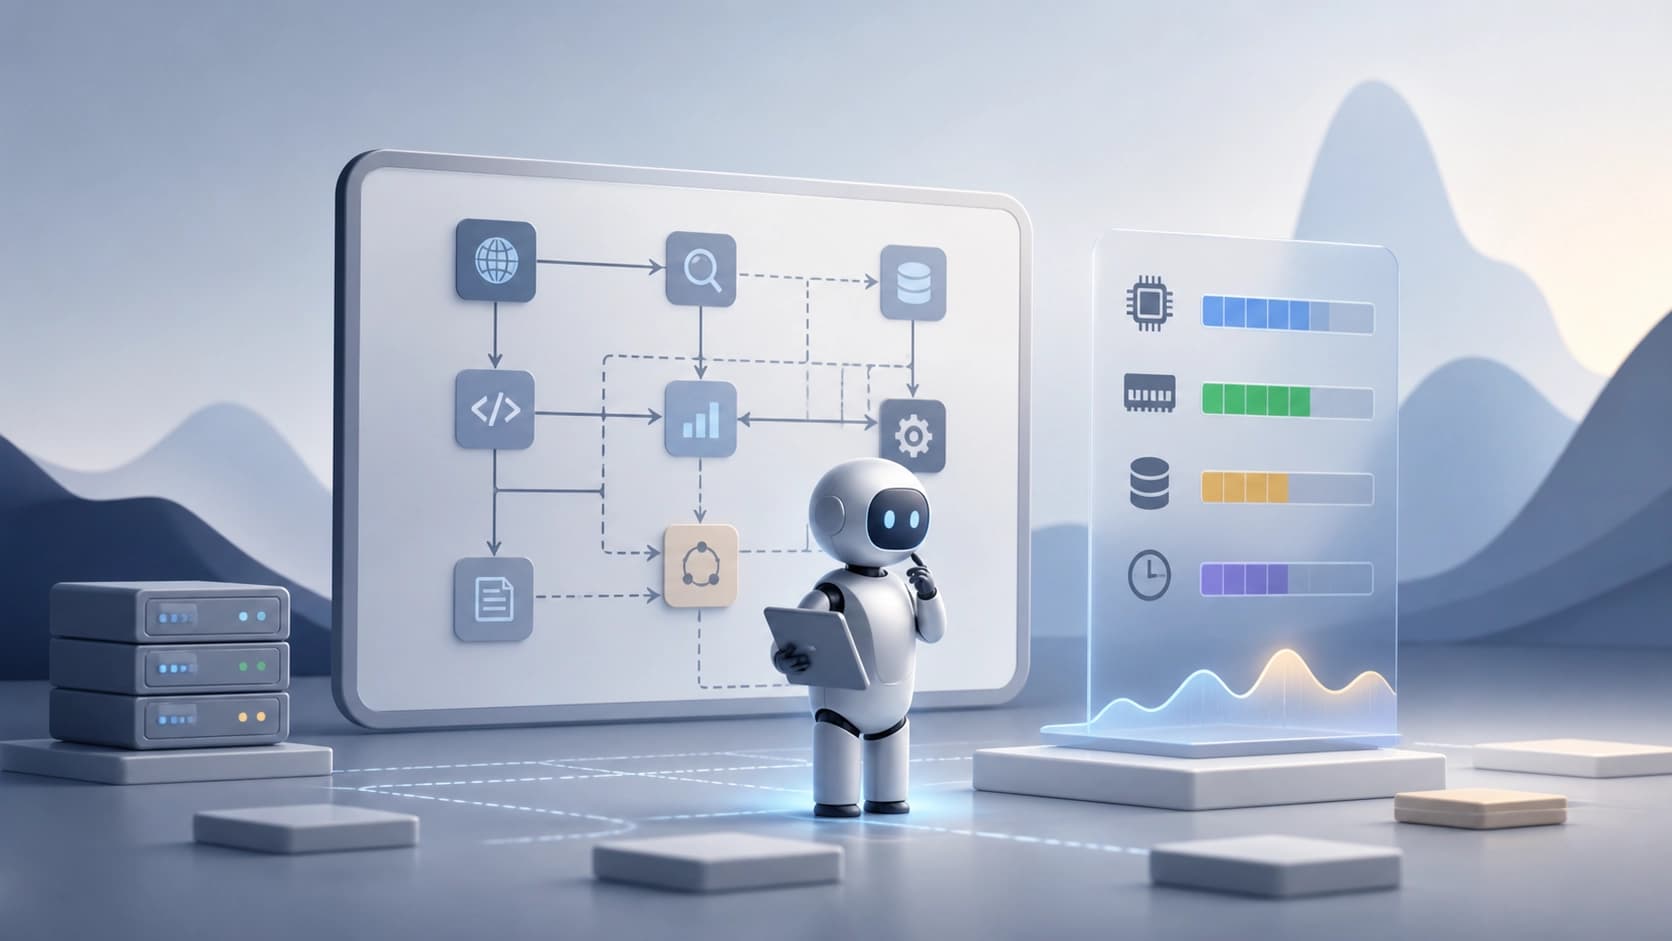
这里不使用带标准答案的静态任务,而是采用可执行的多工具工作流。每个工作流都有两个重要的附加组件:依赖关系标注,显示哪些步骤之间确实存在关联;以及实测的资源画像——某次具体调用会消耗多少内存、时间或配额。
这种设计改变了评估的对象本身。“是否得到了正确答案”这一问题退居其次,首要问题变成了“智能体如何将工作分配到时间轴上,以及是否超出了预算”。
逻辑规划与物理规划
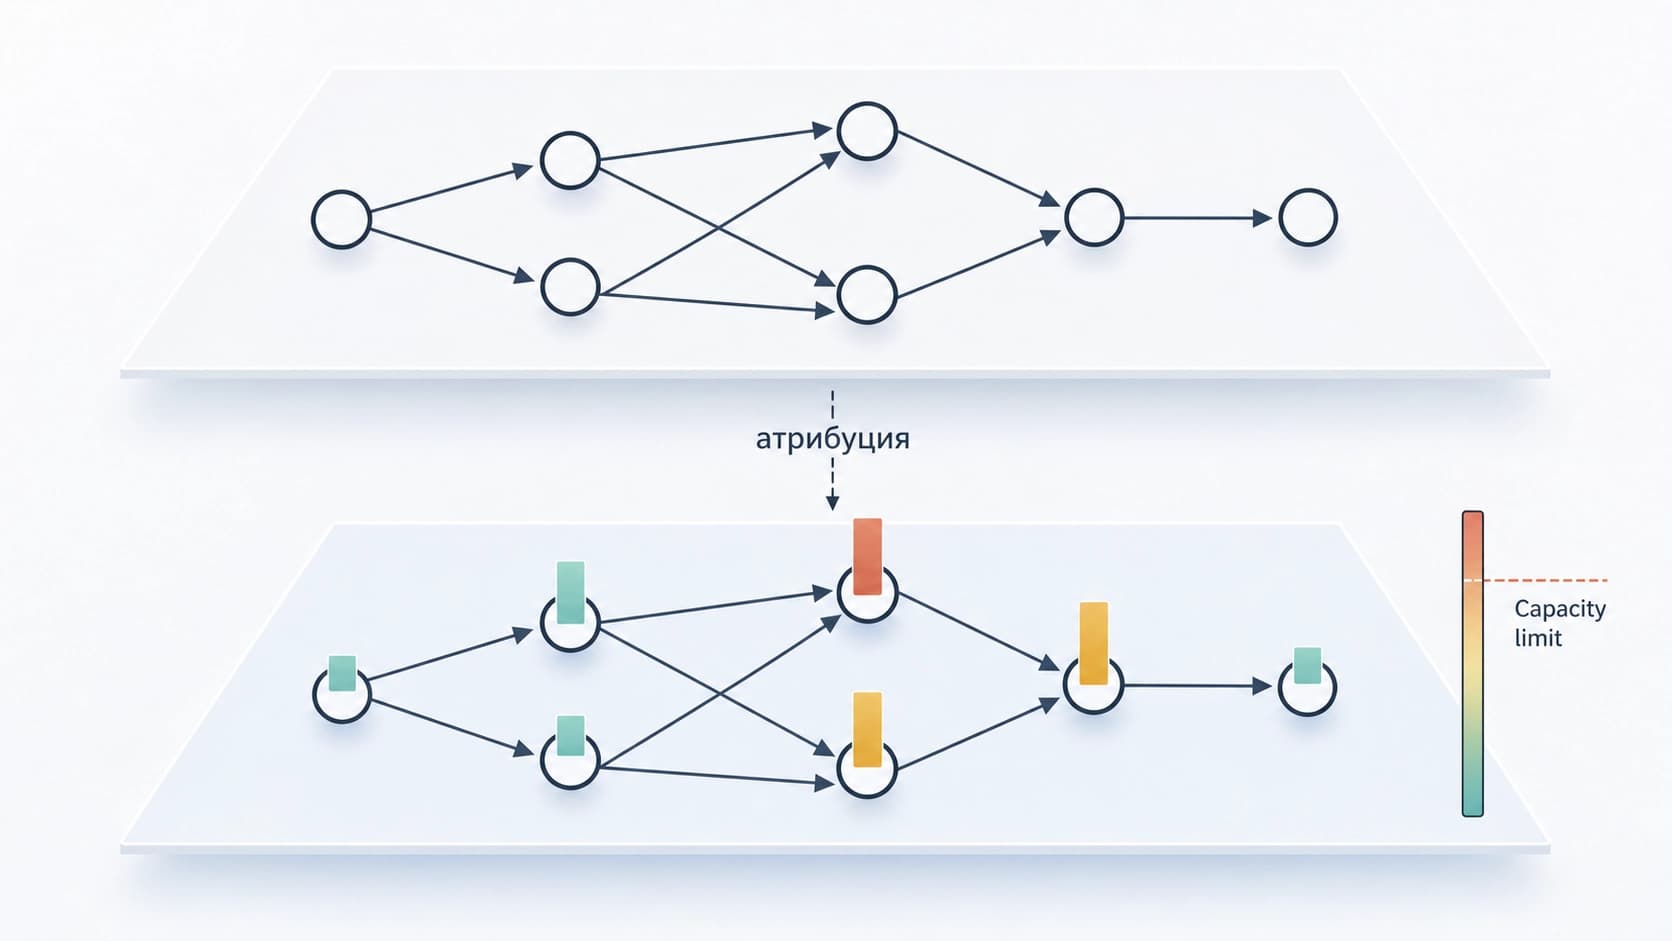
评估此类流程的核心难点在于归因。当一次运行崩溃时,不清楚究竟该归咎于什么:是智能体错误地解析了依赖关系,还是解析正确但没有考虑可用资源,又或者两者兼有。把所有情况都塞进一个成功指标里,就意味着丢失最有价值的信息。
因此评估被分为两部分。一个维度负责逻辑规划:步骤顺序、依赖关系的正确性、不存在凭空捏造的关联。另一个维度负责物理规划,即考虑真实约束的调度。这两个维度各有自己的指标,一个维度的失败不会掩盖另一个维度的成功。
顺序错误和预算错误是两种不同的病症
这种两分方案不是为了漂亮的分类学,而是为了诊断。如果智能体在逻辑层面出错,跟它讲配额大小是没用的——它根本没理解什么依赖什么。如果逻辑没问题,但执行崩溃了,那问题就出在调度器,或者出在向智能体告知可用资源的方式上。
对于构建智能体系统的人来说,实用结论是:在着手修复之前,应当先弄清楚故障属于这两个层面中的哪一个。提示词工程、轨迹训练和工具修改,治疗的将是完全不同的毛病。
主要结果:严谨的逻辑并不能免于过载
这项研究最令人不快的结论是:强大的逻辑规划并不能保证在资源受限条件下实现安全或高效的执行。智能体可以完美地构建出依赖图——却仍然会因为同时启动所有没有边相连的节点而拖垮整个系统。
公开资源信息可减少可预防的溢出
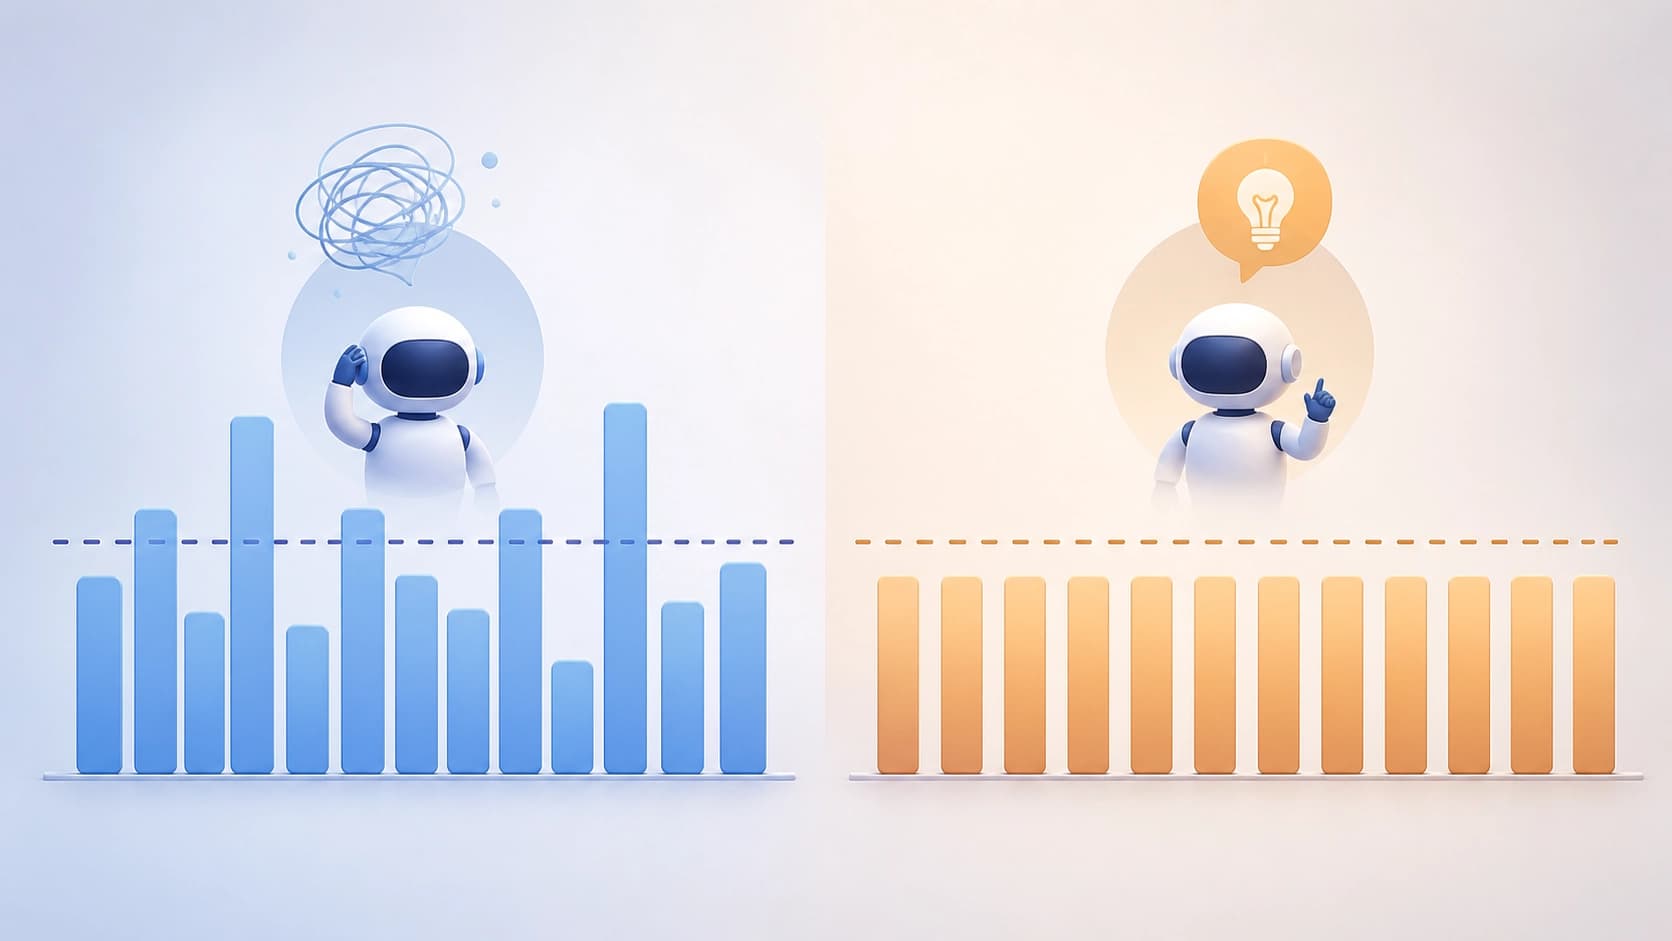
第二个观察:如果向智能体提供可用资源的信息,可预防的溢出数量会下降,而利用率会上升。这不是魔法,也不是什么新架构——只是上下文中不仅包含工具的描述,还包含必须满足的预算。
这里重要的是不要高估效果。重点在于,资源透明化是一种低成本且有效的干预手段,而不是说它能彻底解决问题:智能体仍然必须合理地运用这些信息。
适合谁使用
这个基准测试被设计为诊断智能体资源感知行为的试验台,这也是它的主要用途。它与其说是给出一个最终分数,不如说是显示模型究竟在哪里断裂:是在理解依赖关系上,还是在开销纪律上。
由此衍生出几种使用场景。对于智能体框架开发者——这是一种在投产前而非事故后检验调度器的方法。对于研究者——一个可复现的实验设置,用于在上下文中进行预算相关实验。对于需要为有严格限制的任务挑选模型的人——有机会看到模型之间的差异,而普通的成功率测试根本不会显示这些差异。
需要牢记的事项
这种方法有明显的入门成本:资源画像需要测量,依赖关系需要标注。在真实系统中,限制会有波动,外部服务在负载下会改变行为,而调用的成本并不总是事先已知。这里的实验室严谨程度高于实战,不应将结论原封不动地搬到生产环境。
但即便没有这个基准测试,这个框架本身也是有用的。两个问题——“智能体是否正确理解了什么依赖什么”以及“它是否控制在了预算之内”——值得对任何智能体系统提出,哪怕手头没有现成的试验台来检验它们。