点积作为瓶颈
几乎所有现代注意力架构的构造都如出一辙:查询和键通过点积(或其归一化版本)进行匹配,结果转化为权重,输出则作为值的加权和来汇集。这一手法具有普适性,但它也有代价——在这种方案中,特征空间的几何结构被硬性规定:相似度是"按直线"来度量的,没有考虑到空间中不同方向可能具有不同的重要性和不同的尺度。
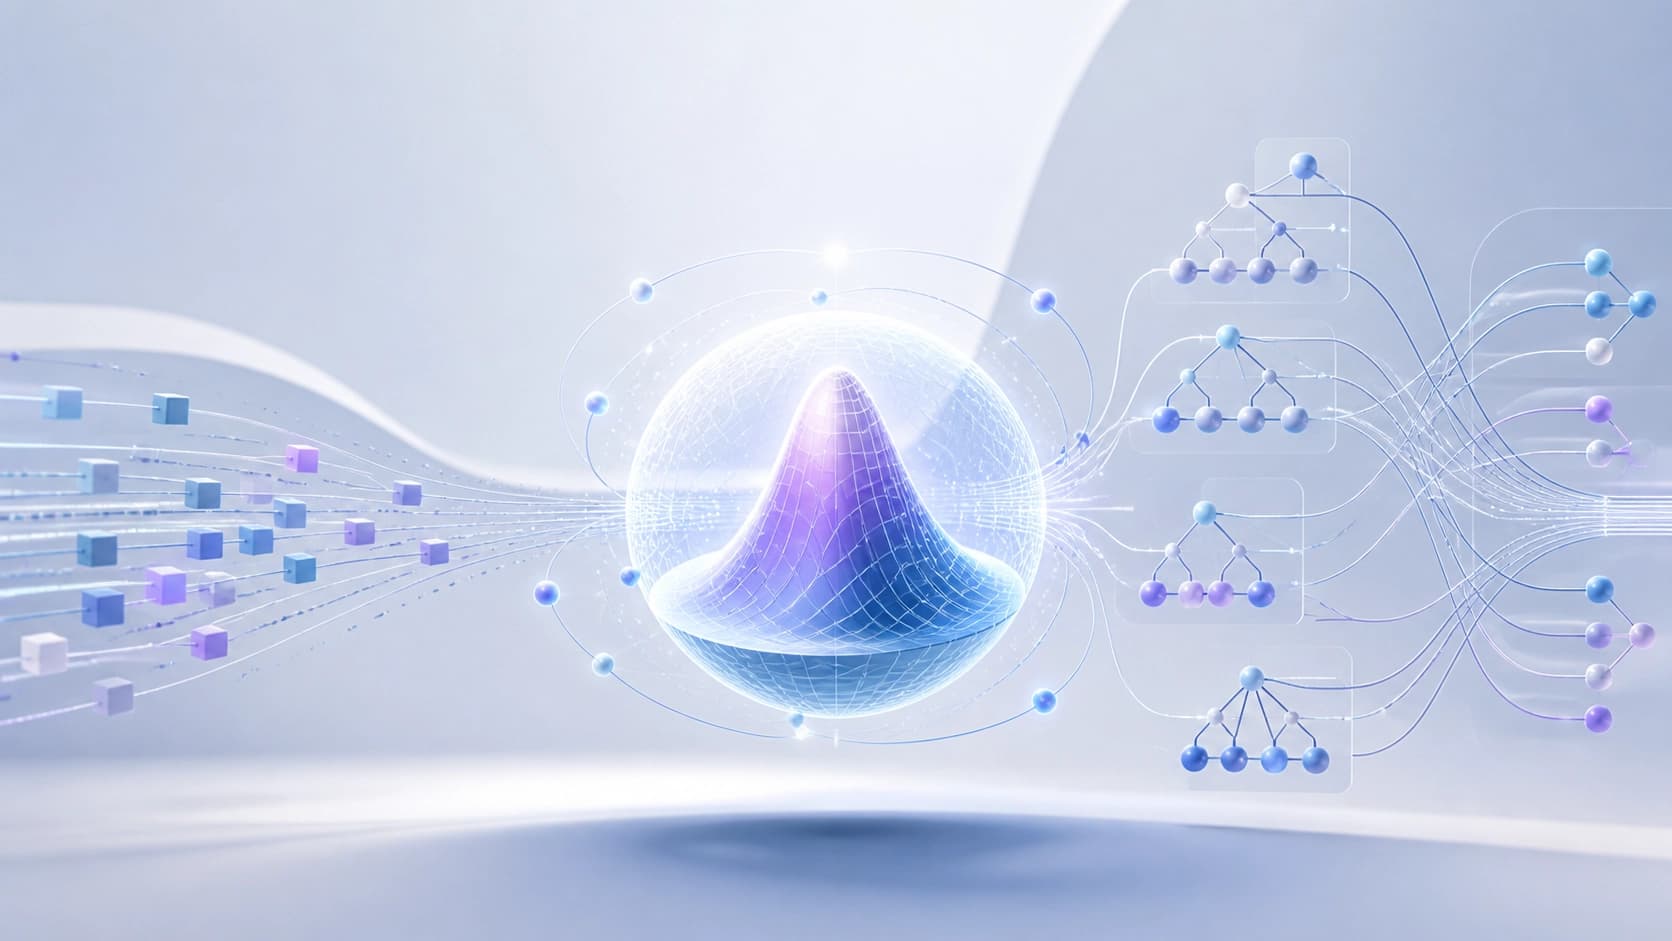
arXiv:2608.24462《Mahalanobis-Based Multi-Head Attention for Complex State Propagation》(作者——Xiaohe Li;cs.AI 板块)正是针对这一局限展开的工作。它用基于马哈拉诺比斯距离构建的 RBF 核取代了惯用的点积。简而言之,序列元素之间的相似度不是"直来直去"地计算,而是根据数据的协方差结构加以修正——就好像在比较之前,把空间稍稍拉伸并旋转,使相关的方向不再被视为相互独立。
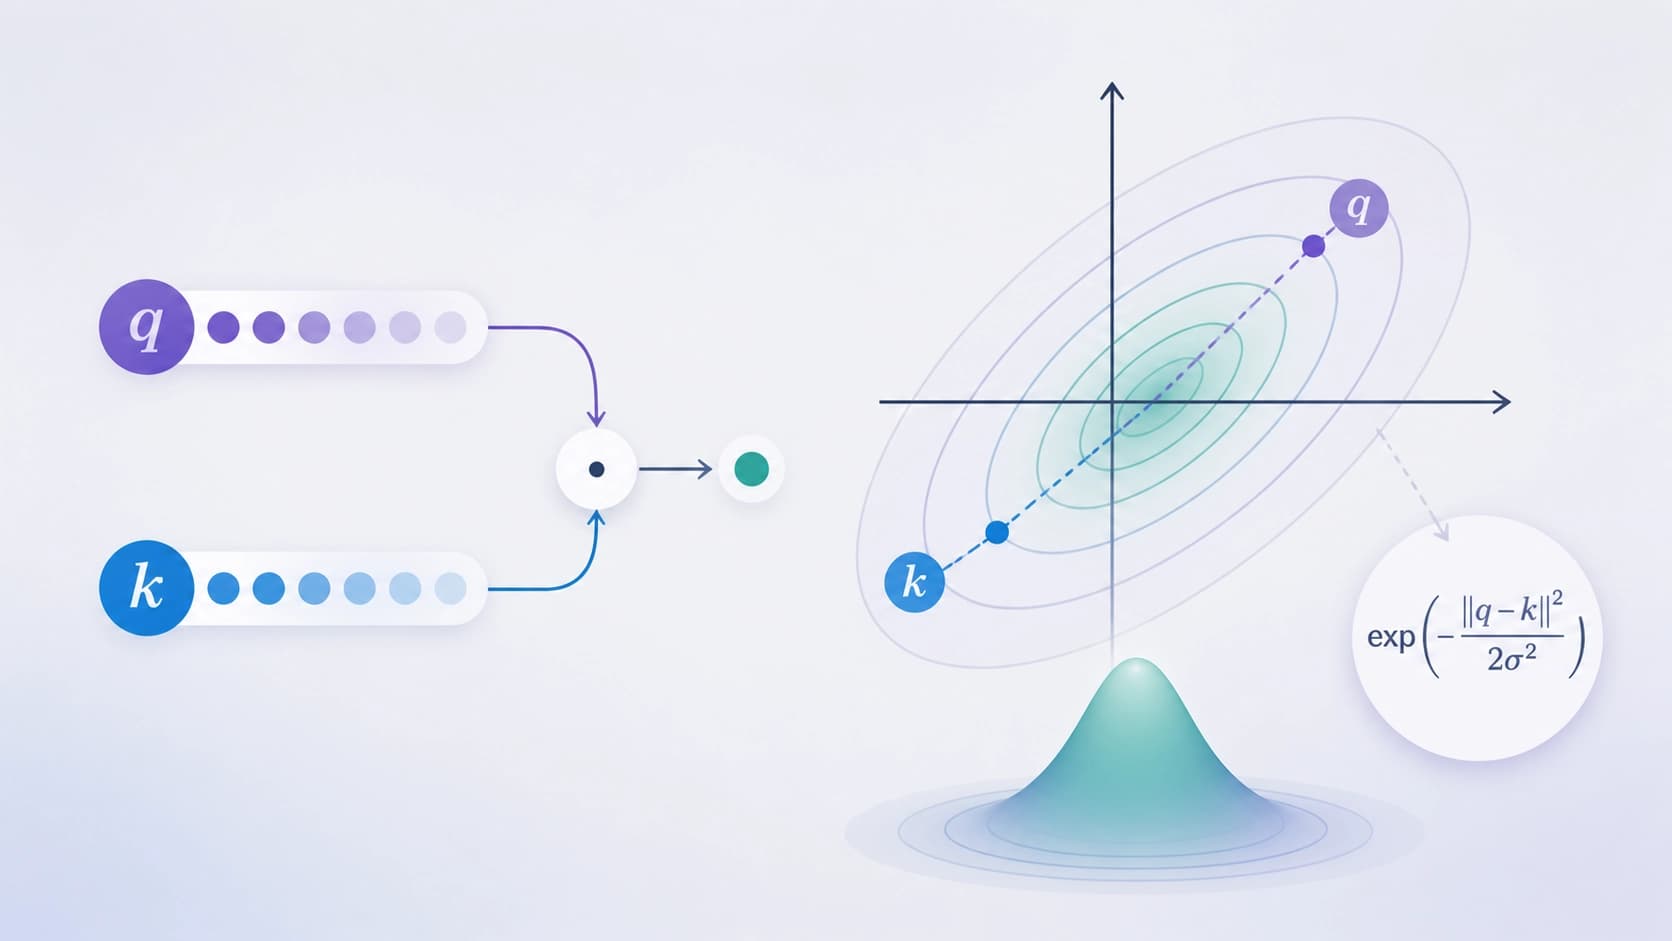
马哈拉诺比斯距离带来了什么
在无穷维空间中注意力无需增加参数量
作者的核心论断是:基于马哈拉诺比斯距离的 RBF 核,使得注意力的计算仿佛发生在无穷维特征空间中,但可训练参数的数量却不随之增长。这并非魔法,而是核本身就已经定义了非线性映射的结果——无需单独的特征展开层。对实践而言,这意味着对内存和优化的要求更为克制,在巨型模型的时代这几乎显得有些挑衅。
正定性与 Tree Attention
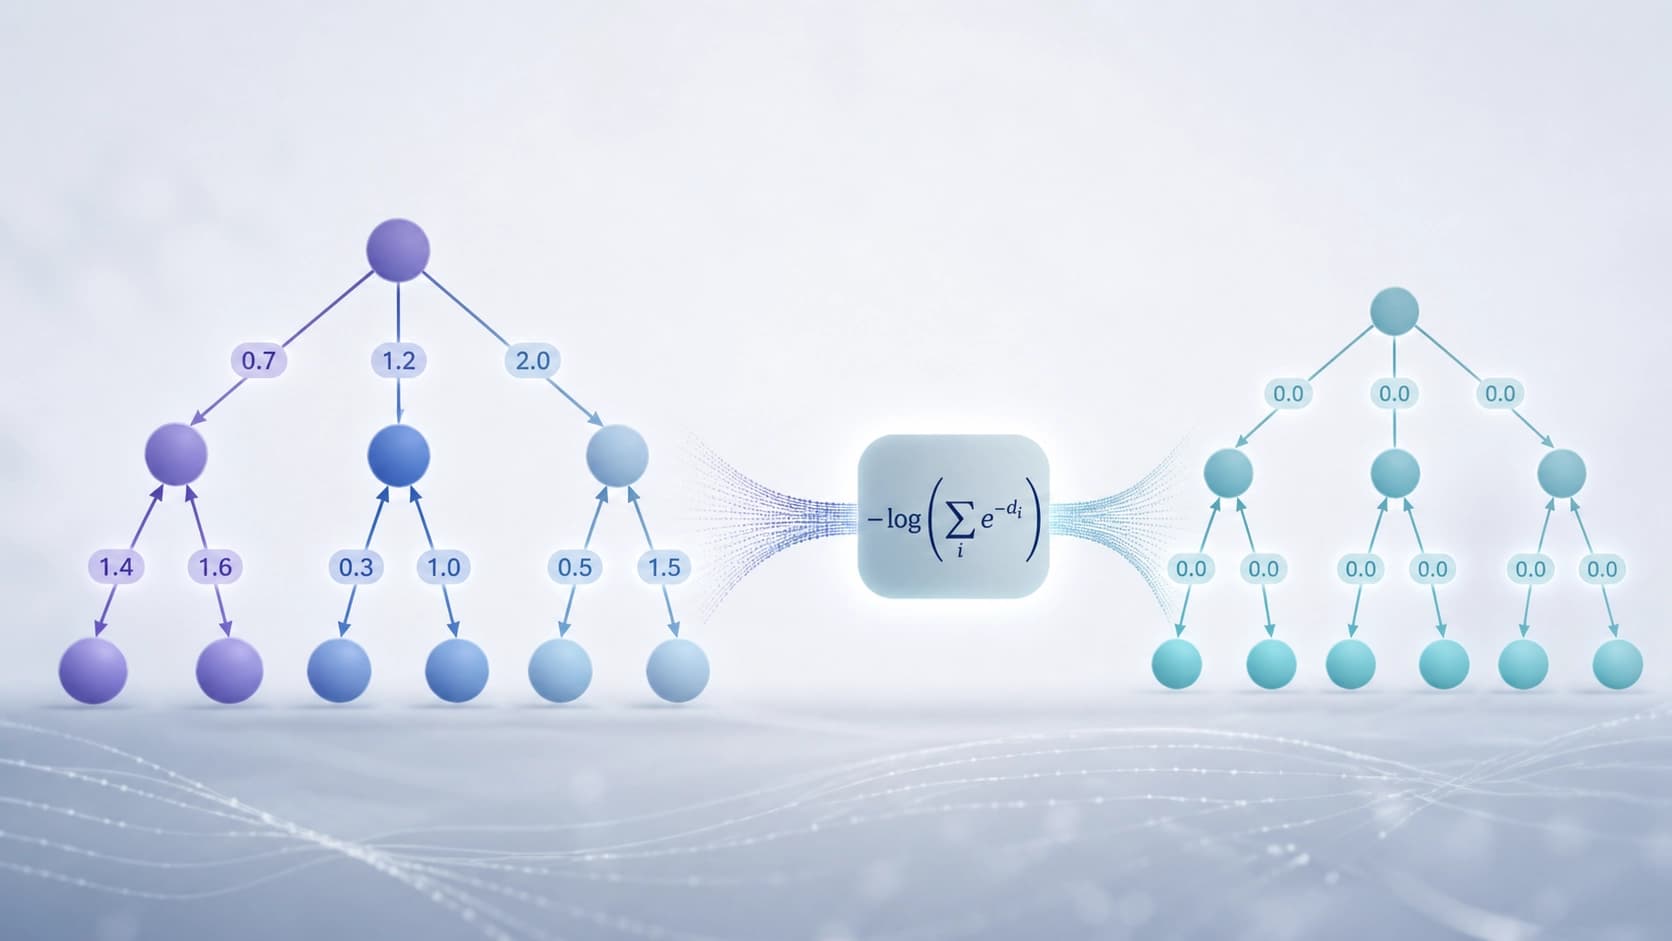
这一思想的第二层依托于马哈拉诺比斯距离的一个数学性质:它是正定的。由此可以直接构建论文中所称的 Tree Attention——注意力得分不是由"原始"相似度构造,而是由沿树累积的距离构造。为了让这种累积在数值上不发散,采用了通过 LogSumExp 的校正:从距离中减去各边指数之和的对数。实质上,这是一种协调树中不同路径贡献、同时不丢失其相对权重的方法。
对于不熟悉细节的读者,有一个有用的类比:模型不是随意地把"相似度"加总,而是在深入结构的过程中对它们进行细致的归一化。这更接近记账,而非直觉——但正是这种细致,使推理能够在长长的依赖链上保持稳定。
Attention meshing:各个头开始相互对话
通常多头注意力被构造为一组近乎独立的专家:每个头各算各的,混合只在输出端通过线性投影发生。在 MHA-CSP 中,马哈拉诺比斯距离矩阵被重复利用——在此基础上构建了"attention meshing"机制,使不同头的核直接相互作用。作者声称有双重收益:既提高了精度,又使训练更高效,因为同样的计算工作不再重复。
实验:119K 参数对抗大型基线模型
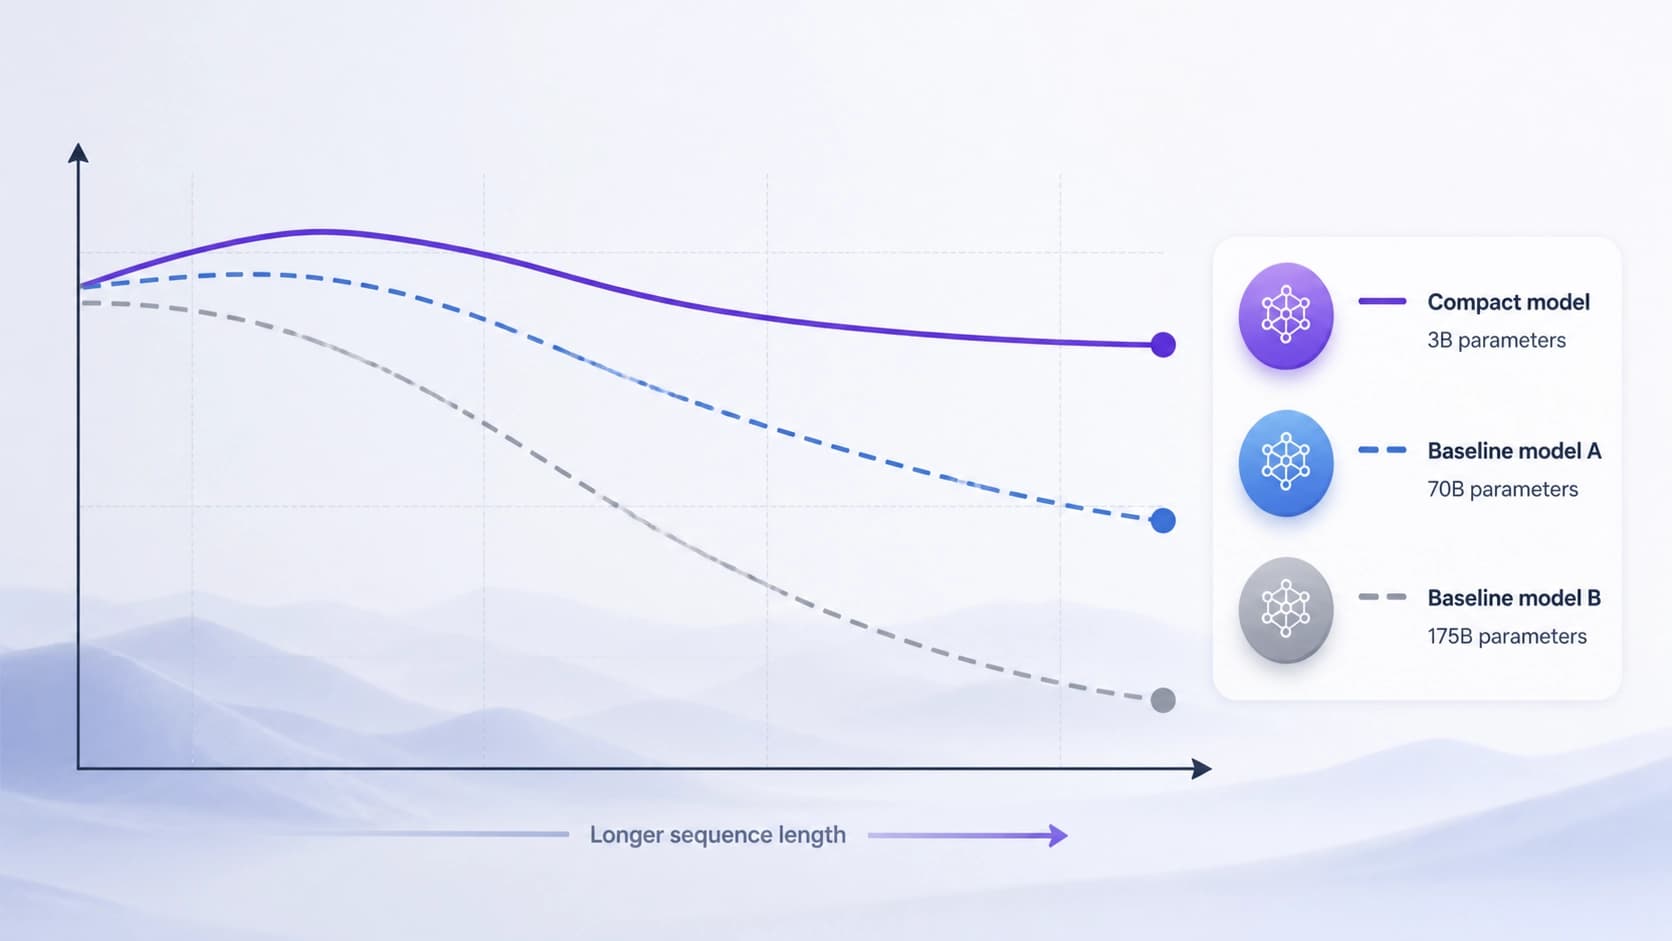
这项工作最引人注目的部分是对比。仅有 11.9 万参数的 MHA-CSP 与在相同条件下从零开始训练的基线 Transformer 和图卷积网络进行比较。任务是长序列上的状态跟踪。而且 teacher forcing 仅应用于最终的隐藏状态,也就是说,模型不像在训练中常见的那样在每一步都获得提示。
据作者称,MHA-CSP 稳定地超越了竞争对手。基线模型要么依赖稠密注意力(Transformer),要么依赖图上的信息传播(GCN),而 MHA-CSP 则凭借距离的合成校正以及继承自 CSP 主干的高效信息遍历,实现了结构化推理。
值得强调:这并不是说小模型在一切方面都"追平"了大模型。而是针对特定一类任务——具有内部符号结构的长序列,其中重要的不只是记住上下文,而是保持其状态。正是在这里,距离的几何结构和树状归一化开始发挥作用。
这在实践中改变了什么
这项工作的主要结论可以这样表述:复值状态传播(complex-valued state propagation)与联合多头校正相结合,成为捕捉符号结构的有效工具。并且为结构化推理任务在效率与质量之间设定了新的权衡。
从更广阔的视角看,这里可以追溯到近年来的一个趋势:研究者不是去增加参数,而是寻找更合适的归纳偏置——也就是把关于数据本质的正确假设植入架构之中。点积曾是一个方便但相当粗糙的假设。用带有协方差度量的核来取代它,是试图告诉模型:"空间中的方向并非生而平等,从一开始就把这一点考虑进去。"
来自外部的审慎视角
有理由不要急于重写整个流程。首先,结果是在一组特定的状态跟踪任务上取得的;在没有单独验证的情况下,不应将其推广到文本生成、多模态或对话场景——摘要中并没有这类实验。其次,单一作者和预印本的初版(v1,提交于 2026 年 8 月 25 日)意味着我们尚未看到独立复现:377 KB 的文件以 PDF、HTML 和 TeX 源码形式提供,但复现是另一回事。
尽管如此,这个方向看起来富有成效。摆脱点积、直接处理距离几何、在头之间复用计算——这些正是能够在不牺牲表达能力的前提下降低模型成本的举措。如果结果在其他领域得到证实,"小而构造得当"的网络将再添一个有力的论据。